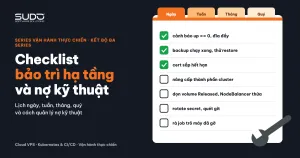
Nếu phải gói mọi bài học của ba series (Cloud VPS ba tầng, Kubernetes cho Website AI trên Linode, và các sự cố vận hành) vào một trang, chúng tôi chọn một checklist bảo trì hạ tầng. Phần lớn sự cố trong Series 3 không đến từ công nghệ khó, mà từ những việc nhỏ không ai làm đều đặn: job cron trỏ vào máy đã gỡ, database chết không có cảnh báo, thành phần cluster cài một lần rồi để đó. Bài kết này gồm hai phần: lịch bảo trì hạ tầng theo ngày, tuần, tháng, quý, có cách kiểm tra và bài liên quan cho từng việc; và cách quản lý nợ kỹ thuật, gồm những loại nợ hay gặp và thứ tự nên trả.
1. Vì sao bảo trì hạ tầng cần checklist
Đọc lại các bài sự cố, có ba kiểu lỗi bảo trì hạ tầng lặp lại:
- Âm thầm hỏng dần: job đỏ lẻ tẻ nhiều tháng rồi mới hỏng hẳn (bài Cron chạy vào máy đã gỡ và error.log MySQL phình to), đĩa đầy từ từ, tài nguyên rác tích tụ.
- Có số liệu nhưng không có người nhìn: Prometheus biết máy database chết từ phút đầu tiên (bài Database chết mà không ai biết).
- Cài một lần rồi để đó: ingress controller, cert-manager, metrics-server không được nâng cấp cho tới khi bản đang chạy hết hỗ trợ.
Cả ba đều không cần công cụ mới. Chúng cần một lịch bảo trì hạ tầng có người chịu trách nhiệm và có đầu ra kiểm chứng được. Mỗi dòng dưới đây có cách kiểm tra cụ thể và bài liên quan để đọc lại khi cần.
2. Bảo trì hạ tầng hằng ngày (10–15 phút)
Bảo trì hạ tầng hằng ngày chỉ nhằm một mục tiêu: không sự cố nào kéo dài qua đêm mà không ai biết.
| Việc | Cách kiểm tra | Bài liên quan |
|---|---|---|
| Đọc kênh cảnh báo: máy down, đĩa, MySQL, Redis | Không có cảnh báo nào đang firing quá 24 giờ mà chưa ai nhận | bộ cảnh báo Prometheus tối thiểu |
| Backup đêm qua | Mọi job backup xanh; dung lượng file không giảm bất thường so với hôm trước | backup database bằng rclone, backup cả cluster |
| Job cron fail liên tiếp | Job nào fail từ 3 lần liên tiếp trở lên | Jenkins control plane |
| Container restart, OOMKilled | kubectl get pods -A sắp theo số restart; so với hôm qua | OOMKilled và 503 |
| Tỷ lệ 5xx, 429, 499 theo balancer | Dashboard log nginx trên Loki | Fluent Bit đẩy log về Loki |
3. Bảo trì hạ tầng hằng tuần (1 giờ)
Bảo trì hạ tầng hằng tuần tìm những thứ đang xấu dần trước khi chúng thành sự cố.
| Việc | Cách kiểm tra | Bài liên quan |
|---|---|---|
| Chứng chỉ sắp hết hạn | openssl x509 -checkend 2592000 trên balancer; kubectl get certificate,order -A tìm cái không Ready | Certbot, cert-manager |
| Đĩa và log | Máy nào trên 80%; /var/log lớn nhất; error log nào tăng nhanh | error.log MySQL phình to |
| Top lỗi nginx và PHP-FPM | Đếm upstream timed out, no live upstreams, execution timed out | no live upstreams, PHP-FPM treo |
| WAF chặn nhầm | Rule nào chặn nhiều nhất trên một host hợp lệ | WAF chặn nhầm |
| Bot và crawler | User-Agent và IP chiếm nhiều request động nhất | rate limit theo User-Agent |
4. Bảo trì hạ tầng hằng tháng (nửa ngày)
Lúc kiểm chứng những điều mình vẫn tin là đúng: backup khôi phục được, không còn gì trỏ tới máy đã gỡ.
| Việc | Cách kiểm tra | Bài liên quan |
|---|---|---|
| Khôi phục thử một backup | Import một bản dump vào database tạm, mở thử site, ghi thời gian khôi phục | pipeline có rollback |
| Rà tham chiếu tới máy đã gỡ | grep tên máy trong config job Jenkins, rule Grafana, target Prometheus, /etc/hosts | cron xác sống |
| Dọn rác Kubernetes | PV Released, PVC không pod nào dùng, CertificateRequest và Order cũ, pod solver ACME treo | PersistentVolume và StorageClass |
| Request so với usage | kubectl top pods -A so với request; site nào lệch quá 2 lần | right-sizing Kubernetes |
| So cấu hình giữa các máy cùng vai trò | Balancer nào thiếu WAF, fail2ban, Fluent Bit; minion nào thiếu set_real_ip_from | nhìn lại mô hình Cloud VPS |
| Bản vá hệ điều hành | Gói cần cập nhật, máy cần reboot kernel; lên lịch theo nhóm, không reboot cả cụm một lúc | cloud image và cloud-init |
5. Bảo trì hạ tầng hằng quý (1–2 ngày)
Bảo trì hạ tầng hằng quý dành cho việc lớn, cần cửa sổ bảo trì và kế hoạch rollback.
| Việc | Cách kiểm tra | Bài liên quan |
|---|---|---|
| Nâng cấp thành phần cluster | So phiên bản ingress/gateway, cert-manager, metrics-server, kube-prometheus-stack với bản còn hỗ trợ; thử trên cluster test trước | pilot Gateway API và rollback, NGINX Gateway Fabric |
| Diễn tập cảnh báo | Tắt có kiểm soát một exporter trên máy test, đo thời gian tới khi có tin nhắn | kiểm thử bằng promtool |
| Rotate secret và rà quyền | Token CI, kubeconfig, mật khẩu database; ClusterRoleBinding cho ServiceAccount không còn tồn tại | kubeconfig lỡ commit |
| Rà cổng mở | Quét từ ngoài mạng: dịch vụ dữ liệu (3306, 6379, NFS) và trang quản trị chỉ nghe ở mạng cần thiết | bảo mật Nginx |
| Phiên bản hết hỗ trợ | PHP, MySQL, hệ điều hành, chart; lập lộ trình cho từng nhóm site | PHP 7.4 hết hỗ trợ |
6. Quản lý nợ kỹ thuật: phần bảo trì hạ tầng bị hoãn
Nợ kỹ thuật là những việc bảo trì hạ tầng đã biết là cần làm nhưng bị hoãn. Nó chỉ quản lý được khi được ghi ra. Mỗi mục trong sổ nợ nên có: mô tả, rủi ro nếu không trả, cách kiểm tra đã trả xong, người nhận và hạn chót. Mục liên quan an toàn thông tin ghi ở mức tóm tắt trong sổ chung, chi tiết để ở kênh riêng.
Những loại nợ hay gặp nhất, và cách phát hiện:
| Nhóm | Ví dụ | Cách phát hiện |
|---|---|---|
| Mất dữ liệu | Không binlog, không replica; backup file lớn lỗi multipart; JENKINS_HOME và NFS không có backup | Khôi phục thử; liệt kê mọi nơi có dữ liệu và đối chiếu với lịch backup |
| Không biết khi hỏng | Không Alertmanager; thiếu mysqld_exporter; Loki không có volume bền | Diễn tập: tắt thử một thành phần, xem có tin nhắn không |
| Đĩa sắp đầy | Database clone thử nghiệm, dump cũ, log không xoay | df -h, du -sh /var/lib/mysql/*, rule predict_linear |
| Bảo mật không đồng nhất | Balancer có WAF, balancer không; dữ liệu nhạy cảm trong ConfigMap thay vì Secret; LOG_LEVEL=debug trên production; quyền cluster-admin treo cho ServiceAccount đã xoá | So cấu hình giữa các máy cùng vai trò; kubectl get clusterrolebinding -o wide |
| Một điểm lỗi | Ingress controller một replica; website một replica, không PodDisruptionBudget; pool PHP-FPM chung còn sót | Diễn tập recycle một node, đếm site bị gián đoạn |
| Phiên bản cũ | Thành phần cluster ở revision đầu tiên từ lúc cài; image kéo từ registry cũ, chạy được chỉ nhờ cache trên node (xem thông báo chuyển sang registry.k8s.io) | helm list -A; liệt kê image theo registry |
| Rác và chi phí | Volume Released vẫn tính tiền; hàng trăm CertificateRequest cũ; CRD của công cụ đã thử rồi bỏ; PriorityClass của pod giữ chỗ đặt sai giá trị (bài PriorityClass và pod giữ chỗ) | kubectl get pv,certificaterequest,crd định kỳ |
| Vận hành ngoài Git | Job Jenkins không lấy định nghĩa từ Git; mysqld.cnf sửa tay | Thử trả lời: "cấu hình này đổi lần cuối khi nào, ai đổi?" |
7. Trả nợ bảo trì hạ tầng theo thứ tự nào
- Mất dữ liệu trước: backup cho mọi nơi có dữ liệu, sửa backup lỗi, khôi phục thử. Không có backup thì mọi việc khác đều vô nghĩa.
- Biết khi hỏng: cảnh báo
up == 0, đĩa, MySQL, Alertmanager và diễn tập. Đây thường là việc rẻ nhất trong danh sách. - Đĩa sắp đầy: dọn database clone, dump cũ, log không xoay. Đĩa đầy là sự cố có hẹn giờ.
- Bảo mật: thu hẹp cổng, chuyển cấu hình nhạy cảm sang Secret, gỡ quyền treo, đồng nhất WAF và fail2ban.
- Nâng cấp: lộ trình cho ingress controller, cert-manager, metrics-server, MySQL và PHP hết hỗ trợ.
- Dọn rác và tối ưu chi phí: volume Released, CRD, CertificateRequest, right-sizing.
Thứ tự này ưu tiên rủi ro không đảo ngược được (mất dữ liệu, lộ dữ liệu) trước rủi ro có thể sửa sau (chậm, tốn tiền). Rà sổ nợ trong buổi bảo trì hạ tầng hằng tháng: mục nào quá hạn thì hoặc làm ngay, hoặc ghi rõ lý do hoãn và hạn mới. Mục không có người nhận sẽ nằm nguyên trong sổ ở lần rà sau.
8. Nhìn lại ba series
- Series 1 dựng mô hình Balancer – Minion – Database: rẻ, dễ hiểu, đủ cho hàng trăm website PHP, nhưng mỗi site chỉ sống trên một máy.
- Series 2 đưa Website AI lên Kubernetes: Helm chart dùng chung, pipeline vận hành trên GitLab CI, và hành trình chia tay ingress-nginx.
- Series 3 kể lại sự cố: từ phương pháp điều tra nhiều tầng tới deadlock, OOM, cache rò session, hypervisor và Cloudflare.
Điểm chung của cả ba: hạ tầng không hỏng vì một quyết định sai lớn, mà vì nhiều việc bảo trì hạ tầng nhỏ bị hoãn. Checklist này là cách đưa những việc đó trở lại lịch làm việc hằng tuần.
Kết series
Bảo trì hạ tầng không có điểm kết thúc, nhưng series thì có. Đây là bài cuối của Series 3 và của cả bộ ba series về hạ tầng Sudo. Cảm ơn bạn đã đọc tới đây. Toàn bộ bài viết được lưu tại chuyên mục DevOps của Sudo; nếu checklist bảo trì hạ tầng này giúp hệ thống của bạn bớt một sự cố, nó đã làm đúng việc của nó.