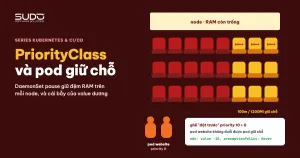
Khi xếp website ngày càng chặt trên mỗi node Kubernetes, bạn sẽ cần một khoảng đệm tài nguyên: chỗ trống để một site phình RAM đột ngột không đẩy cả node vào áp lực bộ nhớ, hoặc chỗ trống để pod mới lên ngay mà không phải chờ thêm node. Cách làm phổ biến là chạy "pod giữ chỗ" bằng image pause kèm một PriorityClass riêng. Bài này giải thích PriorityClass và preemption hoạt động thế nào, cách thiết kế pod giữ chỗ, và cái bẫy hay gặp nhất: đặt value dương khiến pod giữ chỗ không bao giờ nhường chỗ như bạn tưởng.
1. Khi nào cần pod giữ chỗ
Về nền tảng của request, limit và QoS, xem lại bài Requests và limits, QoS và nodeAffinity: xếp pod lên đúng node. Điều cần nhớ: scheduler xếp pod theo request, còn kernel giết pod theo mức dùng thật. Khi bạn hạ limit để xếp nhiều site hơn trên một node, tổng limit dễ vượt xa RAM thật, và chỉ cần vài site cùng phình lên một lúc là node rơi vào áp lực bộ nhớ.
Pod giữ chỗ giải quyết hai nhu cầu khác nhau, và bạn phải chọn rõ mình cần cái nào:
- Đệm cứng: luôn để trống một phần RAM trên mỗi node, không pod nào lấy được.
- Chỗ trống co giãn (overprovisioning): giữ sẵn chỗ, nhưng pod thật cần thì đẩy pod giữ chỗ ra và chạy ngay.
Chọn cách nào quyết định con số bạn đặt cho PriorityClass.
2. PriorityClass là gì và preemption hoạt động thế nào
PriorityClass là object cấp cluster, gán cho pod một con số ưu tiên. Pod tham chiếu tới nó qua trường priorityClassName. Theo tài liệu Pod Priority and Preemption, con số này được dùng ở hai chỗ:
- Thứ tự xếp lịch: pod có priority cao hơn được scheduler xét trước trong hàng đợi.
- Preemption: khi một pod không còn node nào đủ chỗ, scheduler tìm node mà nếu đẩy (evict) một số pod có priority thấp hơn thì pod mới vừa. Chỉ pod thấp hơn mới bị chọn làm "nạn nhân". Pod bằng hoặc cao hơn thì không bao giờ.
Pod không khai priorityClassName có priority 0, trừ khi cluster có một PriorityClass đặt globalDefault: true. Phần lớn chart ứng dụng không khai trường này, nên pod ứng dụng thường có priority 0. Ngoài ra cluster luôn có hai PriorityClass hệ thống: system-cluster-critical (2000000000) và system-node-critical (2000001000), dành cho CoreDNS, CNI và các thành phần tương tự.
Mỗi PriorityClass còn có preemptionPolicy. Mặc định là PreemptLowerPriority: pod thuộc lớp này được quyền đẩy pod thấp hơn. Đặt Never thì pod chỉ chờ trong hàng đợi, không đẩy ai.
Kiểm tra priority thực tế của pod đang chạy trước khi đặt bất kỳ con số nào:
kubectl get priorityclass
kubectl get pods -A -o custom-columns=NS:.metadata.namespace,NAME:.metadata.name,PRIO:.spec.priority
3. Thiết kế pod giữ chỗ bằng DaemonSet pause
Mẫu dưới đây giữ chỗ trên mọi node của một node pool web. Trên LKE, nhãn pool là lke.linode.com/pool-id. Trên nền tảng khác, thay bằng nhãn node pool tương ứng hoặc nhãn bạn tự gắn.
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: reserve-placeholder
value: -10                    # thấp hơn priority 0 của pod ứng dụng
preemptionPolicy: Never       # pod giữ chỗ không bao giờ đẩy pod khác
globalDefault: false
description: "Placeholder: app pods (priority 0) preempt it when a node is full."
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: reserve-resource
  namespace: kube-system
spec:
  selector:
    matchLabels:
      app: reserve-resource
  template:
    metadata:
      labels:
        app: reserve-resource
    spec:
      nodeSelector:
        lke.linode.com/pool-id: "<pool-web>"
      priorityClassName: reserve-placeholder
      containers:
        - name: pause
          image: registry.k8s.io/pause:3.9
          resources:
            requests: { memory: 1200Mi, cpu: 100m }
            limits:   { memory: 1200Mi, cpu: 100m }
Cách mẫu này hoạt động:
- DaemonSet đặt đúng một pod trên mỗi node của pool. Thêm node thì node mới tự có pod giữ chỗ.
- Image
pausegần như không tiêu tài nguyên, nhưng request1200Mikhiến scheduler coi phần đó đã bị chiếm. Ví dụ trên node 8 GB, đó là khoảng 15% allocatable. - Vì pod pause không thật sự dùng phần RAM đó, nó vẫn trống về mặt vật lý. Site phình vượt request (vẫn dưới limit) có chỗ để phình.
- PriorityClass value âm cho phép pod ứng dụng mới đẩy pod pause khi node hết chỗ.
Request bằng limit nên pod pause thuộc QoS Guaranteed. Cẩn thận với tolerations: operator: Exists: nó cho pod chịu mọi taint, kể cả taint áp lực tài nguyên mà node tự gắn. Chỉ thêm toleration bạn thật sự cần.
4. Cái bẫy: PriorityClass value dương
Lỗi hay gặp nhất là đặt tên lớp kiểu reserve-low, viết description: "Low priority so it is evicted first", nhưng lại đặt value: 10. Ai đọc file cũng thấy chữ "low" và mặc nhiên coi 10 là thấp. Trong Kubernetes, thấp hay cao chỉ có nghĩa khi so với pod khác. So với priority 0 của pod ứng dụng, 10 là cao.
Hệ quả theo đúng cơ chế:
- Preemption không xảy ra. Pod ứng dụng chỉ đẩy được pod có priority thấp hơn nó. Khi pool hết chỗ theo request, pod mới nằm
PendingvớiInsufficient memory, scheduler báo không tìm được nạn nhân. Pod pause đứng yên. - Kubelet cũng không chọn nó trước. Theo Node-pressure Eviction, kubelet xét trước các pod đang dùng vượt request, sau đó mới tới priority. Pod pause dùng gần 0 trên request của nó, nên nằm cuối danh sách.
- OOM killer càng không. Pod
Guaranteedcóoom_score_adjthấp nhất trong các pod thường. Kernel giết site đang phình trước.
Kết quả là bạn có một khoản giữ chỗ cứng chứ không phải chỗ trống co giãn. Điều này không hẳn vô ích, vì phần RAM trống vẫn là đệm cho site phình đột ngột. Nhưng nó khác hẳn hành vi mà description hứa hẹn, và người vận hành sau sẽ đoán sai hành vi của cluster.
5. Sửa PriorityClass đã tạo
value của PriorityClass là trường bất biến. Muốn đổi từ dương sang âm:
- Xoá PriorityClass cũ rồi tạo lại với
valuemới (cùng tên hoặc tên mới). - Khởi động lại DaemonSet để pod được tạo lại:
kubectl -n kube-system rollout restart ds/reserve-resource. Pod đang chạy giữ nguyên priority đã gán lúc tạo. - Kiểm tra lại cột
PRIObằng lệnh ở mục 2.
preemptionPolicy: Never ngăn pod giữ chỗ, khi được DaemonSet tạo lại sau lúc bị đẩy, quay sang đẩy ngược pod khác. Nó sẽ nằm Pending cho tới khi node có chỗ. Một pod giữ chỗ Pending chính là tín hiệu nên cảnh báo: "node này đã ăn hết phần đệm, cần thêm node".
6. Hai cách dùng PriorityClass, hai mục tiêu
| PriorityClass value dương | PriorityClass value âm | |
|---|---|---|
| Bản chất | Giữ chỗ cứng, như tăng phần tài nguyên dành riêng của node | Chỗ trống co giãn, pod thật lấy được khi cần |
| Khi pool hết chỗ | Pod ứng dụng mới Pending | Pod ứng dụng mới đẩy pod pause và chạy ngay |
| Đệm cho site phình RAM | Luôn còn nguyên | Mất dần khi pod mới chiếm chỗ |
| Tín hiệu vận hành | Pod ứng dụng Pending (đã muộn) | Pod giữ chỗ Pending (báo sớm) |
Nếu mục tiêu thật là đệm cứng, cách chính thống là tham số --kube-reserved hoặc --system-reserved của kubelet. Trên cluster managed như LKE, node do nền tảng dựng và được thay mới mỗi lần recycle hay nâng cấp, nên sửa tay kubelet trên từng node không bền. Một DaemonSet pause với priority dương đạt cùng mục tiêu mà chỉ cần quyền kubectl apply. Cách đó chấp nhận được, miễn là tên và mô tả nói đúng điều nó làm.
7. Nới probe khi xếp pod chặt hơn
Xếp pod chặt thường đi kèm hạ limit, và pod chạy sát trần sẽ phản hồi chậm hơn lúc khởi động hoặc lúc bận. Liveness kiểm tra dày với timeout ngắn dễ coi pod đang bận là pod chết, rồi restart nó đúng lúc nó cần tài nguyên nhất. Ví dụ cấu hình nới hơn cho ứng dụng Laravel, dựa trên ba loại probe ở bài Helm chart với NFS PersistentVolume tĩnh, claimRef và ba loại probe:
startupProbe:   { httpGet: { path: /startup },   initialDelaySeconds: 15, periodSeconds: 10, timeoutSeconds: 5, failureThreshold: 12 }
livenessProbe:  { httpGet: { path: /liveness },  initialDelaySeconds: 30, periodSeconds: 30, timeoutSeconds: 5, failureThreshold: 3 }
readinessProbe: { httpGet: { path: /readiness }, initialDelaySeconds: 10, periodSeconds: 10, timeoutSeconds: 5, failureThreshold: 3 }
Startup probe như trên cho ứng dụng tối đa khoảng 135 giây (15 + 12 × 10) để khởi động xong trước khi liveness bắt đầu tính.
8. Checklist khi dùng PriorityClass cho pod giữ chỗ
- Liệt kê priority thực tế của pod đang chạy trước khi đặt
value. - Chọn rõ mục tiêu: đệm cứng (value dương hoặc kube-reserved) hay chỗ trống co giãn (value âm,
preemptionPolicy: Never). - Kiểm tra bằng hành vi, không bằng tên. Trên cluster test, tạo một Deployment priority 0 với request lớn hơn chỗ trống còn lại của node, rồi xem pod pause có bị đẩy không.
- Viết
descriptionđúng sự thật. Mô tả sai trong manifest còn tệ hơn không có. - Cảnh báo khi pod giữ chỗ Pending để biết sớm lúc cần thêm node.
- Đổi từng thứ một. Đổi pool, nới probe, hạ limit và thêm pod giữ chỗ cùng lúc thì khó biết cái nào có tác dụng. Ghi lại từng bước để còn lần lại được.
Khi chuyển nhiều website lên cluster như bài Migrate website lên Kubernetes: quy trình chuyển hàng loạt an toàn, mật độ pod trên mỗi node tăng nhanh, và đó là lúc nên tính tới pod giữ chỗ. Các bài khác của series nằm trong chuyên mục blog kỹ thuật của Sudo.
Bài tiếp theo
Dựng nhanh cluster Kubernetes cho dự án microservice. Dựng một cluster mới cho dự án microservice nhờ chart dùng chung và pipeline có sẵn, cùng những điểm cần rà lại khi tái sử dụng cấu hình từ cluster cũ.