Cách đơn giản nhất để gắn dữ liệu website vào pod là khai báo volume NFS thẳng trong Deployment: một dòng server, một dòng path, thế là xong. Cách đó chạy được, nhưng không có chỗ đặt tuỳ chọn mount, và không có đối tượng nào để liệt kê site nào nằm trên máy NFS nào. Tài liệu này hướng dẫn chuyển Helm chart sang mô hình mỗi site một PersistentVolume NFS tĩnh, khoá vào đúng PVC bằng claimRef, cách chọn mountOptions, cách chia việc khởi tạo giữa initContainer và postStart, thiết kế ba loại probe, và quy trình chuyển site đang chạy.
1. Website để gì trên NFS
Lấy ví dụ một website Laravel có image chứa code và một bản gốc của các thư mục public, themes, plugins, lang tại /var/code. Khi chạy, bốn thư mục đó được mount từ NFS, vì chúng chứa dữ liệu người dùng: ảnh upload, theme đã chỉnh, plugin đã cài. Pod bị xoá hay dời node, dữ liệu vẫn còn trên máy NFS, và nhiều pod của cùng site đọc chung một thư mục.
Khi số site tăng, dữ liệu thường được chia ra vài máy NFS. Mỗi site có một thư mục riêng trên một máy, tên thư mục suy ra từ domain (đổi dấu chấm thành gạch ngang) để dễ đoán và dễ backup.
2. Volume NFS inline: đơn giản nhưng thiếu
Khai báo inline trông như sau:
volumes:
- name: site-a-example-com-volume
  nfs:
    server: 10.0.0.31
    path: /data/site-a-example-com
    readOnly: false
Ba hạn chế lộ ra khi số site tăng:
- Không có
mountOptions: volume NFS inline không có trường này, nên phiên bản giao thức, kích thước đọc ghi, hành vi khi máy chủ không trả lời đều để client và server tự thương lượng. - Không có đối tượng để quản lý: muốn biết site nào nằm trên máy NFS nào phải đọc từng Deployment;
kubectl get pvkhông cho thấy gì. - Lưu trữ dính vào Deployment: đổi máy chủ là đổi pod template, chi tiết lưu trữ trộn lẫn vào phần chạy ứng dụng.
Một hướng khác là PVC ReadWriteOnce trên Block Storage kèm initContainer busybox tạo thư mục và chown. Hướng này không hợp với website cần nhiều pod trên nhiều node đọc cùng một thư mục, nên giữ NFS và chỉ đổi cách khai báo là hợp lý hơn.
3. PersistentVolume NFS tĩnh và claimRef
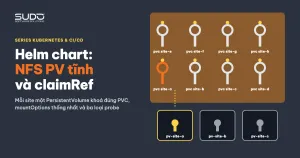
Kubernetes có hai cách cấp volume: dynamic, khi StorageClass tự tạo PV theo PVC, và static, khi quản trị viên tạo sẵn PV rồi PVC gắn vào (xem bài Volume, PersistentVolume, PVC và StorageClass trên Kubernetes). Với NFS, thư mục đã có sẵn trên máy chủ, nên static là lựa chọn tự nhiên. Chart sinh một PV cho mỗi site:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: {{ include "web.fullname" . }}-pv
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: ""
  nfs:
    path: {{ .Values.volumes.nfsSharedFolder }}/{{ include "web.fullname" . }}
    server: {{ .Values.volumes.nfsIp }}
  mountOptions:
    - vers=4.1
    - rsize=32768
    - wsize=32768
    - hard
    - timeo=600
    - retrans=2
  claimRef:
    namespace: {{ .Release.Namespace }}
    name: {{ include "web.fullname" . }}-pvc
Và một PVC trong namespace của site; Deployment chỉ còn tham chiếu tới PVC này:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: {{ include "web.fullname" . }}-pvc
spec:
  accessModes:
    - ReadWriteMany
  storageClassName: ""
  volumeName: {{ include "web.fullname" . }}-pv
  resources:
    requests:
      storage: 10Gi
claimRef làm gì
PV là tài nguyên cấp cluster, còn PVC nằm trong namespace. Không có claimRef, một PVC bất kỳ có yêu cầu phù hợp đều có thể "nhặt" PV của site khác, và site đó sẽ đọc ghi nhầm thư mục NFS của site kia. claimRef đặt trước tên và namespace của PVC duy nhất được phép gắn vào PV. Với hàng trăm PV cùng dung lượng, cùng access mode, đây là lớp bảo vệ bắt buộc. Ghi rõ storageClassName: "" ở cả PV và PVC để StorageClass mặc định của cluster không chen vào tạo một volume động khác; volumeName ở PVC khoá nốt chiều ngược lại.
Đọc hiểu mountOptions
| Tuỳ chọn | Ý nghĩa |
|---|---|
vers=4.1 | Ghim NFSv4.1, không để client tự hạ xuống v3 |
rsize=32768, wsize=32768 | Kích thước tối đa mỗi lần đọc, ghi (32 KB) |
hard | Máy chủ NFS không trả lời thì client thử lại mãi, tiến trình chờ chứ không nhận lỗi I/O. Tránh hỏng file, đổi lại pod có thể treo khi máy NFS gặp sự cố |
timeo=600 | Chờ 60 giây (đơn vị là phần mười giây) trước khi gửi lại yêu cầu |
retrans=2 | Số lần gửi lại trước khi ghi cảnh báo "server not responding" |
Dung lượng 10Gi chỉ để PV và PVC khớp nhau; NFS không giới hạn theo con số này. Đĩa của máy NFS mới là giới hạn thật, nên phải theo dõi riêng.
Một PVC, nhiều subPath
Mỗi site chỉ có một PVC, mount nhiều lần với subPath khác nhau: public, themes, plugins, lang. Cân nhắc không đặt storage/framework/sessions và storage/framework/cache trên NFS: bớt các thao tác ghi nhỏ lên NFS, đổi lại session dạng file mất khi pod khởi động lại. Tốt nhất là đưa session và cache sang Redis.
4. initContainer và postStart: chia lại việc khởi tạo
Lỗi điển hình: postStart copy code mới lên NFS song song với lúc PHP-FPM bắt đầu nhận request, nên request đầu tiên có thể đọc phải file chưa copy xong. Kubernetes không đảm bảo hook postStart chạy xong trước lệnh khởi động của container (xem tài liệu container lifecycle hooks). Nguyên tắc: thứ gì ứng dụng bắt buộc phải có trước khi chạy thì vào initContainer.
initContainers:
  - name: init-site
    command: ['sh', '-c', "cp -rf /var/code/plugins ./ &&
      php artisan migrate --force &&
      php artisan db:seed --force &&
      php artisan optimize:clear"]
containers:
  - lifecycle:
      postStart:
        exec:
          command: ['sh', '-c', 'cp -rf /var/code/public/assets ./public/;
            php artisan optimize:clear;
            sed -i "s|https://domain|$APP_URL|g" public/robots.txt;']
initContainer nối lệnh bằng &&: migrate lỗi thì pod không chạy, đúng ý đồ. postStart nối bằng dấu ;, vì hook trả lỗi sẽ khiến container bị kill và khởi động lại; copy asset lỗi một lần không đáng để giết cả pod. Việc chown không nằm trong pod: thư mục được đổi chủ ngay trên máy NFS lúc tạo site, như bài Chart dùng chung: tái sử dụng Helm cho Laravel, MySQL và Redis.
5. Ba loại probe
Ứng dụng nên có ba endpoint health riêng. Thông số dưới đây là ví dụ hợp lý cho website Laravel (cách cấu hình chi tiết xem hướng dẫn probe của Kubernetes):
| Probe | Endpoint kiểm tra gì | Thông số ví dụ | Fail thì sao |
|---|---|---|---|
| startup | /startup: kết nối database và cache | chờ 10s, mỗi 5s, timeout 3s, ngưỡng 10 | Quá khoảng 60 giây chưa đạt thì kubelet restart container. Trong lúc chờ, hai probe kia chưa chạy |
| readiness | /readiness: database và cache, lỗi trả 503 | chờ 5s, mỗi 15s, timeout 6s, ngưỡng 5 | Pod bị rút khỏi Service, không nhận traffic, nhưng không bị restart |
| liveness | /liveness: chỉ trả 200, không đụng database | chờ 10s, mỗi 10s, timeout 3s, ngưỡng 3 | Kubelet restart container |
Điểm thiết kế quan trọng nằm ở liveness: nó không kiểm tra database. Nếu database chậm, readiness rút pod khỏi Service và chờ database hồi lại. Nếu liveness cũng kiểm tra database, kubelet sẽ restart hàng loạt pod đúng lúc database đang khó khăn, biến sự cố nhỏ thành sự cố lớn. Liveness chỉ trả lời câu hỏi "PHP-FPM và nginx trong container còn sống không". Ghim pod vào node pool bằng nhãn lke.linode.com/pool-id trong values, như bài Requests và limits, QoS và nodeAffinity: xếp pod lên đúng node.
6. Chuyển site đang chạy sang PV NFS tĩnh
Chuyển thử một site trước, sau đó chuyển theo lô vào giờ thấp điểm. Quy trình cho mỗi site:
- Kiểm tra values có đúng
nfsIpvànfsSharedFoldercủa thư mục hiện tại. PV mới phải trỏ vào đúng thư mục cũ, nếu không site sẽ mở ra với thư mục rỗng. helm upgradevới chart mới. Helm tạo PV, PVC, rồi Deployment đổi từ volume inline sang PVC và rolling update.- Kiểm tra
kubectl get pv,pvc: PV phải ở trạng tháiBoundvới đúng PVC của namespace site. - Mở website, thử upload một ảnh để chắc chắn quyền ghi trên NFS vẫn đúng.
Ba điều cần nhớ khi vận hành PV tĩnh:
- Phần nguồn của PV (máy chủ, đường dẫn NFS) không sửa được sau khi tạo. Chuyển site sang máy NFS khác nghĩa là xoá PV cũ và tạo PV mới.
- PV là tài nguyên cấp cluster: xoá namespace của site không xoá PV, nên quy trình gỡ site phải xoá PV tường minh.
- Thêm annotation checksum cho ConfigMap và Secret vào pod template; nếu chưa có, đổi biến môi trường xong phải
kubectl rollout restart.
7. Đánh đổi của PV NFS tĩnh
| Được | Mất |
|---|---|
| Tuỳ chọn mount NFS thống nhất cho mọi site | Thêm hai đối tượng (PV, PVC) cho mỗi site phải quản lý |
kubectl get pv cho biết ngay site nào nằm trên máy NFS nào | Phần nguồn của PV bất biến, đổi máy NFS phải tạo lại PV |
claimRef chặn site gắn nhầm thư mục của site khác | PV cấp cluster không tự mất theo namespace |
| Probe tách bạch: chậm thì rút traffic, chết mới restart | Readiness và startup phụ thuộc database, database chậm thì site mới khó lên |
NFS vẫn là điểm phụ thuộc chung của mọi site, và tuỳ chọn hard nghĩa là máy NFS treo thì pod chờ theo. PV tĩnh không xoá được rủi ro đó, nhưng giúp nó hiện ra trong kubectl get pv thay vì nằm rải rác trong hàng trăm Deployment. Lý do nên đưa database ra khỏi cluster có ở bài MySQL trong Kubernetes hay ngoài cluster: vì sao đưa database ra VPS.
Bài tiếp theo
Migrate website lên Kubernetes: quy trình chuyển hàng loạt an toàn. Quy trình chuyển website từ VPS lên cluster, đổi DNS, kiểm tra và đường lui khi có sự cố.