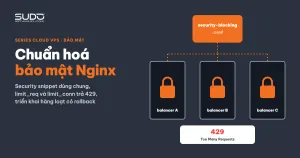
Bài về fail2ban và limit_req đã giới hạn request động theo từng IP. Cách đó hiệu quả với một client hung hăng, nhưng bó tay trước một kiểu traffic khác: crawler rải request qua hàng trăm IP, mỗi IP chỉ vài request, và công cụ cào dữ liệu đi qua Cloudflare nên balancer chỉ thấy IP của edge. Tài liệu này hướng dẫn thêm một lớp rate limit theo User-Agent trên balancer: phân loại bot tốt và bot xấu, gom cả một họ công cụ vào chung một bucket, không đụng tới Googlebot, và những lỗi dễ mắc khi làm việc này.
1. Vì sao rate limit theo IP là chưa đủ
Ở bài fail2ban và limit_req: chỉ giới hạn request động, key của limit_req_zone là IP client. Rate limit theo IP có ba điểm mù:
- Bot xoay IP: scraper thuê proxy dân cư, mỗi IP gửi vài request rồi đổi. Không IP nào chạm ngưỡng, nhưng tổng lượng request đổ về minion vẫn rất lớn.
- Site đứng sau Cloudflare: nếu balancer chưa khôi phục IP thật, mọi request trông như đến từ vài chục IP của Cloudflare. Rate limit theo IP lúc này hoặc chặn nhầm cả nghìn người dùng, hoặc không chặn được ai. Bài Lấy đúng IP thật của người dùng sau Cloudflare và balancer đã nói kỹ về chuyện này.
- Bot "lịch sự quá mức": một số bot tìm kiếm hợp pháp crawl rất dày. Chặn hẳn thì mất traffic tìm kiếm, để yên thì PHP-FPM cạn worker. Thứ chúng cần là một mức rate limit vừa phải.
Điểm chung của cả ba: chúng thường tự khai danh tính qua header User-Agent, hoặc để trống header này. Đó là chỗ để bám vào.
2. Bot tốt, bot xấu và bot cần làm chậm
Trước khi viết cấu hình, hãy chia User-Agent thành bốn nhóm để quyết định nhóm nào bị chặn, nhóm nào chỉ bị rate limit và nhóm nào được để yên:
| Nhóm | Ví dụ | Xử lý trên balancer |
|---|---|---|
| Bot tìm kiếm chính | Googlebot | Không giới hạn theo UA, không chặn |
| Bot hợp pháp nhưng crawl dày | bingbot, coccocbot | Giữ lại, nhưng cho vào bucket rate limit riêng |
| Crawler SEO, crawler AI, scraper khai tên | AhrefsBot, SemrushBot, Bytespider, PetalBot, DotBot, MJ12bot… | Trả 403 ngay trong security snippet |
| Công cụ và thư viện HTTP, UA rỗng | curl, wget, python-requests, Go-http-client, HeadlessChrome… | Rate limit chung cho cả họ, mọi IP cộng dồn |
Link preview của mạng xã hội (facebookexternalhit, Zalo, WhatsApp) không nên nằm trong nhóm nào, để người dùng chia sẻ link vẫn thấy ảnh và tiêu đề. robots.txt nên được cập nhật để chặn crawler AI, nhưng nó chỉ có tác dụng với bot tự giác tuân thủ. Lớp nginx mới là lớp ép buộc.
3. Cách 1: phân zone theo nhóm User-Agent, key vẫn là IP
Cách đơn giản nhất là dùng map phân UA thành vài nhóm, mỗi nhóm một zone với hạn mức theo IP, bỏ qua file tĩnh và IP nội bộ. Ví dụ ngưỡng khởi điểm:
| Nhóm | Zone | Rate / burst |
|---|---|---|
| Trình duyệt | limit_user | 30 r/s, burst 50 nodelay |
| Bot tìm kiếm | limit_bot | 15 r/s, burst 30 nodelay |
| Scraper, công cụ, UA rỗng | limit_scraper | 2 r/s, burst 5 nodelay |
Kiểm thử rate limit bằng request song song: mười request đồng thời với UA python-requests thì một phần phải nhận 429, UA trình duyệt thì tất cả 200.
Cách này có hai điểm yếu. Thứ nhất, key vẫn là IP, nên scraper xoay IP thì mỗi IP vẫn được 2 r/s, nhân với vài trăm IP là thành một con số lớn. Thứ hai, ba zone với ba ngưỡng khác nhau làm cấu hình khó đọc và khó chỉnh.
4. Cách 2: một bucket rate limit cho cả họ User-Agent
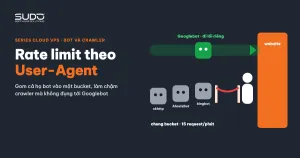
Ý tưởng là đổi key từ IP sang tên họ User-Agent. Mọi request mang UA curl/, dù đến từ bao nhiêu IP, đều rút từ chung một bucket. Scraper xoay IP không còn lợi thế gì. Phần khai báo trong khối http {} của nginx.conf:
# Tool / UA rỗng → một bucket cho cả họ, mọi IP cộng dồn.
# curl và python để rate limit, không chặn hẳn: healthcheck và script vận hành còn dùng.
map $http_user_agent $ua_limit_key {
    default                 "";
    ""                      "empty";
    ~*\bcurl/               "curl";
    ~*wget                  "wget";
    ~*python-requests       "python-requests";
    ~*python-urllib         "python-urllib";
    ~*aiohttp               "aiohttp";
    ~*scrapy                "scrapy";
    ~*go-http-client        "go-http";
    ~*okhttp                "okhttp";
    ~*Java/                 "java";
    ~*libwww                "libwww";
    ~*HeadlessChrome        "headless";
    ~*node-fetch            "node-fetch";
    ~*bingbot               "bingbot";
    ~*coccocbot             "coccocbot";
}

limit_req_zone $ua_limit_key zone=by_ua:10m rate=15r/m;
limit_req_status 429;
Chìa khoá nằm ở dòng default "". Theo tài liệu module ngx_http_limit_req của nginx, request có key rỗng không bị tính vào zone. Trình duyệt thật và Googlebot không khớp dòng nào trong map, nhận key rỗng, nên đi qua lớp này như không có nó. Chỉ những họ UA được liệt kê mới bị rate limit.
Phần áp dụng nên là một snippet riêng, include ở cuối security snippet. Nếu mọi file cấu hình site đều đã include security snippet, cả balancer được bảo vệ sau một lần reload mà không phải sửa từng site:
# /etc/nginx/snippets/rate-limit-by-agent.conf
limit_req zone=by_ua burst=20 nodelay;

# cuối /etc/nginx/snippets/security-blocking.conf
include snippets/rate-limit-by-agent.conf;
15r/m nghĩa là cả họ được trung bình một request mỗi 4 giây. burst=20 nodelay cho phép 20 request vượt mức được phục vụ ngay, để một lệnh curl kiểm tra tay hay vài lần healthcheck không bị chặn. Quá mức đó, nginx trả 429 ngay tại balancer, minion không tốn một worker nào.
Nhóm crawler khai tên vẫn bị chặn 403 bằng điều kiện if ($http_user_agent ~* (...)) trong security snippet. Nếu muốn tiết kiệm băng thông hơn, có thể trả mã 444 (nginx đóng kết nối, không gửi body).
5. Theo dõi hiệu quả sau khi bật
Sau khi bật, đếm từ log xem ai đang bị rate limit. Thường gặp nhất là bot crawl dày như bingbot; các họ công cụ chỉ thỉnh thoảng có một đợt dồn dập. Điều bắt buộc: Googlebot không dính 429 nào.
# số lần chạm zone by_ua trong error log
grep -c 'limiting requests.*zone "by_ua"' /var/log/nginx/*.error

# request 429 theo họ User-Agent trong access log (định dạng combined)
awk -F'"' '$3 ~ / 429 / {print $6}' /var/log/nginx/*.access \
  | grep -oiE 'bingbot|googlebot|curl|python-requests|okhttp|coccocbot' | sort | uniq -c
Nếu bot hợp pháp bị 429 với tỉ lệ lớn, tách cho nó một bucket rate limit riêng với ngưỡng cao hơn.
6. Không chặn nhầm Googlebot: kiểm tra UA giả bằng reverse DNS
User-Agent chỉ là một chuỗi do client tự khai. Scraper biết Googlebot được ưu ái nên hay giả UA của Googlebot. Cách kiểm tra mà Google hướng dẫn trong tài liệu xác minh Googlebot là tra DNS hai chiều:
# 1. Reverse DNS: IP → tên máy, phải thuộc googlebot.com, google.com hoặc googleusercontent.com
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

# 2. Forward DNS: tên máy → IP, phải trùng IP ban đầu
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Chỉ bước 1 thì chưa đủ, vì chủ một dải IP có thể tự đặt PTR là *.googlebot.com. Bước 2 mới xác nhận tên đó thật sự thuộc Google. Bingbot kiểm tra theo cùng nguyên tắc, với tên máy thuộc search.msn.com. Một đoạn script nhỏ để lọc IP tự xưng Googlebot trong access log:
grep -h "Googlebot" /var/log/nginx/*.access | awk '{print $1}' | sort -u | while read ip; do
  name=$(host "$ip" | awk '/pointer/ {print $5}')
  case "$name" in
    *.googlebot.com.|*.google.com.|*.googleusercontent.com.)
      host "$name" | grep -q "address $ip$" && continue ;;
  esac
  echo "UA Googlebot giả: $ip ($name)"
done
Hai lưu ý. Không tra DNS ngay trong nginx cho từng request, vì nó chậm và tạo phụ thuộc vào DNS. Hãy chạy kiểm tra ngoài luồng trên log, rồi đưa IP giả vào fail2ban hoặc danh sách chặn. Và nếu site đứng sau Cloudflare mà balancer chưa khôi phục IP thật, cột IP trong log toàn là IP của Cloudflare, reverse DNS không nói được gì. Phải xử lý IP thật trước rồi mới kiểm tra được.
7. Lỗi thường gặp khi rate limit theo User-Agent
- Regex quá rộng: các từ ngắn như
crawl,bothaydeveloperskhớp với nhiều UA hơn bạn nghĩ, kể cả công cụ của chính các bot tìm kiếm. Trước khi thêm một mẫu, hãy grep access log xem nó trúng những UA nào. - Key dùng chung cho mọi site: key
"bingbot"không có tên domain, nên mọi site trên balancer chia nhau 15 request mỗi phút. Một site bị crawl dày sẽ làm các site khác cũng bị chậm crawl. Nếu muốn tách, ghép thêm$hostvào key, ví dụ tạo key"$host:bingbot"bằng mộtmapthứ hai. - Ứng dụng di động dùng okhttp: okhttp phổ biến trên Android. Nếu site có app gọi API, đưa okhttp vào rate limit chung sẽ làm app lỗi. Loại trừ theo đường dẫn API hoặc header riêng của app.
- Tự chặn công cụ của mình: healthcheck, CI, script vận hành thường dùng curl. Với 15 r/m, một job gọi dồn dập sẽ ăn 429. Cho các IP nội bộ key rỗng bằng
geo, hoặc đặt UA riêng cho công cụ nội bộ. - Mất kế thừa
limit_req: nginx chỉ kế thừalimit_reqtừ cấp ngoài khi cấp hiện tại không khai báolimit_reqnào. Mộtlocationcólimit_req zone=dynamicriêng sẽ âm thầm bỏ quaby_uakhai ở cấpserver. Muốn áp cả hai thì khai cả hai dòng trong cùnglocation. - Error log phình to: mỗi lần chạm rate limit là một dòng
limiting requests. Cân nhắclimit_req_log_level warnvà kiểm tra logrotate.
8. Đánh đổi của rate limit theo User-Agent
Rate limit theo User-Agent rẻ, chỉ vài chục dòng cấu hình, chặn đúng nhóm traffic mà rate limit theo IP bỏ sót và không làm phiền người dùng thật. Giới hạn của nó:
- Nó chỉ bắt được bot thành thật về UA. Scraper giả UA trình duyệt sẽ đi qua, và phải dựa vào rate limit theo IP, WAF, hoặc các kỹ thuật như dấu vân tay TLS mà nginx gốc không có sẵn.
- Làm chậm bingbot là lựa chọn có chủ đích: ưu tiên tài nguyên minion hơn tốc độ crawl của Bing. Đổi lại, cần theo dõi báo cáo crawl trong công cụ quản trị của Bing để chắc các trang quan trọng vẫn được lập chỉ mục.
- Triển khai từng balancer một: bật với ngưỡng rộng, xem log 429 một thời gian rồi mới siết.
Bài tiếp theo
Chạy Octane bằng systemd: giới hạn bộ nhớ bằng cgroup. Vì sao một site Octane hết RAM có thể kéo sập mọi site khác trên cùng minion, và cách tách từng site ra một systemd service có MemoryMax riêng.