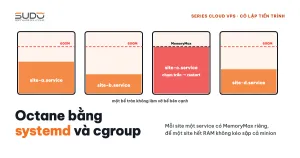
Laravel Octane giữ ứng dụng thường trú trong RAM, nên một site rò bộ nhớ sẽ phình dần cho tới khi kernel phải ra tay. Nếu mọi site Octane trên một minion cùng chạy dưới supervisor, mỗi lần như vậy không chỉ site đó chết: mọi site Octane khác trên máy cũng trả 502 theo. Tài liệu này giải thích vì sao chạy Octane dưới supervisor gây "chết chùm", cách tách mỗi site thành một service systemd riêng có giới hạn bộ nhớ bằng cgroup, cách chuyển đổi an toàn, và một giới hạn cần hiểu rõ: MemoryMax khoanh vùng được thiệt hại, nhưng không chữa được nguyên nhân gây hết RAM.
1. Tổng quan: nhiều site Octane trên một minion
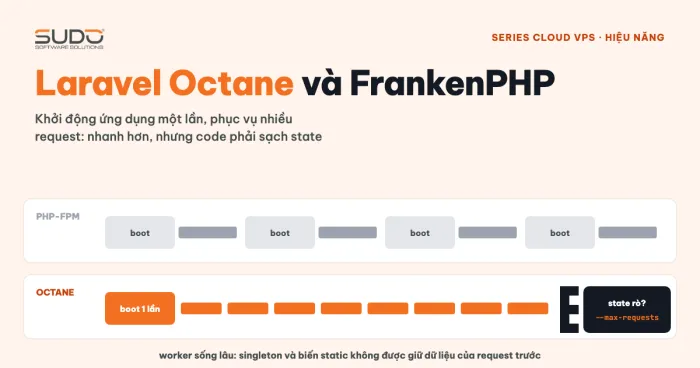
Bài Laravel Octane và FrankenPHP: chạy Laravel như một app server đã giải thích Octane khác PHP-FPM thế nào. Với PHP-FPM, mỗi request chạy xong là bộ nhớ được trả lại. Với Octane trên FrankenPHP, framework khởi động một lần rồi sống mãi trong tiến trình. Nhờ vậy nó nhanh, nhưng mọi rò rỉ bộ nhớ đều cộng dồn vào tiến trình đó.
Cách triển khai dễ nghĩ tới nhất là khai báo octane:start của mọi site trong file cấu hình supervisor, giống queue worker, và để cùng một daemon supervisor quản lý. Cách này chạy tốt cho tới lần OOM đầu tiên.
2. Vì sao một site hết RAM kéo sập mọi site Octane
Tình huống điển hình: một chiến dịch quảng cáo dội lượng lớn request vào một site, tiến trình FrankenPHP của site đó phình lên hơn 1 GB RAM, kernel kích hoạt OOM killer và giết nó. Ngay sau đó, toàn bộ site Octane trên máy cùng trả 502 gần một phút. Kernel log cho thấy rõ cơ chế:
oom-kill: ... global_oom, task_memcg=/system.slice/supervisor.service, task=frankenphp
Out of memory: Killed process ... (frankenphp) total-vm:2824304kB, anon-rss:1043720kB
systemd[1]: supervisor.service: A process of this unit has been killed by the OOM killer.
systemd[1]: supervisor.service: Failed with result 'oom-kill'.
Mọi tiến trình con của supervisor nằm chung một cgroup: supervisor.service. Với systemd, mặc định OOMPolicy=stop: khi kernel giết một tiến trình bất kỳ trong unit, systemd coi cả unit là thất bại và dừng toàn bộ. Unit supervisor của Debian lại có Restart=on-failure với RestartSec=50s. Kết quả: mọi site Octane, kể cả site không dùng nhiều RAM, cùng tắt rồi chờ gần một phút mới lên lại. Chạy tay systemctl restart supervisor lúc deploy cũng có phạm vi ảnh hưởng y hệt.
Thường đi kèm một lỗi phụ: sau lần OOM, một tiến trình frankenphp mồ côi (PPID=1) vẫn giữ cổng admin của site. Worker mới khởi động báo cổng đã bị chiếm, rơi vào FATAL, và site 502 thêm cho tới khi tiến trình cũ bị kill -KILL.
3. Cơ chế: systemd và cgroup, mỗi site một chiếc hộp riêng
Trên Debian 12, systemd 252 chạy với cgroup v2. Mỗi service systemd có cgroup riêng, và systemd đặt được giới hạn tài nguyên cho từng cgroup. Ý tưởng rất đơn giản: tách lớp HTTP của mỗi site Octane ra một unit octane-<domain>.service. Supervisor chỉ còn giữ queue worker.
Trước                                     Sau
supervisor.service (1 cgroup)             octane-site-a.service  MemoryMax=600M
 ├─ site-a octane  ← OOM                   octane-site-b.service  MemoryMax=600M
 ├─ site-b octane  ← chết lây              octane-site-c.service  MemoryMax=600M
 ├─ site-c octane  ← chết lây              ...
 └─ queue workers  ← chết lây              supervisor.service: chỉ còn queue:work
Hai thuộc tính bộ nhớ của cgroup v2 được dùng, theo tài liệu systemd.resource-control:
MemoryHigh=450M: ngưỡng mềm. Vượt ngưỡng, kernel đòi lại bộ nhớ của cgroup và làm chậm tiến trình, nhưng không giết.MemoryMax=600M: ngưỡng cứng. Vượt ngưỡng, OOM killer chạy bên trong cgroup đó, chỉ giết tiến trình của service đó.
Các con số trên là ví dụ cho site cỡ vừa. Hãy đo MemoryCurrent của từng site trong giờ cao điểm rồi đặt MemoryHigh cao hơn mức đó một chút.
4. File unit systemd mẫu cho một site Octane
# /etc/systemd/system/octane-example.com.service
[Unit]
Description=Laravel Octane FrankenPHP - example.com
After=network.target

[Service]
Type=simple
User=nginx
WorkingDirectory=/var/www/example.com

ExecStartPre=/bin/sh -c 'fuser -k -9 8001/tcp 9001/tcp 2>/dev/null || true'

ExecStart=/usr/bin/php8.4 artisan octane:start \
    --server=frankenphp \
    --host=127.0.0.1 \
    --port=8001 \
    --admin-port=9001 \
    --workers=1 \
    --max-requests=100

Restart=always
RestartSec=1s
KillMode=control-group
TimeoutStopSec=3s

StandardOutput=append:/var/www/example.com/octane.log
StandardError=append:/var/www/example.com/octane.log

MemoryHigh=450M
MemoryMax=600M

Environment=PATH=/usr/local/bin:/usr/local/sbin:/usr/bin:/bin
Environment=CADDY_ADMIN=127.0.0.1:9001
Environment=PHP_INI_SCAN_DIR="/etc/php/8.4/cli/conf.d:/var/www/example.com/php-ini"

[Install]
WantedBy=multi-user.target
Ý nghĩa từng dòng quan trọng:
ExecStartPrevớifuser -k: trước khi start, giết mọi tiến trình đang giữ cổng web và cổng admin Caddy của site, xử lý triệt để tiến trình mồ côi.KillMode=control-group: khi dừng service, systemd giết mọi tiến trình trong cgroup, kể cả tiến trình con FrankenPHP doartisansinh ra. Đây vốn là mặc định, nhưng nên ghi rõ để không ai vô tình đổi thànhprocess.Restart=always,RestartSec=1s: chết vì lý do gì cũng khởi động lại sau một giây, thay vì 50 giây như unit supervisor.--max-requests=100: Octane thay worker mới sau mỗi 100 request, rò rỉ nhỏ không có thời gian tích luỹ. Tham số này được mô tả trong tài liệu Laravel Octane.CADDY_ADMINvà--admin-port: mỗi instance FrankenPHP cần một cổng admin riêng. Hai site cùng dùng cổng mặc định 2019 thì site thứ hai không lên được.PHP_INI_SCAN_DIR: Octane chạy bằng PHP CLI nên không đọc cấu hình FPM. Mỗi site có thư mục ini riêng chomemory_limit,upload_max_filesize.
nginx trên minion không đổi: vẫn proxy_pass http://127.0.0.1:8001. Code mới được nạp bằng php artisan octane:reload, không cần restart service.
5. Chuyển đổi từ supervisor sang systemd có rollback
Hãy thử trên một minion test, chuyển tay một hai site, rồi mới đóng gói thành pipeline như trong bài Jenkins làm "control plane" cho hàng trăm website. Pipeline nhận tham số minion, domain, memory_high, memory_max, max_requests, workers, rồi làm sáu bước cho một domain:
- Đọc cổng web và cổng admin hiện tại từ cấu hình supervisor của site, giữ nguyên để không phải sửa nginx.
- Sinh file
/etc/systemd/system/octane-<domain>.servicetheo mẫu trên. - Dừng tiến trình Octane trong supervisor trước, để hai bên không tranh cổng.
- Xoá block
octane:startkhỏi cấu hình supervisor, giữ lạiqueue:work, rồisupervisorctl reread && supervisorctl update. systemctl daemon-reload && systemctl enable --now octane-<domain>.service.- Healthcheck: service phải
activevàcurl http://127.0.0.1:<port>/không trả 5xx, thử vài lần. Không đạt thì gỡ unit, khôi phục cấu hình supervisor từ backup và bật lại Octane trong supervisor.
6. Giới hạn: MemoryMax không chống được global OOM
Sau khi tách, một lần OOM điển hình trông như sau:
kernel: nginx invoked oom-killer
kernel: oom-kill: constraint=CONSTRAINT_NONE ... global_oom, task_memcg=/system.slice/octane-site-b.service, task=frankenphp
kernel: Out of memory: Killed process ... (frankenphp) ... anon-rss:59968kB
systemd[1]: octane-site-b.service: Failed with result 'oom-kill'.
systemd[1]: octane-site-b.service: Scheduled restart job, restart counter is at 2.
systemd[1]: Started octane-site-b.service - Laravel Octane FrankenPHP - site-b.
Phần tốt: chỉ đúng một unit bị dừng và nó lên lại sau vài giây. Các site Octane khác và toàn bộ queue worker không bị ảnh hưởng.
Phần cần hiểu nằm ở hai chữ global_oom và CONSTRAINT_NONE. Đây không phải trường hợp một site vượt MemoryMax của nó, mà là cả máy hết RAM, và kernel phải chọn một nạn nhân trên toàn hệ thống. Kernel chọn theo điểm oom_score, nên tiến trình bị giết có thể chỉ chiếm vài chục MB: nạn nhân không nhất thiết là thủ phạm.
Lý do dễ thấy khi cộng lại. Ví dụ máy 4 GB chạy tám unit, mỗi unit MemoryMax=600M: tổng giới hạn là 4,8 GB, chưa tính PHP-FPM, queue worker, nginx. Mỗi giới hạn riêng lẻ đều hợp lý, nhưng tổng vượt RAM thật thì chúng không bảo vệ được máy khỏi hết bộ nhớ.
7. Lỗi thường gặp khi chạy Octane bằng systemd
- Chạy trùng supervisor và systemd: site vừa có unit systemd vừa còn
autostart=truetrong supervisor thì hai bên giành cổng, crash loop mỗi giây, CPU tăng cao. Sau khi chuyển, luôn kiểm trasupervisorctl status | grep octane. - Đọc nhầm loại OOM: trong
journalctl -k | grep oom-kill,constraint=CONSTRAINT_MEMCGnghĩa là service chạmMemoryMaxcủa chính nó;CONSTRAINT_NONEkèmglobal_oomnghĩa là cả máy hết RAM. Hai trường hợp cần cách xử lý khác nhau. - Vướng giới hạn khởi động lại: mặc định systemd chỉ cho phép 5 lần start trong 10 giây. Site lỗi ngay khi khởi động (sai
.env, thiếu package) sẽ chạm giới hạn rồi nằm ở trạng tháifailed. Sửa lỗi rồisystemctl reset-failed. fuser -kgiết nhầm: lệnh này giết mọi thứ giữ cổng. Nếu hai site lỡ được cấp cùng cổng, site này start sẽ giết site kia. Bảng cấp cổng phải là duy nhất trên mỗi minion.- Code không hợp Octane: lưu dữ liệu theo request vào thuộc tính
static, gọiexit(),die(), hoặcArtisan::call('config:clear')ngay trong request (mỗi lần là nạp lại cả ứng dụng trong tiến trình sống cả ngày). cgroup không sửa được những lỗi này.
8. Checklist: systemd giới hạn ảnh hưởng, không chữa nguyên nhân
Chuyển Octane sang systemd là đúng và nên làm: thời gian khôi phục giảm từ gần một phút xuống vài giây, và một site gặp sự cố không còn kéo theo các site khác. Nhưng nó là vách ngăn chống cháy lan, không phải bình chữa cháy. Sau khi tách, hãy:
- Tính ngân sách bộ nhớ của minion: tổng
MemoryMaxcủa các unit, cộng PHP-FPM và queue worker, phải nằm dưới RAM thật. Site nhỏ dùng giới hạn nhỏ hơn. - Theo dõi
MemoryCurrentvàNRestartscủa từng unit (systemctl show octane-<domain> -p MemoryCurrent -p NRestarts) để biết site nào thực sự ngốn RAM, thay vì chỉ nhìn nạn nhân trong kernel log. - Sửa code của site rò bộ nhớ: bỏ
Artisan::callxoá cache trong request, dọn singleton và thuộc tínhstatic. - Áp cùng cách làm cho mọi site Octane, không để sót site nào dưới supervisor.
Tư duy này giống bài Mỗi website một PHP-FPM pool: chấm dứt lỗi max_children: tách để một site lỗi không kéo cả máy. Còn để không có site nào lỗi, vẫn phải sửa ở code và ở cách chia tài nguyên.
Bài tiếp theo
Nhìn lại mô hình Cloud VPS: điểm yếu và phương án gộp VPS. Bài kết series: những gì mô hình Balancer – Minion – Database làm tốt, các điểm lỗi đơn cần lưu ý, và cách lên phương án gộp bớt Cloud VPS.