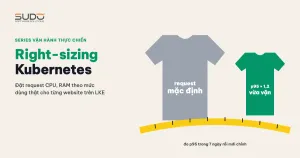
Một cụm Kubernetes chạy hàng trăm website thường đi tới tình trạng này sau một thời gian: trên giấy cụm gần đầy, scheduler thấy phần lớn RAM đã được đặt chỗ, có node gần chạm trần, trong khi tổng CPU các website thật sự dùng chỉ bằng một phần nhỏ số vCPU của cụm. Tài liệu này hướng dẫn quy trình right-sizing request CPU và RAM cho từng site: cách đo, công thức, cách tránh nhầm số khi nhiều báo cáo cho ra nhiều bộ số khác nhau, và giới hạn của việc chỉnh request. Right-sizing ở đây không phải cắt giảm cho rẻ, mà là đặt chỗ đúng với mức dùng. Ví dụ trong bài lấy từ cụm Website AI trên LKE (Linode Kubernetes Engine).
Kiến thức nền về requests, limits và QoS có trong bài Requests và limits, QoS và nodeAffinity: xếp pod lên đúng node. Ở đây chỉ nói về việc đo và chỉnh con số.
Khi nào cần right-sizing
- Cụm đầy trên giấy: phần Allocated resources của node cho thấy RAM request vượt xa mức an toàn, thêm site mới nghĩa là sắp phải thêm node.
- Dùng thật thấp hơn nhiều: Grafana cho thấy tổng CPU và RAM các pod website dùng chỉ bằng một phần nhỏ tổng request.
- Vài site ngược lại, dùng vượt request: cảnh báo vượt ngưỡng RAM request xuất hiện ở một số site, có site dùng CPU gấp mấy lần request.
- Limit bị overcommit: tổng limit trên node vượt xa tài nguyên thật của node.
Quy trình right-sizing
Bước 1: đừng vội tăng request cho site bị cảnh báo
Phản ứng tự nhiên trước cảnh báo là tăng RAM request cho các site đang dùng sát hoặc vượt mức đặt chỗ. Cách này đúng cho từng site, nhưng có thể đi ngược bức tranh chung: nếu cụm đã "đầy" request mà mức dùng thật chỉ khoảng một phần ba RAM của node, vấn đề không nằm ở vài site thiếu request, mà ở việc gần như mọi site đều đặt chỗ thừa. Khi đó cần right-sizing theo cả hai chiều: hạ mạnh cho đa số, nâng cho vài site đang thiếu.
Bước 2: đọc request từ góc nhìn scheduler
Scheduler chỉ nhìn request, không nhìn mức dùng. Con số nó thấy nằm ở phần Allocated resources của từng node:
kubectl describe nodes | grep -A 8 "Allocated resources"
kubectl top nodes
kubectl top pods -A --sort-by=cpu | head -20
Con số ở mức node gồm cả pod hệ thống và DaemonSet giữ chỗ. Một DaemonSet giữ chỗ đặt RAM quá lớn trên mỗi node sẽ làm cụm trông đầy hơn thực tế rất nhiều. Cơ chế của pod giữ chỗ có trong bài PriorityClass và pod giữ chỗ: dự phòng tài nguyên cho cluster. Kiểm tra phần này trước khi đụng tới request của website.
Bước 3: so request với mức dùng thật
Mức dùng thật lấy từ CPU usage và memory working set của từng pod trên Prometheus/Grafana, stack giám sát trong bài kube-prometheus-stack: thay monitoring cũ và cấu hình sai âm thầm. Hình mẫu hay gặp:
| Nhóm site | Request (mặc định lúc tạo site) | Mức dùng điển hình |
|---|---|---|
| Site thông thường (đa số) | 150m CPU, 350Mi RAM | vài chục millicore, 100–200 MiB RAM |
| Site dùng RAM cao (thiểu số) | 150–200m, 350–450Mi | RAM vượt request |
| Site dùng CPU cao (rất ít) | 150m | CPU gấp vài lần request |
Request của gần như mọi site là giá trị mặc định lúc tạo, chưa từng được đo lại. Tổng request CPU có thể gấp nhiều lần mức dùng thật.
Right-sizing không dựa trên số dùng tại một thời điểm. Lấy p95 trong ít nhất 7 ngày để có cả giờ cao điểm:
# CPU dùng thật, p95 trong 7 ngày, theo namespace
quantile_over_time(0.95,
  sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))[7d:5m])

# RAM working set, p95 trong 7 ngày, theo namespace
quantile_over_time(0.95,
  sum by (namespace) (container_memory_working_set_bytes{container!=""})[7d:5m])
Bước 4: áp công thức right-sizing
Công thức right-sizing nên đơn giản, dễ giải thích khi review:
# CPU request = CPU p95 × 1,2 + 10m   (làm tròn lên)
# RAM request = RAM p95 × 1,2         (làm tròn lên bội số 5Mi, tối thiểu 120Mi)

# ví dụ một site: p95 khoảng 24m CPU, 116 MiB RAM
resources:
  requests:
    cpu: 39m          # trước: 150m (mặc định lúc tạo site)
    memory: 140Mi     # trước: 350Mi
  limits:
    cpu: "1"
    memory: 700Mi
20% là phần đệm cho dao động, 10m CPU cố định để site quá nhàn vẫn có một mức đặt chỗ tối thiểu. Với site dùng vượt request, công thức tự nâng request lên. Đừng nâng nửa vời (ví dụ chỉ nâng tới một giá trị vẫn thấp hơn mức đang dùng) chỉ để tắt cảnh báo.
Bước 5: đưa vào Git như một thay đổi có review
Với cụm quản lý bằng Helm, bộ giá trị mới nằm trong values.yaml của từng site. Mỗi đợt right-sizing nên là một pull request riêng, kèm bảng trước/sau và nguồn số liệu, merge theo từng nhóm site, theo dõi vài ngày rồi mới làm nhóm tiếp theo.
Lỗi thường gặp: nhiều báo cáo, nhiều bộ số
Khi nhiều người cùng làm báo cáo về một cụm, các con số tổng gần như chắc chắn lệch nhau. Nguyên nhân thường là phạm vi đo khác nhau:
- Mức pod website hay mức node. Báo cáo theo node gồm cả pod hệ thống và DaemonSet giữ chỗ, luôn lớn hơn tổng request của website.
- Nhánh nào của repo cấu hình. Số của nhánh đang chuẩn bị right-sizing khác số đang chạy trên cụm cho tới khi merge và deploy.
- Cột điền đồng loạt. Một bảng tính có cột request điền cùng một giá trị cho mọi site, không khớp
values.yamlthật. - Dòng tổng cộng tay. Dòng tổng không khớp với tổng của chính các dòng chi tiết.
Cách rẻ nhất để biết số nào đáng tin: cộng lại từ bảng chi tiết từng site, và ghi rõ phạm vi (pod website hay cả node, nhánh nào, thời điểm nào) cạnh mọi con số tổng. Tốt hơn nữa, sinh tổng request tự động từ values.yaml và mức dùng từ Prometheus, không cộng tay.
Nguyên nhân gốc: vì sao cần right-sizing
- Request lấy từ mặc định lúc tạo site và không bao giờ đo lại. Giá trị mặc định phù hợp với một site mới chưa biết tải, nhưng sau nhiều tháng, phần lớn site chỉ dùng một phần nhỏ con số đó.
- Không có vòng phản hồi từ mức dùng về cấu hình. Grafana có số liệu dùng thật,
values.yamlcó request, nhưng không có gì so hai thứ với nhau. - Pod giữ chỗ đặt RAM quá lớn, làm scheduler thấy cụm đầy hơn thực tế.
- Limit đặt đồng loạt cho mọi site, nên limit tổng vượt xa tài nguyên node. Right-sizing request không tự sửa được phần này.
Sau right-sizing: có nên gom node?
Hạ request xong, cụm trông rảnh hẳn và ý tưởng gom bớt node xuất hiện ngay. Hãy tính trước khi làm:
- Lấy RAM allocatable thật của mỗi node (luôn nhỏ hơn RAM danh nghĩa của gói, vì kubelet và hệ điều hành giữ một phần).
- Cộng tổng request mới của website, pod giữ chỗ và pod hệ thống.
- Kiểm tra với N−1 node: mất một node thì phần còn lại vẫn phải chứa được mọi pod. Nếu tỉ lệ đặt chỗ đã quá 80–85% thì chưa nên gom.
- So tổng limit RAM với tổng allocatable. Gom node làm tỉ lệ overcommit limit tăng theo.
Gom node là bước sau của right-sizing, chỉ nên làm khi request mới đã chạy ổn định một thời gian, không làm cùng đợt.
Checklist right-sizing định kỳ
- Đo theo khoảng thời gian (p95 trong 7 ngày), không theo một thời điểm.
- Cảnh báo theo cả hai chiều, coi đó là tín hiệu cần right-sizing: dùng vượt request (nguy cơ bị đẩy khi node căng) và dùng dưới một tỉ lệ nhỏ của request trong nhiều ngày (đặt chỗ thừa).
- Theo dõi tỉ lệ limit trên tài nguyên từng node. Theo tài liệu Kubernetes về quản lý tài nguyên container, limit không được scheduler đảm bảo. Limit RAM vượt xa allocatable nghĩa là nhiều site cùng phình là đủ đẩy node vào thiếu bộ nhớ.
- Rà kích thước pod giữ chỗ và pod hệ thống trước khi chỉnh website.
- Mỗi đợt right-sizing là một pull request có bảng trước/sau và nguồn số liệu.
- Đặt lịch lặp lại, ví dụ mỗi quý, hoặc sau mỗi đợt thêm nhiều site.
Bài học
- Request là lời hứa với scheduler, không phải dự báo. Hứa thừa thì tốn node, hứa thiếu thì site bị đẩy đi khi node căng.
- Right-sizing là việc định kỳ. Mức dùng của site thay đổi theo nội dung, lưu lượng và code. Một lần chỉnh không đúng mãi.
- Đọc kỹ phạm vi của mọi con số tổng. Các báo cáo lệch nhau vì mỗi bản đo một thứ khác.
- Right-sizing request không thay cho sửa limit. Phần đặt chỗ và phần overcommit limit là hai việc khác nhau, cần xử lý cả hai.
Bài tiếp theo
fastcgi_cache và Set-Cookie: giảm TTFB mà không rò session. Quay lại Cloud VPS: bật cache trang thật sự cho một site, vì sao nginx từ chối cache mọi response của Laravel, và cái giá phải trả nếu cho phép cache cả header Set-Cookie.