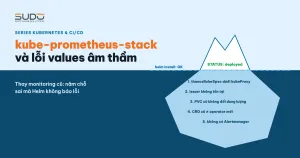
Thay một stack giám sát cũ bằng kube-prometheus-stack thường trông rất suôn sẻ: lệnh cài báo Install complete, Prometheus lên, Grafana vào được, mọi pod Running. Nhưng "không có lỗi" chưa chắc là "đúng ý". Chart này có values rất dài và không kèm schema, nên một key đặt sai chỗ chỉ bị bỏ qua trong im lặng. Bài này giải thích kube-prometheus-stack gồm những gì, cách thay stack cũ an toàn, năm kiểu cấu hình "sai âm thầm" hay gặp và cách bắt chúng trước khi cài lên production.
1. kube-prometheus-stack gồm những gì
kube-prometheus-stack là chart Helm của cộng đồng Prometheus, gói sẵn mọi thứ cần để giám sát một cluster:
- Prometheus Operator: controller đọc các CRD như
Prometheus,ServiceMonitor,PrometheusRule,Alertmanager,ThanosRulervà dựng StatefulSet, ConfigMap tương ứng. - Prometheus, do operator quản lý qua object
Prometheus. - Alertmanager: nhận cảnh báo từ Prometheus và gửi đi (chat, email...).
- Grafana kèm sẵn dashboard, kube-state-metrics và node-exporter.
- Bộ rule mặc định: vài chục object
PrometheusRule, gồm recording rule lẫn alert rule cho node, kubelet, API server, workload.
Điểm mạnh của kube-prometheus-stack là một lệnh có cả bộ. Điểm yếu cũng nằm ở đó: values.yaml mặc định dài hàng nghìn dòng và chart không kèm values.schema.json. Helm vì vậy không kiểm tra được key nào trong values của bạn là hợp lệ. Gõ sai tên hoặc sai vị trí một key, Helm chỉ lặng lẽ bỏ qua.
Nếu cluster đang chạy bản kube-prometheus cũ như bài Giám sát Kubernetes với kube-prometheus và Grafana, sau một thời gian Kubernetes lên nhiều phiên bản mà stack giám sát đứng yên, việc thay mới là cần thiết.
2. Values kube-prometheus-stack mẫu cho cluster managed
Ví dụ values tối thiểu cho cluster LKE, Prometheus và Grafana chạy trên một node pool riêng:
alertmanager:
  enabled: true
  config:
    route: { receiver: chat }
    receivers:
      - name: chat
        slack_configs: [{ api_url_file: /etc/alertmanager/secrets/chat-webhook/url, channel: "#alerts" }]
grafana:
  persistence: { enabled: true, size: 10Gi }
  affinity: &monitoringPool
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              - { key: lke.linode.com/pool-id, operator: In, values: ["<pool-monitoring>"] }
prometheusOperator:
  affinity: *monitoringPool
kube-state-metrics:
  affinity: *monitoringPool
prometheus:
  ingress:
    enabled: true
    annotations:
      cert-manager.io/cluster-issuer: letsencrypt-prod
  prometheusSpec:
    affinity: *monitoringPool
    retention: 15d
    storageSpec:
      volumeClaimTemplate:
        spec: { resources: { requests: { storage: 30Gi } } }
kubeEtcd: { enabled: false }
kubeControllerManager: { enabled: false }
kubeScheduler: { enabled: false }
Ba dòng cuối là cần thiết trên cluster managed: control plane do nền tảng quản lý, Prometheus trong cluster không scrape được etcd, scheduler hay controller manager. Bật chúng lên chỉ sinh target down và cảnh báo giả.
3. Thay stack cũ bằng kube-prometheus-stack: gỡ rồi cài
Thay stack cũ có hai cách: nâng cấp release cũ hoặc gỡ hẳn rồi cài mới. Gỡ rồi cài thì sạch hơn, nhưng cần lưu ý PersistentVolume. Nếu StorageClass có reclaim policy Retain, mỗi lần gỡ release thì PVC mất nhưng volume ở lại với trạng thái Released, và vẫn bị tính tiền cho tới khi có người xoá tay. Thử đi thử lại nhiều lần trên production là mỗi lần để lại một volume.
- Thử values trên cluster test, hoặc đặt
grafana.persistence.enabled: falsetới khi values đã ổn. - Sau khi cài xong, liệt kê volume bị bỏ lại:
kubectl get pv | grep Released, rồi dọn có chủ đích. - Ghi lại tên release. Đổi tên release là đổi tên mọi PVC sinh ra từ nó (xem mục 6).
4. Sai âm thầm 1: key nằm sai chỗ trong values kube-prometheus-stack
Ví dụ hay gặp: khối thanosRulerSpec kèm affinity lại nằm dưới kubeProxy. Trong kube-prometheus-stack, kubeProxy chỉ cấu hình việc scrape kube-proxy. Đường dẫn đúng là thanosRuler.thanosRulerSpec, và ThanosRuler mặc định cũng không bật. Chart không đọc đường dẫn sai, nên cả khối không có tác dụng.
Biến thể khác: khối đúng đường dẫn nhưng áp cho thành phần không được bật, ví dụ affinity ở prometheusOperator.admissionWebhooks.deployment trong khi deployment.enabled mặc định là false. Kết quả chung: operator, Grafana, kube-state-metrics không có affinity và có thể bị xếp lên pool ứng dụng, đúng chỗ mà thiết kế "tách monitoring ra pool riêng" muốn tránh.
5. Sai âm thầm 2: ClusterIssuer không tồn tại, Certificate vẫn Ready
Annotation cert-manager.io/cluster-issuer trên Ingress trỏ tới một ClusterIssuer gõ nhầm tên, chẳng hạn lẫn với tên Secret chứa khoá ACME. Theo tài liệu cert-manager: Securing Ingress Resources, annotation này khiến cert-manager tự tạo một Certificate cho Ingress. Nếu Secret TLS mà nó trỏ tới đã có chứng chỉ hợp lệ do issuer đúng cấp từ trước, bạn sẽ thấy:
$ kubectl describe certificate monitoring-tls -n monitoring
Issuer Ref:  ClusterIssuer/letsencrypt-prd     # tên gõ nhầm
Conditions:
  Ready    True  Ready            Certificate is up to date and has not expired
  Issuing  True  IncorrectIssuer  Issuing certificate as Secret was previously issued
                                  by ClusterIssuer.cert-manager.io/letsencrypt-prod
Ready=True chỉ vì Secret cũ còn hạn. Điều kiện Issuing thì kẹt ở IncorrectIssuer: tới lúc chứng chỉ cũ hết hạn sẽ không ai gia hạn được. Cùng kiểu đó, Ingress khai một Secret TLS không tồn tại vẫn có HTTPS nếu dùng chung host với một Ingress khác có chứng chỉ, vì ingress controller phục vụ chứng chỉ theo host. Gỡ Ingress kia là mất HTTPS mà không ai hiểu vì sao.
6. Sai âm thầm 3: PVC cũ không đổi dung lượng
Values của kube-prometheus-stack khai storage: 30Gi cho Prometheus, nhưng release mới giữ đúng tên release cũ. StatefulSet sinh ra đúng tên PVC cũ, và volumeClaimTemplates chỉ tạo PVC khi chưa có, không bao giờ sửa PVC đã tồn tại. Prometheus vì vậy chạy trên volume nhỏ cũ trong khi ai đọc values cũng tưởng là 30Gi. Ngược lại, đổi tên release thì PVC mới được tạo và PVC cũ bị bỏ lại. Cả hai trường hợp đều cần kiểm tra:
kubectl -n monitoring get pvc -o custom-columns=NAME:.metadata.name,SIZE:.status.capacity.storage,STATUS:.status.phase7. Sai âm thầm 4: CRD cũ, operator mới
$ kubectl get crd prometheuses.monitoring.coreos.com \
    -o jsonpath='{.metadata.annotations.operator\.prometheus\.io/version}'
Helm chỉ cài CRD trong thư mục crds/ khi CRD chưa tồn tại, và không bao giờ nâng cấp chúng. Đây là hành vi có chủ đích, ghi trong Helm: Custom Resource Definitions, và README của kube-prometheus-stack cũng nói rõ CRD phải được cập nhật thủ công. Nếu phiên bản in ra thấp hơn appVersion của chart, operator mới vẫn chạy, nhưng trường nào schema cũ không biết sẽ bị API server lược bỏ khi lưu object, không có lỗi nào trả về. Áp CRD đúng phiên bản trước khi cài hoặc nâng cấp:
helm pull prometheus-community/kube-prometheus-stack --version <phiên bản> --untar
kubectl apply --server-side -f kube-prometheus-stack/charts/crds/crds/
Chart còn có tuỳ chọn crds.upgradeJob.enabled áp CRD bằng Helm hook, nhưng values của chart ghi đây là tính năng thử nghiệm và tắt mặc định.
8. Sai âm thầm 5: kube-prometheus-stack có rule, không ai nhận cảnh báo
Đặt alertmanager.enabled: false là cấu hình hợp lệ. Rule mặc định vẫn được tạo, alert vẫn chuyển sang firing, nhưng không có gì được gửi đi. Cảnh báo chỉ nằm trong trang Alerts của Prometheus, chờ ai đó tình cờ mở ra. Monitoring chưa xong khi cảnh báo chưa tới được người. Tương tự, mở Prometheus qua Service NodePort để đọc từ ngoài thì cổng đó mở trên mọi node, nên phải đi kèm firewall chỉ cho đúng nguồn truy cập.
9. Bắt lỗi kube-prometheus-stack sớm bằng helm template
| Chỗ sai | Vì sao không báo | Cách bắt |
|---|---|---|
| Key sai chỗ, key cho thành phần không bật | Chart không có schema | helm template rồi tìm trong output |
| Issuer không tồn tại | Certificate vẫn Ready nhờ Secret cũ | Xem điều kiện Issuing, không chỉ cột READY |
| PVC không đúng dung lượng | StatefulSet dùng PVC trùng tên có sẵn | So kubectl get pvc với values |
| CRD cũ | Helm cố ý bỏ qua CRD đã có | So nhãn version của CRD với appVersion |
| Không có Alertmanager | Cấu hình hợp lệ | Bắn thử một cảnh báo và chờ nó tới nơi |
helm lint không giúp được ca đầu tiên vì về cú pháp values hoàn toàn hợp lệ. Thứ giúp được là render manifest thật và kiểm tra điều mình khai báo có xuất hiện ở đúng object:
helm template monitoring prometheus-community/kube-prometheus-stack \
  --version <phiên bản> -n monitoring -f values.yaml > rendered.yaml

# số khối affinity trong manifest phải bằng số khối khai trong values
grep -c "lke.linode.com/pool-id" rendered.yaml

# Deployment/StatefulSet nào chưa có affinity?
grep -E "^kind: (Deployment|StatefulSet)|^  name:|affinity:" rendered.yaml
Prometheus và Alertmanager do operator dựng từ CRD, nên với chúng cần tìm trong object Prometheus, Alertmanager thay vì StatefulSet. Đọc output của helm template vài phút trước khi cài rẻ hơn nhiều so với cài thử nhiều lần trên production.
10. Checklist sau khi cài kube-prometheus-stack
- "Install complete" chỉ nghĩa là Kubernetes đã nhận manifest. Luôn đọc trạng thái thật.
- Mỗi pod giám sát chạy đúng node pool:
kubectl -n monitoring get pods -o wide. - Mọi điều kiện của Certificate, không chỉ cột READY.
- Dung lượng PVC khớp values, không còn volume
Releasedbị bỏ quên. - Phiên bản CRD khớp operator.
- Có ít nhất một cảnh báo thử đi tới người nhận. Như bài Self-healing tiết kiệm: tự phát hiện và khởi động lại dịch vụ chết, hệ thống tự theo dõi mà không ai nhận tín hiệu thì gần như không theo dõi.
Các bài khác của series nằm trong chuyên mục blog kỹ thuật của Sudo, trong đó bài Dựng nhanh cluster Kubernetes cho dự án microservice là nơi kube-prometheus-stack được cài theo cùng kịch bản.
Bài tiếp theo
Jenkins và GitLab CI: vận hành Website AI trên Kubernetes. Mô hình Jenkins làm form nhập liệu, GitLab CI làm việc thật với kubectl và Helm, cùng các nguyên tắc giữ bí mật ở ranh giới giữa hai hệ thống.