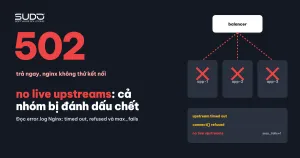
Một website thương mại điện tử đột nhiên trả 502 ngay lập tức cho mọi khách, còn error.log trên balancer ghi liên tục hàng chục dòng no live upstreams mỗi giây. Điều đáng chú ý: nhóm upstream của site này có nhiều minion, tức là đã được thiết kế để chịu lỗi. Tài liệu này hướng dẫn cách đọc error.log để phân biệt ba loại lỗi upstream hay bị gộp làm một, cơ chế khiến nginx tuyên bố "no live upstreams", quy trình xử lý khi gặp nó, và một kiểu chết khác chậm hơn nhiều: minion ốm kéo dài mà không ai biết.
Triệu chứng
- Site trả
502 Bad Gatewaygần như tức thì, không có độ trễ chờ timeout. - Error.log của site chỉ có một loại dòng lỗi, lặp lại liên tục, tất cả trỏ về cùng một nhóm upstream:
[error] ... no live upstreams while connecting to upstream, client: ...,
  server: shop.example, request: "GET / HTTP/1.1",
upstream: "http://shopweb/", host: "shop.example"- Nhóm
shopwebgồm vài minion cùng cấu hình nhỏ, chạy cùng một bộ code và dùng chung một máy database. Trong bài gọi chúng là app-1, app-2, app-3. - Lỗi tập trung trong một khung thời gian ngắn rồi tự hết.
Quy trình điều tra
Bước 1: đếm trước khi đọc
Với error.log hàng trăm nghìn dòng, việc đầu tiên là đếm theo mẫu thông điệp trên mọi balancer:
cd /var/log/nginx
for p in "no live upstreams" "upstream timed out" "connect() failed (111" \
         "upstream prematurely closed"; do
  printf '%-32s %s\n' "$p" "$(cat *.error error.log | grep -c "$p")"
done

# gom dòng no live upstreams theo ngày và giờ
grep -h "no live upstreams" *.error | awk '{print $1, substr($2,1,2)":00"}' | sort | uniq -c

# xem dòng lỗi trỏ về nhóm upstream nào
grep -h "no live upstreams" *.error | grep -o 'upstream: "[^"]*"' | sort | uniq -c
Nếu toàn bộ dòng no live upstreams thuộc một site, một khung giờ và một nhóm upstream, trong khi các balancer khác gần như không có, thì câu hỏi chuyển thành: vì sao chỉ nhóm này?
Bước 2: ba thông điệp, ba tình huống khác nhau
Bài Tầng Balancer: Nginx reverse proxy, SSL offload và định tuyến domain đã có bảng đối chiếu 502, 504 với dòng log. Khi điều tra cần tách kỹ hơn, vì mỗi thông điệp cho biết nginx đã đi được tới bước nào:
| Dòng trong error.log | Nginx đã làm gì | Client nhận | Client phải chờ |
|---|---|---|---|
upstream timed out (110: Connection timed out) while connecting to upstream | Gửi yêu cầu kết nối, không ai trả lời trong proxy_connect_timeout | 504 | Bằng proxy_connect_timeout (mặc định 60 giây) |
upstream timed out ... while reading response header from upstream | Kết nối được, nhưng ứng dụng không trả lời kịp proxy_read_timeout | 504 | Bằng proxy_read_timeout |
connect() failed (111: Connection refused) while connecting to upstream | Máy đích còn sống nhưng không có tiến trình nghe ở cổng đó | 502 | Gần như tức thì |
no live upstreams while connecting to upstream | Không thử kết nối, vì mọi server trong nhóm đang bị đánh dấu không khả dụng | 502 | Tức thì |
Hai dòng đầu đều là "timed out", nhưng cụm từ cuối quyết định hướng điều tra. While connecting nghĩa là máy đích không nhận kết nối: máy treo, quá tải nặng ở tầng hệ điều hành, hoặc mạng có vấn đề. While reading response header nghĩa là máy vẫn nhận kết nối, chỗ chậm nằm ở PHP hoặc database. Connection refused thì ngược lại: máy trả lời rất nhanh rằng không có ai ở đó, như khi tiến trình ứng dụng chết trong bài Octane OOM: khi một tiến trình kéo sập cả minion.
Còn no live upstreams không phải lỗi kết nối. Nó là quyết định của chính nginx: không còn server nào trong nhóm được coi là sống, nên nginx không thử nữa.
Bước 3: hiểu max_fails, fail_timeout và vì sao chỉ nhóm nhiều server có no live upstreams
Theo tài liệu module upstream của nginx, mỗi server trong nhóm có hai tham số max_fails và fail_timeout. Mặc định max_fails=1 và fail_timeout=10s: chỉ cần một lần thất bại trong 10 giây, server bị coi là không khả dụng trong 10 giây tiếp theo. Thế nào là "thất bại" do proxy_next_upstream quyết định, mặc định là error timeout: lỗi kết nối, lỗi gửi request, lỗi đọc header, hoặc timeout. Một phản hồi HTTP 502 hay 504 do minion trả về không bị tính là thất bại, trừ khi khai thêm http_502, http_504.
Chi tiết quyết định nằm ở một câu trong tài liệu: nếu nhóm chỉ có một server, max_fails và fail_timeout bị bỏ qua, server đó không bao giờ bị coi là không khả dụng. Site chạy trên một minion, hoặc cấu hình proxy_pass thẳng tới IP (một nhóm ngầm định chỉ có một server), sẽ không bao giờ sinh ra no live upstreams. Chỉ nhóm nhiều server mới có thể rơi vào trạng thái "tất cả cùng bị đánh dấu chết":
upstream shopweb {
    server 10.0.0.61:80;     # app-1
    server 10.0.0.62:80;     # app-2
    server 10.0.0.63:80;     # app-3
    # không khai max_fails / fail_timeout → mặc định 1 lần lỗi / 10 giây
}
Với mặc định đó, khi mọi minion cùng lỗi lặp lại, mỗi server chỉ được thử lại khi hết 10 giây cấm, gặp lỗi lại bị cấm tiếp. Trong khoảng thời gian cả nhóm đều đang bị cấm, mọi request tới đều nhận no live upstreams.
Bước 4: đọc số dòng cho đúng
Hàng trăm nghìn dòng no live upstreams không có nghĩa là minion lỗi hàng trăm nghìn lần. Mỗi dòng là một request bị từ chối mà không có lần thử nào. Con số đó đo lượng truy cập trong lúc cả nhóm bị cấm, chứ không đo mức nghiêm trọng của lỗi phía sau. Muốn biết minion đã lỗi thế nào, phải tìm các dòng timed out hoặc refused tới từng IP ngay trước và xen giữa các dòng no live upstreams.
Bước 5: kiểu chết ngược lại, minion ốm kéo dài
Cùng cách đếm ở bước 1 thường lộ ra một bức tranh ngược hẳn: một site chỉ có một minion, error.log rải rác hàng nghìn dòng upstream timed out (110: Connection timed out) while connecting to upstream tới cùng một IP, kéo dài nhiều tuần. Site một server nên nginx không bao giờ đánh dấu nó chết. Mỗi khi minion không nhận kết nối, từng request phải chờ trọn proxy_connect_timeout rồi mới nhận 504. Đây là kiểu chết chậm: không có lúc nào site "sập hẳn" để ai đó nhận ra, chỉ có khách lẻ tẻ phải chờ rồi bỏ đi.
Nhóm nhiều server chết nhanh và ồn ào (no live upstreams, 502 tức thì), một server chết chậm và im lặng (504). Cả hai đều cho thấy chưa có failover thật.
Nguyên nhân gốc
- Cơ chế: mọi minion của nhóm cùng gặp lỗi kết nối hoặc timeout trong cùng khung thời gian. Với
max_fails=1, fail_timeout=10s, nginx đánh dấu tất cả không khả dụng và từ chối mọi request bằng no live upstreams. - Vì sao các máy cùng lỗi: chúng chạy cùng code, cùng database, cùng nhận một luồng truy cập, nên có chung miền lỗi. Một nguyên nhân hay gặp là cạn worker PHP-FPM vì code gọi dịch vụ ngoài đồng bộ trong request (xem bài PHP-FPM treo: lần theo strace tới cuộc gọi S3 đồng bộ). Khi chưa có bằng chứng, đừng gán nguyên nhân cũ cho sự cố mới.
- Gốc rễ chung: không có HA thật và không có cảnh báo dựa trên lỗi upstream. Site một minion thì minion ốm là site ốm. Site nhiều minion dùng chung phụ thuộc thì "ba máy" không đồng nghĩa với "ba lần an toàn".
Khắc phục
Trình tự xử lý khi error.log bắt đầu ra no live upstreams
# 1. Từ balancer, gọi thẳng từng server trong nhóm, kèm Host của site
for ip in 10.0.0.61 10.0.0.62 10.0.0.63; do
  curl -s -o /dev/null -m 5 -w "$ip %{http_code} %{time_total}s\n" \
       -H 'Host: shop.example' "http://$ip/"
done

# 2. Server nào timeout hoặc refused: vào minion đó kiểm tra dịch vụ và pool
systemctl is-active nginx php8.2-fpm
journalctl -k --since "-30 min" | grep -i "out of memory"
grep -c "max_children" /var/log/php8.2-fpm.log
Không cần sửa gì ở balancer nếu minion đã khoẻ lại: hết fail_timeout, nginx tự thử server đó với request tiếp theo.
Cấu hình khuyến nghị cho nhóm nhiều server
upstream shopweb {
    server 10.0.0.61:80 max_fails=3 fail_timeout=30s;
    server 10.0.0.62:80 max_fails=3 fail_timeout=30s;
    server 10.0.0.63:80 max_fails=3 fail_timeout=30s;
    keepalive 16;
}
location / {
    proxy_pass http://shopweb;
    proxy_connect_timeout 3s;
    proxy_next_upstream error timeout;
    proxy_next_upstream_tries 2;
}- Khai
max_failsvàfail_timeoutcó chủ đích để một lỗi lẻ không cấm cả server. Đánh đổi: server hỏng thật sẽ bị phát hiện chậm hơn vài lần thử. - Rút ngắn
proxy_connect_timeoutcho kết nối trong mạng private. Kết nối giữa balancer và minion bình thường chỉ tính bằng mili giây, chờ tới 60 giây chỉ làm khách chờ vô ích. - Đặt cảnh báo theo số dòng lỗi upstream mỗi phút của từng site, tách ba loại thông điệp. Muốn vậy, error.log cần được gom về một chỗ thay vì nằm rải trên từng balancer.
Checklist phòng ngừa
- Định kỳ đếm bốn mẫu thông điệp (timed out while connecting, timed out while reading, refused, no live upstreams) trên mọi balancer, so với kỳ trước.
- Thấy timed out while connecting tới cùng một IP lặp lại: coi minion đó là đang ốm, kiểm tra ngay, không đợi khách báo.
- Thấy no live upstreams: tìm các dòng lỗi tới từng IP ngay trước đó, đó mới là nguyên nhân.
- Với nhóm nhiều server, rà xem các máy có chung phụ thuộc nào (database, object storage, API ngoài) có thể làm chúng cùng ngã.
- Ghi rõ trong tài liệu vận hành:
least_connhay khối upstream một server không tạo ra failover.
Bài học
- Đọc hết câu log. "timed out while connecting" và "timed out while reading" dẫn tới hai hướng điều tra khác hẳn nhau.
- no live upstreams là hệ quả, không phải nguyên nhân. Nó cho biết nginx đã hết server để thử, không cho biết vì sao.
- Nhiều máy chưa phải là HA. Các máy chung code, chung database có thể ngã cùng lúc. Một máy duy nhất thì có thể ốm hàng tuần mà không ai biết nếu không có cảnh báo.
Bài tiếp theo
Ba lỗi sau khi migrate PHP-FPM: log path, upload_max và timezone. Tách mỗi site một pool PHP-FPM chặn được lỗi max_children, nhưng sau đó có thể lộ ra ba lỗi mà health check HTTP không bắt được.