Một website Website AI trên cluster LKE của Linode trả 503 lúc có lúc không. Không có đợt sập dài nào, chỉ là thỉnh thoảng trang không mở được, một lúc sau lại bình thường. kubectl cho thấy pod duy nhất của site bị OOMKilled lặp đi lặp lại với limit bộ nhớ 700Mi. Bản sửa nhanh chỉ là một dòng trong values.yaml. Nhưng câu hỏi đằng sau nó lớn hơn: trong một container chạy cả nginx, PHP-FPM, cron và queue worker, ai đang giữ "ngân sách" bộ nhớ, PHP hay Kubernetes? Tài liệu này hướng dẫn cách chẩn đoán, cách tính limit container từ cấu hình PHP, và cách để một lần OOMKilled không thành 503.
Bài Upload ảnh lỗi 419 và 502 trên Kubernetes nói về trường hợp memory_limit của PHP chặn trước, và người dùng thấy 502. Bài này là chiều ngược lại: limit container chặn trước, cả pod bị kill, và người dùng thấy 503.
Triệu chứng
- Site trả 503 ngắt quãng, mỗi lần kéo dài ngắn rồi tự hết.
- Site chỉ có một pod (
replicaCount: 1). - Cột
RESTARTScủa pod tăng đều, nhiều lần mỗi ngày.
Quy trình điều tra
Bước 1: 503 đến từ đâu
Trong chuỗi NodeBalancer → ingress-nginx → Service → pod, 503 có nghĩa khá cụ thể: ingress-nginx nhận request nhưng Service không còn endpoint nào sẵn sàng. Với một site một pod, chuyện đó xảy ra mỗi khi container duy nhất khởi động lại. Vì vậy câu hỏi đầu tiên là pod có restart không, và vì sao.
kubectl -n site-b-example get pod
NAME                       READY   STATUS    RESTARTS
site-b-example-<hash>      1/1     Running   ...

kubectl -n site-b-example describe pod site-b-example-<hash>
    Last State:     Terminated
      Reason:       OOMKilled
      Exit Code:    137
    Limits:
      cpu:     1
      memory:  700Mi

kubectl -n site-b-example get endpoints   # trống trong lúc pod khởi động lại
Exit code 137 là 128 + 9: tiến trình chính nhận SIGKILL từ kernel vì cgroup của container vượt memory.max. PHP không kịp báo lỗi gì.
Bước 2: mỗi lần OOMKilled là bao lâu 503
Thời gian 503 không chỉ là lúc container chết. Container mới thường phải:
- Kéo lại image, nếu
imagePullPolicy: Always. - Chạy xong hook
postStart(copy code,optimize:clear, publish asset…). - Qua
startupProbe, ví dụ bắt đầu sau 15 giây, mỗi 10 giây kiểm tra một lần. - Qua
readinessProbe, rồi mới được đưa trở lại vào endpoint của Service.
Tức là mỗi lần OOMKilled, site mất ít nhất vài chục giây. Kubernetes làm đúng việc của nó. Vấn đề là site không có pod thứ hai để đỡ trong lúc đó.
Bước 3: limit đó từ đâu ra
Thường limit không được chọn riêng cho site, mà là giá trị chung đặt cho cả fleet, ví dụ sau một đợt dồn node để xếp nhiều pod hơn trên mỗi node (xem bài PriorityClass và pod giữ chỗ). Một con số chung có thể đúng cho phần lớn site nhưng sai với site có tải hoặc tính năng nặng hơn.
# đếm các giá trị limit đang dùng trong repo cấu hình
grep -rh "memory:" --include=values.yaml . | sort | uniq -c | sort -rn
Bước 4: phép cộng bộ nhớ dẫn tới OOMKilled
Container Website AI là kiểu all-in-one, kế thừa từ thời chạy trên VPS. Bên trong có:
| Tiến trình | Giới hạn riêng | Ghi chú |
|---|---|---|
| nginx | không | nhỏ, ổn định |
| PHP-FPM, nhiều worker | memory_limit mỗi worker (ví dụ 128M) | số worker tăng theo lượng request đồng thời |
Queue worker queue:work --memory=500 | memory_limit theo php.ini; cờ --memory chỉ được kiểm sau khi xong một job | sống lâu, chạy dưới supervisord |
schedule:run qua crond, mỗi phút | memory_limit theo php.ini | một tiến trình CLI mới mỗi phút |
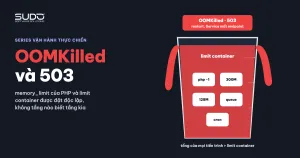
memory_limit là giới hạn cho từng tiến trình, còn resources.limits.memory là giới hạn cho tổng. Chỉ cần vài worker FPM cùng xử lý trang nặng, ví dụ năm worker chạm 128M là 640 MiB, cộng nginx, queue worker và một lần schedule:run, đã vượt 700Mi. Khi đó không tiến trình nào vượt giới hạn của riêng nó, nhưng cả container vẫn bị OOMKilled.
Giới hạn của PHP còn có thể có lỗ. Nhiều CMS có helper chủ động nâng hoặc bỏ memory_limit cho thao tác nặng:
// helper dùng chung của CMS (rút gọn)
public function maximumExecutionTimeAndMemoryLimit(): self
{
    $this->iniSet('max_execution_time', -1);
    $this->iniSet('memory_limit', -1);     // bỏ hẳn giới hạn của PHP
    return $this;
}
// thường được gọi khi: tạo lại thumbnail, crop ảnh, xuất đơn hàng, import/export dữ liệu
# tìm mọi chỗ code tự đổi memory_limit
grep -rnE "ini_set\('memory_limit'|iniSet\('memory_limit'" app/ packages/ platform/ 2>/dev/nullỞ những đường code này, PHP không còn tự dừng. Lưới an toàn duy nhất còn lại là limit của container, và khi lưới đó bật thì kết quả là OOMKilled cả pod chứ không chỉ request nặng.
Giới hạn của việc chẩn đoán
Đỉnh bộ nhớ thường diễn ra trong vài giây, nhanh hơn chu kỳ lấy mẫu 15–30 giây của Prometheus, nên biểu đồ hiếm khi chỉ ra được tiến trình nào phình. Nếu cần biết chính xác thủ phạm (worker FPM, queue worker, cron hay một thao tác admin bỏ memory_limit), hãy ghi RSS từng tiến trình định kỳ ngay trong container, hoặc tách các tiến trình ra container riêng để mỗi cái có số liệu riêng.
Nguyên nhân gốc
- Trực tiếp: tổng bộ nhớ của các tiến trình trong container vượt limit, kernel giết container (OOMKilled, exit 137).
- Vì sao thành 503: site chỉ có một replica. Mỗi lần container khởi động lại, Service không còn endpoint, ingress-nginx trả 503 cho tới khi pod qua lại được probe.
- Vì sao limit không khớp ứng dụng: limit container được đặt chung cho mọi site, trong khi giới hạn bộ nhớ thật của ứng dụng nằm ở nơi khác (
memory_limit, số worker FPM,--memorycủa queue worker) và có đường code tự bỏ giới hạn đó. Hai tầng được đặt độc lập, không tầng nào biết tầng kia.
Khắc phục
Tạm thời: nâng limit cho site
resources:
  limits:
    cpu: 1
    memory: 1536Mi     # trước đó 700Mi
  requests:
    cpu: 100m
    memory: 250Mi      # giữ nguyên
Request giữ nguyên, nên scheduler vẫn xếp pod như cũ. Chỉ trần bộ nhớ được nới để giảm số lần OOMKilled. Sau khi deploy, theo dõi RESTARTS ít nhất vài ngày để xác nhận con số mới đủ.
Lâu dài: cho hai tầng giới hạn nói chuyện với nhau
- Tính limit từ cấu hình PHP, không đặt một con số chung. Công thức gợi ý:
pm.max_children × memory_limit+ mức nền của queue worker, cron, nginx + khoảng đệm 15–20%. Nếu con số quá lớn, giảmpm.max_childrenchứ đừng giữ limit thấp. - Không cho code tự bỏ
memory_limittrong request web. Việc nặng như tạo lại thumbnail, export đơn hàng nên chạy trong queue với giới hạn rõ ràng. - Hạ
--memorycủa queue worker xuống dưới phần ngân sách dành cho nó, hoặc tách queue và cron sang container hay Deployment riêng để một job phình không kéo theo web. - Hai replica cho site quan trọng, để một lần OOMKilled không thành 503. Đổi lại, tốn thêm request trên node, và session lưu file trong container phải chuyển sang Redis hoặc database trước.
- Cảnh báo theo số lần OOMKilled từ kube-state-metrics, thay vì chờ người dùng báo 503:
increase(kube_pod_container_status_restarts_total[1h]) > 2
  and on (namespace, pod, container)
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} == 1
Checklist khi site trả 503 ngắt quãng
kubectl get pod:RESTARTScó tăng không?kubectl describe pod:Last StatelàOOMKilled(vượt limit container) hayError/Completed(thường do liveness probe kill)?- Nếu OOMKilled: so
resources.limits.memoryvớimemory_limit× số worker FPM, cộng queue worker và cron. Tìm trong code các chỗini_set('memory_limit', ...). - Nếu là 502 thay vì 503: nhiều khả năng
memory_limitcủa PHP chặn trước. Đọc error log của PHP-FPM trong container. - Không dựa vào biểu đồ bộ nhớ lấy mẫu thưa để bác bỏ OOMKilled.
Kiến thức nền về requests, limits, QoS và vì sao vượt limit bộ nhớ thì bị kill chứ không bị bóp như CPU có trong bài Requests và limits, QoS và nodeAffinity. Về request đặt dư hay thiếu so với mức dùng thật, xem bài Right-sizing Kubernetes. Tài liệu gốc: Resource Management for Pods and Containers của Kubernetes và mô tả memory_limit trong PHP.
Bài học
- OOMKilled là lỗi của cả container, không phải của một request. Trong pod all-in-one, một tiến trình phình là mọi thứ khác chết theo.
- Giới hạn của PHP và của Kubernetes phải được tính cùng nhau. Mỗi tầng đúng một mình vẫn có thể sai khi cộng lại.
- Một replica nghĩa là mỗi lần OOMKilled là một lần 503. Nâng limit giảm số lần OOMKilled; thêm replica mới giảm số lần người dùng thấy lỗi.
- Con số chung cho cả fleet cần được rà lại khi ứng dụng đổi. Giá trị đúng cho mục tiêu dồn node không nhất thiết đúng với nhu cầu của từng site.
Bài tiếp theo
Cascading restart supervisor: một lệnh làm gián đoạn mọi site Octane. Quay về Cloud VPS: một site Octane hết RAM, và mọi site khác trên cùng minion cùng tắt theo.