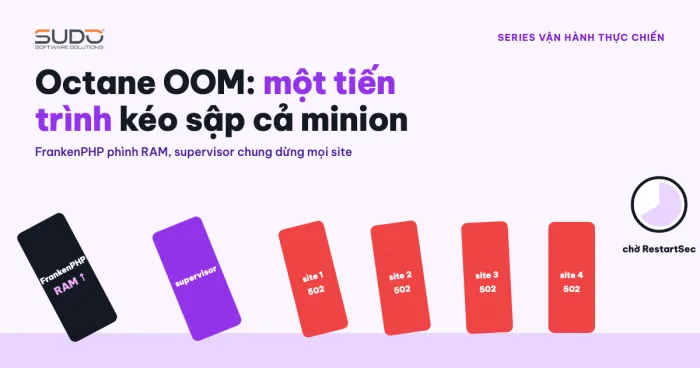
Một website thương mại điện tử chạy Laravel Octane trên một minion trả 502 vì kernel đã giết tiến trình FrankenPHP của site do hết RAM. Chuyện một site hết RAM thì không lạ. Điều đáng nói là trong một hai phút sau đó, mọi site trên minion cùng bị gián đoạn, dù chỉ một site thật sự dùng quá bộ nhớ. Thủ phạm khuếch đại là supervisor, chính xác hơn là cách cả minion dùng chung một dịch vụ supervisor. Còn một chi tiết khó chịu hơn: các pipeline vận hành có lệnh systemctl restart supervisor cũng tự gây ra đúng hiệu ứng đó, chỉ bằng một lệnh. Tài liệu này mô tả cơ chế cascading restart, quy trình xử lý, và cách viết lệnh vận hành có phạm vi đúng.
Triệu chứng
- Site A trả 502. Error log nginx trên minion:
connect() failed (111: Connection refused) while connecting to upstream, server: site-a.example, request: "POST /admin/products/804 HTTP/1.0", upstream: "http://127.0.0.1:8005/admin/products/804" - Cổng 8005 là cổng Octane của site A trên
127.0.0.1.Connection refusednghĩa là không còn tiến trình nào lắng nghe. - Site B, cũng chạy Octane trên cùng minion và không hề dùng nhiều RAM, có lỗi
Connection refusedđúng cùng thời điểm.
Quy trình điều tra
Bước 1: ai giết tiến trình Octane
journalctl -k | grep -iE "oom-kill|out of memory"
oom-kill: task_memcg=/system.slice/supervisor.service, task=frankenphp, pid=..., uid=...
Out of memory: Killed process ... (frankenphp) total-vm:...kB anon-rss:...kB
Kernel OOM killer giết FrankenPHP của site A khi tiến trình này giữ khoảng 1 GB RAM thật. Dòng quan trọng nhất là task_memcg=/system.slice/supervisor.service: tiến trình nằm trong cgroup của dịch vụ supervisor, cùng với mọi tiến trình khác mà supervisor quản lý.
Bước 2: vì sao một site Octane phình to
Kiểm tra tuổi tiến trình (ps -o pid,etime,rss,cmd -C frankenphp). Một tiến trình --workers=1 sống gần một ngày mà không lần nào được tái tạo là dấu hiệu đầu tiên. Đọc code của site, một mẫu hay gặp là listener chạy mỗi khi admin lưu dữ liệu:
public function handle(): void
{
    Artisan::call('cache:clear');
    Artisan::call('route:clear');
    Artisan::call('config:clear');
    Artisan::call('view:clear');
}
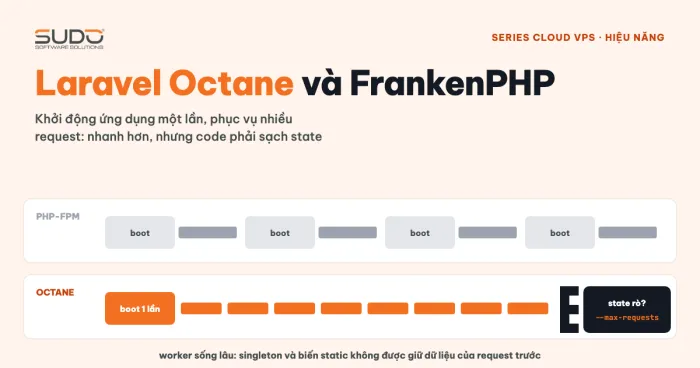
Bốn lệnh này hợp lý với PHP-FPM, nơi mỗi request là một tiến trình chết ngay sau đó. Trong Octane, ứng dụng sống mãi trong tiến trình. Mỗi lần xoá cache cấu hình, route, view là một lần buộc ứng dụng nạp lại từ đầu bên trong tiến trình đang sống, và phần bộ nhớ cấp thêm không được trả lại. Admin lưu sản phẩm càng nhiều, tiến trình càng phình. Đây đúng là loại rủi ro mà bài Laravel Octane và FrankenPHP đã cảnh báo: code viết cho mô hình PHP-FPM chạy trong một tiến trình sống lâu.
Bước 3: vì sao site B cũng chết
Mỗi site khai báo tiến trình Octane và queue worker trong file supervisord.ini riêng, nhưng tất cả cùng chạy dưới một daemon supervisor duy nhất. Daemon đó là một unit systemd: supervisor.service, với Restart=on-failure và RestartSec=50s theo gói của Debian. Khi kernel OOM killer giết một tiến trình bất kỳ trong cgroup của unit, chính sách mặc định OOMPolicy=stop của systemd coi cả unit là thất bại:
$ systemctl status supervisor
   Active: activating (auto-restart) (Result: oom-kill)
systemd dừng toàn bộ unit, nghĩa là dừng daemon supervisor cùng mọi tiến trình con, chờ RestartSec rồi khởi động lại. Mọi site Octane trên minion tắt cùng lúc và chỉ lên lại khi supervisor lên lại. Một lỗi cục bộ của site A đã thành sự cố của cả minion. Đó là cascading restart. Cơ chế này được phân tích chi tiết trong bài Octane OOM: khi một tiến trình kéo sập cả minion.
Bước 4: chính lần sửa cũng có thể gây 502
Biện pháp giảm thiểu cho site A, sau khi backup supervisord.ini:
[program:site-a-worker-octane]
command=... octane:start --server=frankenphp --workers=1 --max-requests=150   ; trước đó 500
stopasgroup=true
killasgroup=true
supervisorctl reread && supervisorctl updateCái bẫy hay gặp: một tiến trình frankenphp cũ (PPID=1, mồ côi từ lần OOM trước) không bị dừng và vẫn giữ cổng admin. Worker mới báo cổng đã bị chiếm, rơi vào BACKOFF rồi FATAL, và site A trả 502 thêm vài phút. Cách xử lý:
ss -ltnp | grep -E ':8005|:2019'           # ai đang giữ cổng?
ps -o pid,ppid,etime,cmd -C frankenphp     # PPID=1 là tiến trình mồ côi
kill -KILL <pid-mo-coi>                    # TERM thường không đủ
supervisorctl start site-a-worker-octane
curl -sI http://127.0.0.1:8005/ | head -1
Hai cờ stopasgroup/killasgroup được thêm chính để lần sau supervisor dừng cả nhóm tiến trình, không để sót con.
Bước 5: tìm mọi nơi đang restart cả supervisor
Ngoài OOM, còn gì restart cả dịch vụ supervisor? Rà các pipeline vận hành: deploy, đổi domain, chuyển site sang VPS khác (cả bước rollback), backup và gỡ site. Các mẫu lệnh cần tìm:
grep -rnE 'systemctl restart supervisor|service supervisor restart|restart supervisord' ./pipelines/Mỗi kết quả là một chỗ mà việc deploy một site PHP-FPM có queue worker cũng tắt mọi site Octane trên cùng máy. Một mẫu nguy hiểm khác là fallback leo thang:
supervisorctl restart site-a-worker site-a-worker-octane || systemctl restart supervisorChỉ cần tên chương trình gõ sai, lệnh đầu lỗi và pipeline lặng lẽ restart cả minion. Nếu pipeline deploy chạy đúng lúc supervisor đang tự khởi động lại sau OOM, nó cũng có thể báo ERROR: Octane server is not running và làm rối thêm việc điều tra.
Nguyên nhân gốc
- Phạm vi lỗi quá rộng: mọi site trên minion nằm chung một daemon supervisor và một cgroup. Chính sách OOM của systemd và
Restart=on-failurebiến cái chết của một tiến trình thành việc dừng và khởi động lại cả nhóm. - Lệnh vận hành có cùng phạm vi:
systemctl restart supervisortrong pipeline cũng dừng mọi chương trình supervisor đang quản lý, theo lịch của người chạy pipeline thay vì lịch của OOM killer. - Rò bộ nhớ ở tầng ứng dụng:
Artisan::call(...:clear)trong request làm tiến trình Octane phình dần cho tới khi bị kill.
Khắc phục
Ngay khi sự cố xảy ra
- Site gây lỗi: hạ
--max-requestsđể Octane tự tái tạo tiến trình thường xuyên hơn; thêmstopasgroup=true,killasgroup=true. - Dọn tiến trình mồ côi giữ cổng bằng
kill -KILL, rồi start lại riêng chương trình của site. - Áp thay đổi bằng
supervisorctl reread && supervisorctl update, chỉ đụng tới chương trình có cấu hình thay đổi. Không dùngsystemctl restart supervisor.
Sửa pipeline: lệnh nhắm đúng một site
# nạp cấu hình mới, chỉ khởi động lại chương trình của đúng site
supervisorctl reread
supervisorctl update
supervisorctl restart site-a-worker site-a-worker-octane || { echo "restart site-a lỗi"; exit 1; }

# gỡ site: xoá file rồi update, supervisor tự dừng chương trình không còn khai báo
rm -f /var/www/site-a.example/supervisord.ini
supervisorctl reread && supervisorctl update
Lệnh nhắm đúng site lỗi thì pipeline phải dừng và báo lỗi, không tự leo thang phạm vi.
Sửa ứng dụng và kiến trúc
- Sửa listener: chỉ
Cache::flush()phần dữ liệu cần xoá, hoặc đẩy việc xoá cache sang queue. Rà luôn các site dùng chung package có listener tương tự. - Tách tiến trình Octane khỏi daemon supervisor dùng chung: mỗi site một unit systemd với
MemoryMaxvà vòng đời riêng, supervisor chỉ còn giữ queue worker.
Checklist phòng ngừa
- Quét pipeline trước khi merge bằng lệnh
grepở bước 5. Kết quả khác rỗng là phải giải thích. - Theo dõi số lần dịch vụ supervisor khởi động lại:
journalctl -u supervisorcóResult: oom-killhoặcStartedngoài giờ deploy là dấu hiệu cần cảnh báo. - Watchdog bộ nhớ cho từng tiến trình Octane: tái tạo worker khi RSS vượt ngưỡng, trước khi kernel phải ra tay.
- Cẩn thận với job tự chữa: job quét supervisor định kỳ sẽ start lại chương trình
FATAL. Với lỗi cổng bị tiến trình mồ côi giữ, start lại không giải quyết được gì; cần kiểm tra cổng bằngss -ltnptrước. Cơ chế job tự chữa có ở bài Self-healing tiết kiệm. - Review code chạy trên Octane: cấm
Artisan::callcác lệnh*:cleartrong request.
Bài học
- Hỏi phạm vi của mỗi lệnh, không chỉ tác dụng của nó.
systemctl restart supervisor"nạp cấu hình mới" cho một site, và tắt mọi site khác như một tác dụng phụ. - Một tiến trình quản lý chung là một điểm lỗi chung. supervisor tiện vì mỗi site mang file cấu hình riêng, nhưng cgroup và vòng đời thì vẫn dùng chung.
- Sửa nóng cũng có thể gây sự cố. Tiến trình mồ côi giữ cổng có thể kéo dài 502 thêm vài phút. Cờ
killasgroupvà bước kiểm tra cổng nên có sẵn trước khi cần. - Chữa triệu chứng ở một site không xoá được rủi ro của cả máy. Một site Octane khác phình to là cascading restart lặp lại, cho tới khi miền lỗi được tách.
Tài liệu: chạy và điều khiển supervisord (reread, update, restart) và systemd.service (Restart=, OOMPolicy=).
Bài tiếp theo
Gộp MySQL cho Website AI: chuyển database sang host mới an toàn. Rút một máy MySQL khỏi cụm Kubernetes, và vì sao site "đã chuyển" vẫn có thể đang ghi vào database cũ.