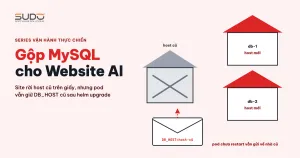
Khi một máy MySQL phục vụ cụm Kubernetes trở nên nhỏ so với lượng dữ liệu nó gánh, phương án hợp lý là gộp MySQL: rút máy đó ra, chuyển các website đang dùng nó sang những máy còn lại. Pipeline có thể báo thành công gần như toàn bộ, nhưng điều đó chưa có nghĩa là site đã dùng database mới. Một lỗi rất dễ gặp: site "đã chuyển" vẫn đọc và ghi vào database cũ, và chỉ một lần pod khởi động lại là site quay về bản copy cũ, mất mọi dữ liệu ghi trong khoảng giữa. Tài liệu này mô tả quy trình gộp MySQL cho Website AI trên cluster LKE của Linode, hai lỗ hổng của Helm chart mà việc gộp hay làm lộ ra, và checklist để lần sau chuyển database an toàn.
Khi nào nên gộp MySQL
Sau khi đưa database ra khỏi cluster (bài MySQL trong Kubernetes hay ngoài cluster), các site Website AI dùng vài VPS MySQL trong cùng mạng private với cluster. Theo thời gian, các máy lệch nhau. Dấu hiệu cần cân nhắc gộp MySQL:
- Một máy có CPU, RAM nhỏ hơn hẳn nhưng chứa nhiều dữ liệu nhất, buffer pool gần đầy, swap tăng dần.
- Nhiều schema không còn site nào dùng (orphan) chiếm đĩa và làm việc backup lâu hơn.
- Hit ratio của buffer pool vẫn cao: đây là việc dọn dẹp có kế hoạch, không phải chữa cháy hiệu năng.
Lên kế hoạch bằng cách liệt kê mọi schema trên máy cần rút, đánh dấu schema nào đang có site, schema nào orphan, rồi chia site sang các máy đích sao cho cân bằng dung lượng và tải, thay vì dồn hết về một máy.
SELECT table_schema, ROUND(SUM(data_length + index_length)/1024/1024) AS mb
FROM information_schema.tables GROUP BY table_schema ORDER BY mb DESC;
Pipeline gộp MySQL điển hình
Việc gộp MySQL thường được tự động hoá bằng pipeline (cách Jenkins và GitLab CI ghép với nhau có ở bài Jenkins và GitLab CI). Mỗi site đi qua các bước:
# pipeline đổi host database, mỗi site
[1] đọc DB_HOST, DB_DATABASE, DB_USERNAME, DB_PASSWORD từ env của pod đang chạy
[2] mysqldump trên host cũ, chuyển file qua máy trung gian
[3] giữ tên database/user, sinh mật khẩu mới, tạo database/user trên host mới
[4] import dump vào host mới
[5] sửa dbHost, dbPassword trong values.yaml bằng yq, helm upgrade
[6] check_website: curl https://<domain> tới khi trả 200
[7] push values.yaml lên repo cấu hình (push_with_retry)
[8] DROP DATABASE và DROP USER trên host cũ
Thiết kế pipeline gộp MySQL này có ba điểm yếu, được phân tích ở phần dưới.
Triệu chứng: máy cũ không nhẹ đi
Repo cấu hình cho thấy gần như mọi site đã trỏ sang host mới. Nhưng số đo trên máy cũ không đổi: vẫn đủ schema, dung lượng dữ liệu gần như cũ, và swap còn tăng. Sau một đợt gộp MySQL, máy vừa "mất" phần lớn site không thể bận hơn trước. Đây là tín hiệu để dừng lại và kiểm tra.
Quy trình điều tra sau khi gộp MySQL
Bước 1: xem site gộp MySQL thất bại
Site hay dừng giữa chừng là site có domain đã hết hạn: dig không trả về bản ghi A lẫn NS, nên check_website không bao giờ nhận được 200. Hậu quả là một trạng thái dở dang:
- ConfigMap trong cluster đã có
DB_HOSTmới, vìhelm upgradechạy trướccheck_website. values.yamltrên Git vẫn ghi host cũ, vì bước push chạy sau.- Database tồn tại ở cả hai nơi, bản trên host mới là snapshot lúc migrate.
- Pod vẫn dùng host cũ, nên site vẫn chạy bình thường.
Điểm cuối cùng là manh mối: pod không đổi host dù ConfigMap đã đổi. Vậy các site "thành công" thì sao?
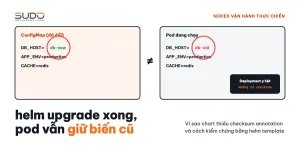
Bước 2: sau khi gộp MySQL, so ConfigMap với env thật trong pod
kubectl -n site-a-example get configmap site-a-example-configmap \
  -o jsonpath='{.data.DB_HOST}'
10.0.1.11                      # db-1, host mới

kubectl -n site-a-example exec deploy/site-a-example -- printenv DB_HOST
10.0.1.13                      # db-old, host cũ

kubectl -n site-a-example get pod -o wide   # cột AGE: pod chưa từng khởi động lại
Bước 3: vì sao helm upgrade không tạo pod mới
Chart nạp cấu hình bằng envFrom:
envFrom:
  - configMapRef:
      name: {{ include "web-ai.fullname" . }}-configmap
  - secretRef:
      name: {{ include "web-ai.fullname" . }}-secret
Biến môi trường chỉ được đọc lúc container khởi động. Kubernetes chỉ tạo pod mới khi pod template của Deployment thay đổi. Đổi dbHost chỉ sửa ConfigMap, còn pod template không có gì khác: không có annotation checksum/config. Vì vậy không có rollout. Lớp lỗi này được phân tích kỹ trong bài helm upgrade không đổi biến môi trường: thiếu checksum annotation.
Pipeline không bắt được lỗi vì check_website chỉ hỏi "site có trả 200 không". Site đang dùng database cũ vẫn trả 200 rất tốt.
Bước 4: rủi ro của bước xoá database cũ khi gộp MySQL
Theo thiết kế, bước cuối xoá database trên host cũ. Nếu bước này chạy trong khi pod còn trỏ về host cũ, site mất database ngay lập tức. Nếu bản gốc còn nguyên, ta mới đồng bộ lại được mà không mất dữ liệu. Vì vậy không bao giờ xoá database cũ trong cùng pipeline chuyển đổi.
Nguyên nhân gốc
- Config đổi, pod không đổi. Chart dùng
envFromnhưng không có checksum annotation. Pipeline gộp MySQL giả địnhhelm upgradeđủ để pod nhận host mới. - Kiểm tra sai thứ. HTTP 200 chứng minh site sống, không chứng minh site đang dùng đúng database.
- Thứ tự bước không an toàn.
helm upgradechạy trướccheck_website, push Git chạy sau, xoá database cũ chạy ngay sau đó. Một bước giữa hỏng là cluster và Git lệch nhau.
Khắc phục
Sửa một đợt gộp MySQL đã chạy
- Đồng bộ lại dữ liệu. Bản trên host mới là snapshot lúc migrate, còn site vẫn ghi vào host cũ suốt từ đó. Với từng site, export lại từ host cũ và import đè sang host đích trước khi restart. Nếu site có lưu lượng ghi lớn, bật chế độ bảo trì trong lúc này.
- Rollout restart từng Deployment, rồi soát lại mọi namespace: pod
1/1 Running,printenv DB_HOSTđúng host đích. - Sửa pipeline, thêm bước restart ngay sau
helm upgrade:- kubectl rollout restart deployment/${RELEASE_NAME} -n $NAMESPACE_WEB - kubectl rollout status deployment/${RELEASE_NAME} -n $NAMESPACE_WEB --timeout=180s - test "$(kubectl -n $NAMESPACE_WEB exec deploy/${RELEASE_NAME} -- printenv DB_HOST)" = "$NEW_DB_HOST"
Lỗi thứ hai lộ ra khi restart: Access denied
Ở một vài site, pod mới đọc đúng host mới nhưng MySQL báo Access denied: mật khẩu trong Secret không khớp mật khẩu của user trên host mới. Nếu init container chạy php artisan migrate --force, nó lỗi liên tục và pod rơi vào CrashLoopBackOff.
Nguyên nhân hay gặp: lệnh tạo user dùng CREATE USER IF NOT EXISTS. Nếu user cùng tên đã có sẵn trên host đích (từ một lần chuyển trước, hoặc dùng chung tên), MySQL giữ mật khẩu cũ, còn values và Secret nhận mật khẩu mới. Cách sửa không đụng tới Kubernetes, chỉ căn lại mật khẩu MySQL theo Secret:
ALTER USER '<user>'@'%' IDENTIFIED BY '<mật-khẩu-đang-có-trong-Secret>';Pod đang CrashLoopBackOff có thể còn báo lỗi thêm vài phút, không phải vì lỗi mới mà vì backoff giãn thời gian giữa các lần thử. Muốn nhanh hơn thì xoá pod để Deployment tạo lại.
Hoàn tất gộp MySQL: đo lại và cho máy cũ nghỉ có chủ đích
- Đo lại máy cũ sau khi restart pod: số kết nối, swap, QPS phải giảm rõ rệt.
- Kiểm tra không còn kết nối nào tới các schema đã chuyển:
SELECT db, COUNT(*) FROM information_schema.processlist GROUP BY db; - Giữ bản gốc vài ngày, rồi mới xoá schema và schema orphan, có ghi nhận.
- Đo lại máy đích (RAM cao nhất trong 7 ngày, swap, dung lượng datadir) để chắc chúng còn dư dưới ngưỡng cảnh báo.
- Tắt máy cũ có chủ đích và gỡ khỏi giám sát, cron, DNS nội bộ cùng lúc. Một máy database tự ngừng mà không có cảnh báo là dấu hiệu bộ cảnh báo còn thiếu.
Checklist cho lần gộp MySQL hay đổi host database tiếp theo
- Thêm
checksum/configvàchecksum/secretvào template Deployment, để mọi lần đổi ConfigMap hay Secret qua Helm đều tự rollout. Lầnhelm upgradeđầu tiên sau khi thêm sẽ restart mọi site, nên chạy theo lô. - Pipeline restart Deployment và chờ
rollout statussau mỗi lần đổi host. - Kiểm tra cuối pipeline là
printenv DB_HOSTtrong pod mới phải bằng host đích, không chỉ là HTTP 200. - Kiểm tra domain resolve được trước khi export, để site có domain hết hạn bị loại từ đầu thay vì dừng giữa chừng.
- Dùng
ALTER USERhoặc kiểm tra user tồn tại thay choCREATE USER IF NOT EXISTS. - Không xoá database cũ trong cùng pipeline; giữ bản gốc vài ngày.
Bài học
- "Config đã đổi" khác "ứng dụng đã dùng config mới". Với
envFrom, chỉ pod mới đọc lại biến môi trường. - Kiểm tra phải trả lời đúng câu hỏi của thay đổi. Đổi database thì kiểm database, không kiểm trang chủ.
- Đo máy cũ là cách phát hiện lỗi rẻ nhất khi gộp MySQL. Một máy vừa mất phần lớn site mà swap còn tăng là tín hiệu đủ để dừng lại.
- Gộp MySQL chưa xong khi pipeline xanh. Nó xong khi máy cũ được đo lại, schema orphan được dọn, và máy được tắt có chủ đích, có ghi nhận.
Tài liệu tham khảo: mẹo tự động rollout Deployment khi ConfigMap đổi của Helm và cú pháp ALTER USER trong MySQL 8.4. Cơ chế push_with_retry có ở bài push_with_retry và bài học GitOps.
Bài tiếp theo
Cron chạy vào máy đã gỡ và error.log MySQL phình to. Những gì còn sót lại quanh các máy database sau đợt gộp MySQL: tác vụ chạy vào hostname không còn tồn tại, và một file log lớn dần vì reverse DNS.