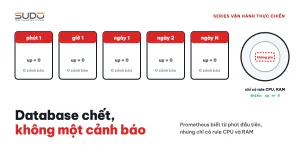
Một máy MySQL ngoài cluster của cụm Kubernetes Website AI (một VPS trên Linode) ngừng trả lời. Prometheus ghi lại chính xác thời điểm đó, up chuyển từ 1 sang 0, nhưng không một cảnh báo Prometheus nào được gửi đi. Đội vận hành chỉ biết nhiều ngày sau, khi tình cờ SSH vào máy và bị timeout. Trường hợp này may mắn: máy vừa được rút hết site trong đợt gộp MySQL cho Website AI, nên không site nào sập. Tài liệu này phân tích vì sao một hệ thống giám sát có đủ dữ liệu vẫn im lặng, và hướng dẫn dựng bộ rule cảnh báo Prometheus tối thiểu (up == 0, absent(), đĩa, MySQL), cách kiểm thử bằng promtool và diễn tập định kỳ.
Triệu chứng: không có triệu chứng
Điểm đáng sợ của loại sự cố này là nó không có tín hiệu nào hướng tới người vận hành:
- Không có tin nhắn, không có email. Kênh cảnh báo Prometheus/Grafana vẫn chỉ nhận các tin "CPU cao", "RAM cao" như thường lệ.
- Dashboard "Node Exporter Full" vẫn hiển thị bình thường. Chọn máy đó thì các đồ thị chỉ dừng lại ở một thời điểm, không có màu đỏ nào.
- Phát hiện hoàn toàn tình cờ:
ssh: connect to host ... port 22: Operation timed out, ping mất 100% gói từ nhiều nơi, cổng 3306 đóng.
Quy trình điều tra
Bước 1: Prometheus có biết không?
Thường là có, và biết rất rõ. Liệt kê target không khoẻ:
curl -s http://127.0.0.1:9090/api/v1/targets | jq -r '.data.activeTargets[]
    | select(.health!="up") | [.labels.instance, .health, .lastError] | @tsv'
db-3   down   Get "http://10.0.1.53:9100/metrics": context deadline exceeded
Truy vấn khoảng thời gian quanh lúc mất tín hiệu để có thời điểm chính xác:
curl -s -G http://127.0.0.1:9090/api/v1/query_range \
    --data-urlencode 'query=up{instance="db-3"}' \
    --data-urlencode start=<RFC3339> --data-urlencode end=<RFC3339> \
    --data-urlencode step=60s
Đếm số mẫu up=1 trong toàn bộ thời gian lưu trữ cũng cho biết máy có chập chờn từ trước không. Dữ liệu đầy đủ, chỉ thiếu cảnh báo Prometheus để báo cho người.
Bước 2: máy chết vì đâu?
Xem các chỉ số cuối cùng trước khi máy ngừng trả lời:
| Chỉ số | Dấu hiệu cần tìm |
|---|---|
node_load1 | Tăng vọt trước khi mất tín hiệu là quá tải |
| RAM đã dùng, swap | Leo dần tới trần là OOM |
Đĩa / | Gần 100% là đầy đĩa |
| CPU steal | Cao là hypervisor tranh CPU |
Mạng nhận eth0 | Còn traffic ứng dụng hay không |
node_boot_time_seconds | Đổi giá trị là có reboot |
Nếu mọi chỉ số đều bình thường rồi biến mất, máy không quá tải mà chỉ đơn giản rời khỏi mạng. Khi đó cần xem console và lịch sử sự kiện của máy trên trang quản trị của nhà cung cấp (với Linode là Cloud Manager), và đối chiếu với các thao tác trên những máy liên quan trong cùng khung giờ. Song song, kiểm tra tác động: còn ConfigMap website nào có DB_HOST trỏ vào máy đó không.
kubectl get configmap -A -o json | jq -r '.items[] | select(.data.DB_HOST=="10.0.1.53") | .metadata.namespace'Bước 3: vì sao cảnh báo Prometheus không bắn?
Câu trả lời thường rất ngắn: không có cảnh báo Prometheus nào để bắn. Đọc cấu hình trên máy giám sát:
prometheus.ymlcórule_filestrống: Prometheus không đánh giá rule nào.- Không cài Alertmanager. Không có
mysqld_exporter, không có blackbox exporter. - Grafana chỉ có rule ngưỡng: CPU > 85% và RAM > 85%, nhóm theo
instance.
Một hướng nghi sai đáng ghi lại: rule Grafana đặt No data → NoData, nên dễ nghĩ máy chết thì không có dữ liệu, rule phải chuyển trạng thái NoData và báo. Thực tế không như vậy. Truy vấn avg by(instance)(...) vẫn trả về series của các máy còn sống. Series của máy chết chỉ biến mất khỏi kết quả. Với Grafana, đó là một instance không còn tồn tại (missing series), không phải "truy vấn không có dữ liệu". Trạng thái NoData chỉ xảy ra khi toàn bộ truy vấn không trả về gì. Một rule đo mức độ bận rộn của máy không bao giờ phát hiện được máy đã chết.
Khoảng trống này hay xuất hiện khi dựng giám sát cho cụm mới bằng cách chép một phần cấu hình cũ: rule ngưỡng được mang theo, rule kiểu min by (instance, job) (up) thì bị bỏ quên. kube-prometheus-stack trong cluster cũng không scrape các VPS bên ngoài nếu không khai báo thêm (bài kube-prometheus-stack: thay monitoring cũ và cấu hình sai âm thầm).
Nguyên nhân gốc
- Giám sát đo "máy có bận không", không đo "máy có sống không".
- Không có cảnh báo Prometheus cho sự vắng mặt: không
up == 0, khôngabsent(), không đếm số target theo vai trò. - Không giám sát dịch vụ: thiếu
mysqld_exporterthì kể cả khi máy sống mà mysqld chết cũng không ai biết. - Không giám sát đĩa bằng xu hướng.
- Chưa từng kiểm thử cảnh báo Prometheus. Không ai từng tắt thử một máy để xem tin nhắn có tới không.
Khắc phục: bộ cảnh báo Prometheus tối thiểu
Ngay lập tức
Nếu chưa có Alertmanager, thêm ngay một rule Grafana up == 0 cho mọi target, gửi cùng kênh hiện có, để không phải chờ dựng xong bộ cảnh báo Prometheus chính thức.
Cảnh báo Prometheus cho tính sẵn sàng và đĩa
Rule viết theo cú pháp alerting rules của Prometheus, đặt trong file riêng và khai báo ở rule_files:
# /etc/prometheus/rules/availability.yml
groups:
- name: availability
  rules:
  - alert: TargetDown
    expr: up == 0
    for: 2m
    labels: {severity: critical}
    annotations:
      summary: "{{ $labels.instance }} không scrape được trong 2 phút"

  # máy bị xoá khỏi danh sách target: up == 0 không bắt được
  - alert: MysqlHostMissing
    expr: count(up{job="node-exporter", role="mysql"}) < 2
    for: 5m
    labels: {severity: critical}

  # máy quan trọng nhất: series up biến mất cũng phải báo
  - alert: MysqlPrimaryMissing
    expr: absent(up{job="node-exporter", instance="db-1"})
    for: 5m
    labels: {severity: critical}

- name: disk
  rules:
  - alert: DiskWillFillIn24h
    expr: predict_linear(node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"}[6h], 24*3600) < 0
    for: 30m
    labels: {severity: warning}
  - alert: DiskAlmostFull
    expr: (1 - node_filesystem_avail_bytes / node_filesystem_size_bytes) * 100 > 85
    for: 15m
    labels: {severity: warning}
up == 0chỉ bắt được target còn trong danh sách. Nếu target bị xoá khỏiprometheus.yml, series biến mất và rule im lặng. Vì vậy cần rule đếm theo nhãnrolehoặcabsent()cho máy quan trọng.for: 2mvớiscrape_interval: 15snghĩa là khoảng 8 lần scrape liên tiếp thất bại mới báo, đủ để bỏ qua một lần mạng chập chờn.predict_linearbáo trước khi đĩa đầy, hữu ích hơn ngưỡng cố định cho máy có log hoặc dump tăng đều.
Cảnh báo Prometheus cho MySQL
Cài mysqld_exporter trên từng máy MySQL, chạy bằng một user chỉ có quyền PROCESS, REPLICATION CLIENT, SELECT:
  - alert: MysqlDown
    expr: mysql_up == 0
    for: 1m
    labels: {severity: critical}
  - alert: MysqlConnectionsHigh
    expr: mysql_global_status_threads_connected / mysql_global_variables_max_connections > 0.8
    for: 10m
    labels: {severity: warning}
Alertmanager hay Grafana Alerting
| Tiêu chí | Prometheus rule + Alertmanager | Grafana Alerting |
|---|---|---|
| Rule lưu ở đâu | File YAML, dễ đưa vào Git và review | Database của Grafana (có thể provision bằng file) |
| Phụ thuộc | Prometheus đánh giá rule ngay cả khi Grafana chết | Grafana chết là mất cảnh báo |
| Gom nhóm, im lặng, ức chế | Mạnh: group_by, silence, inhibit rule | Có notification policy, đủ cho nhu cầu nhỏ |
| Kiểm thử tự động | promtool test rules | Không có công cụ tương đương |
Khuyến nghị: cảnh báo Prometheus về hạ tầng (máy sống, đĩa, MySQL) đi qua Alertmanager vì sống độc lập với Grafana và kiểm thử được. Cảnh báo dựa trên log Loki giữ ở Grafana. Rule Grafana nào chỉ nhắm một máy thì đặt No data → Alerting.
Kiểm thử cảnh báo Prometheus bằng promtool
Một cảnh báo Prometheus chưa từng bắn là một cảnh báo chưa được kiểm chứng. Prometheus có sẵn unit test cho rule, chạy được trong CI trước khi reload:
# tests/availability_test.yml
rule_files: [../rules/availability.yml]
evaluation_interval: 15s
tests:
  - interval: 15s
    input_series:
      - series: 'up{job="node-exporter", role="mysql", instance="db-3"}'
        values: '1 1 1 0x20'          # sống 45 giây rồi chết
    alert_rule_test:
      - eval_time: 1m
        alertname: TargetDown
        exp_alerts: []                # chưa đủ 2 phút, chưa bắn
      - eval_time: 4m
        alertname: TargetDown
        exp_alerts:
          - exp_labels: {severity: critical, job: node-exporter, role: mysql, instance: db-3}
            exp_annotations:
              summary: "db-3 không scrape được trong 2 phút"

$ promtool check rules rules/availability.yml
$ promtool test rules tests/availability_test.yml
Checklist duy trì cảnh báo Prometheus
- Mỗi quý, chọn một máy thử nghiệm, dừng
node_exporter(có duyệt trước), đo thời gian tới lúc cảnh báo Prometheus tới kênh nhận. Mục tiêu dưới 5 phút. - Thêm một cảnh báo "luôn bắn" (
vector(1)) gửi tới dịch vụ heartbeat bên ngoài. Khi chính Prometheus hoặc Alertmanager chết, heartbeat ngừng và bên ngoài báo. - Khi thêm một máy: có target trong Prometheus với nhãn
rolevàcluster, được phủ bởiTargetDown, rule đĩa và rule dịch vụ tương ứng, đã thấy tin cảnh báo thử ít nhất một lần. - Khi gỡ máy: xoá target và cập nhật số lượng dự kiến trong rule đếm theo vai trò, như checklist ở bài Cron chạy vào máy đã gỡ và error.log MySQL phình to.
Bài học
- Có số liệu không có nghĩa là có cảnh báo Prometheus. Prometheus biết máy chết từ phút đầu tiên; thứ thiếu là rule và đường gửi tin.
- Cảnh báo Prometheus theo ngưỡng không phát hiện được sự vắng mặt. Máy chết không có CPU cao, chỉ có series biến mất.
- Cảnh báo Prometheus phải được kiểm thử như code: viết test, chạy trong CI, diễn tập định kỳ.
- May mắn không phải là kế hoạch. Một máy vừa được rút tải thì chết không gây hại, nhưng cùng khoảng trống đó sẽ không may mắn ở lần sau.
Bài tiếp theo
Redis đầy, crawler và liveness probe: khi cơ chế tự bảo vệ gây hại. Hai sự cố trên hai hạ tầng khác nhau, và vì sao một liveness probe "không kiểm tra database" vẫn có thể restart hàng loạt website.