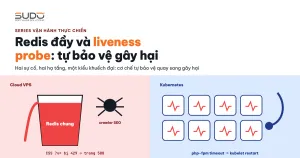
Tài liệu này phân tích hai tình huống điển hình trên hai hạ tầng khác nhau. Trên Cloud VPS, một lượt quét SEO nội bộ làm một website thương mại điện tử trả hàng loạt lỗi 500, kéo theo Redis dùng chung của nhiều site đầy bộ nhớ. Trên cụm Kubernetes Website AI, liveness probe thất bại hàng loạt và kubelet restart nhiều website trong vòng vài chục giây. Hai sự cố không liên quan nhân quả, nhưng có cùng một kiểu khuếch đại: một cơ chế tự bảo vệ (rate limit ở tình huống đầu, liveness probe ở tình huống sau) quay sang làm hại chính hệ thống nó bảo vệ. Bài trình bày cách điều tra, cấu hình sửa và cách thiết kế liveness probe đúng.
Tổng quan hai tình huống
| Tình huống 1: Redis đầy và crawler | Tình huống 2: liveness probe | |
|---|---|---|
| Hạ tầng | Cloud VPS: balancer, một minion PHP, máy Redis dùng chung | Cluster LKE (Linode) của Website AI |
| Ảnh hưởng | Một site trả 500; balancer trả 429; Redis chạm trần, evict cache của các site khác | Liveness probe fail, nhiều container website bị restart trên nhiều node; trong lúc khởi động lại, site không phục vụ được |
| Phát hiện | Log Laravel phình bất thường trong ngày | Đọc lastState của container khi khảo sát cluster |
Điều tra tình huống 1: Redis đầy và crawler
Ai đang gọi?
Gom access log của balancer quanh khung giờ lỗi theo IP nguồn và User-Agent:
awk -F'"' '{split($1,a," "); print a[1], $6}' site-a.example.access \
  | sort | uniq -c | sort -rn | head
Kết quả điển hình: một nhóm request từ IP văn phòng với User-Agent Screaming Frog SEO Spider (lượt quét SEO chủ động), và một nhóm còn lớn hơn đến từ IP public của chính minion chứa site, User-Agent rỗng. Phần lớn 429 rơi vào nhóm thứ hai.
Minion gọi ngược vào chính site qua Internet là điều không nên có. Log Laravel giải thích: lỗi file_get_contents(https://site-a.example/assets/css/...min.css?v=...) nhận 429. Một số view Blade inline CSS bằng cách tải file CSS qua URL public của chính site:
echo file_get_contents(asset('/assets/css/desktop/post.min.css?v='.config('assets.version')));Mỗi trang render lại gọi vài file CSS, theo đường minion → Internet → balancer → minion, tất cả từ cùng một IP.
Vì sao CSS bị rate limit?
Balancer có zone rate limit riêng cho site, dùng map để bỏ qua file tĩnh, theo cách ở bài fail2ban và limit_req: chỉ giới hạn request động:
map $request_uri $site_a_dynamic_key {
    default                                      $binary_remote_addr;
    ~*\.(css|js|mjs|json|woff2?|ttf|otf|eot)$  "";
}
limit_req_zone $site_a_dynamic_key zone=site_a_dynamic:10m rate=300r/m;
$request_uri giữ nguyên query string. /general.min.css?v=1.2.3 không khớp \.css$, nên CSS có version bị tính như request động. Lượng CSS tự gọi từ một IP duy nhất vượt ngưỡng, balancer trả 429, file_get_contents ném exception, trang trả 500.
Vì sao nhiều trang render cùng lúc, và Redis đầy
Dựng dòng thời gian từ Prometheus (redis_exporter trên máy Redis và node_exporter trên minion): CPU minion, bộ nhớ Redis, số key cache của site. Mẫu hình hay gặp:
- Ứng dụng xoá toàn bộ response cache (Spatie ResponseCache trên Redis, xem bài Laravel ResponseCache, Redis và Supervisor) mỗi khi admin lưu một bản ghi bất kỳ.
- Ngay sau đó, crawler SEO quét cả site. Hầu hết trang MISS, CPU minion tăng vọt, và mỗi trang MISS lại tự gọi CSS.
- Mỗi trang cache nặng hàng trăm KiB vì HTML chứa CSS inline. Redis dùng chung với
maxmemorycố định và chính sáchallkeys-lfuđầy lại rất nhanh, rồi evict key, có thể là cache của các site khác.
redis-cli -n 0 INFO memory | grep -E 'used_memory_human|maxmemory_human'
redis-cli INFO stats | grep evicted_keys
redis-cli -n 13 --scan --pattern 'responsecache*' | wc -l
Điều tra tình huống 2: liveness probe restart hàng loạt
Liveness probe fail cùng lúc, trên nhiều node
Đọc lastState.terminated của mọi container trong cluster, lọc theo một khung thời gian:
kubectl get pods -A -o json | jq -r '.items[] | .metadata.namespace as $ns
    | .status.containerStatuses[]? | select(.lastState.terminated != null)
    | [$ns, .lastState.terminated.reason, .lastState.terminated.exitCode,
       .lastState.terminated.finishedAt] | @tsv' | sort -k4
Nếu nhiều container kết thúc trong cùng vài chục giây với Completed/0, đó không phải OOM: tiến trình chính thoát êm sau khi nhận SIGTERM, kiểu kết thúc điển hình khi liveness probe fail và kubelet chủ động dừng container. Log trước khi restart (kubectl logs --previous) thường có mẫu:
WARNING: [pool www] child ..., script '/var/www/html/public/index.php'
    (request: "GET /index.php") execution timed out (34.4 sec), terminating
WARNING: [pool www] child ..., script '/var/www/html/public/index.php'
    (request: "GET /index.php") execution timed out (39.4 sec), terminating
WARN received SIGTERM indicating exit request
Cứ khoảng 10 giây lại có một request PHP bị PHP-FPM giết sau 30–40 giây, đúng nhịp của readiness probe (periodSeconds: 10). Metric prober_probe_total của kubelet xác nhận số probe thất bại tăng vọt, cả readiness probe lẫn liveness probe.
Đi tìm phụ thuộc chung
Giả thuyết đầu tiên là một phụ thuộc chung bị chậm. Đối chiếu các site bị restart theo node, máy MySQL, máy NFS, rồi xem sar (CPU, iowait) của từng máy trong khung giờ đó. Nếu các site rải trên nhiều node, nhiều máy MySQL và NFS khác nhau, không máy nào quá tải, và cả vài pod trong namespace monitoring cũng fail probe, thì vấn đề nhiều khả năng ở mức rộng hơn (mạng, node). Khi log ingress của khung giờ đó đã bị xoay mất, hãy ghi rõ nguyên nhân kích hoạt là chưa xác định, thay vì đoán.
Hai tình huống trùng thời gian cũng không có nghĩa là cùng nguyên nhân. Website trong cluster dùng CACHE_DRIVER=file, không dùng Redis của Cloud VPS, và không đi qua balancer của Cloud VPS.
Nguyên nhân gốc
Tình huống 1
- View tự tải tài nguyên của chính site qua HTTP, biến mỗi lượt render thành vài request ra Internet và quay lại.
map $request_urithay vì$uri: file tĩnh có query string bị rate limit.- Xoá toàn bộ cache cho mỗi lần sửa: mỗi lần admin lưu là một đợt "thundering herd".
- Redis dùng chung, một site chiếm phần lớn bộ nhớ vì cache cả trang nặng.
Tình huống 2: liveness probe đi qua cả ứng dụng
Ở bài Helm chart với NFS PersistentVolume tĩnh, claimRef và ba loại probe, /liveness được thiết kế để không đụng database. Code route đúng là chỉ trả 200:
Route::get('/liveness', function () {
    return response()->json(['status' => 'OK'], 200);
});
Nhưng request đó vẫn đi qua nginx → PHP-FPM → toàn bộ quá trình khởi động Laravel và nhóm middleware web (cookie, session file) trước khi tới route. Khi worker PHP đang kẹt hoặc bootstrap chậm vì một lý do bên ngoài, liveness probe chậm theo y như trang thật. Với thông số periodSeconds: 30, timeoutSeconds: 5, failureThreshold: 3, ba lần không trả lời trong 5 giây là kubelet giết container. Liveness probe khi đó vẫn kiểm tra gián tiếp mọi thứ mà ứng dụng phụ thuộc.
Restart container không chữa được nguyên nhân bên ngoài. Nó còn thêm tải: mỗi lần khởi động, container chạy initContainer (migrate, optimize:clear), postStart copy code và kéo lại image nếu imagePullPolicy: Always.
Khắc phục
Tình huống 1: sửa rate limit và cách tải CSS
Đổi khoá rate limit sang $uri và miễn giới hạn cho IP quét SEO nội bộ, giữ nguyên tên biến của zone đang chạy để nginx reload được:
geo $site_a_whitelist { default 0; <ip-van-phong> 1; }
map $uri $site_a_dynamic_key_base {
    default                                      $binary_remote_addr;
    ~*\.(css|js|mjs|json|woff2?|ttf|otf|eot)$  "";
    ~*\.(jpg|jpeg|png|gif|svg|ico|webp|avif)$   "";
}
map $site_a_whitelist $site_a_dynamic_key { 1 ""; default $site_a_dynamic_key_base; }
Thêm IP văn phòng vào ignoreip của fail2ban. Sau nginx -t và reload, thử nhiều request song song tới một file CSS có ?v= từ IP ngoài danh sách: phải trả 200, không còn 429. Cơ chế limit_req xem ở tài liệu ngx_http_limit_req_module.
Ở tầng ứng dụng: đọc CSS bằng public_path() hoặc dùng thẻ <link> thay cho file_get_contents(asset()); xoá cache theo URL thay vì toàn bộ; tách Redis cho site lớn hoặc giảm kích thước trang cache; đặt tốc độ quét Screaming Frog khoảng 5–10 URL/giây.
Tình huống 2: thiết kế lại liveness probe
Theo hướng dẫn probe của Kubernetes, liveness probe chỉ nên trả lời "tiến trình còn sống không":
- Liveness probe dùng
ping.pathcủa PHP-FPM (ví dụ/fpm-ping, chỉ cho phép từ localhost), không đi qua Laravel. Nó vẫn cần một worker rảnh, nhưng không phụ thuộc bootstrap, session hay database. - Nới thông số liveness probe: tổng thời gian chịu lỗi (
periodSeconds × failureThreshold) phải dài hơn timeout của một request PHP. - Giữ kiểm tra database ở readiness: pod bị rút khỏi Service khi database chậm, không bị restart.
# php-fpm pool
ping.path = /fpm-ping
ping.response = pong

# nginx trong container
location = /fpm-ping { allow 127.0.0.1; deny all; include fastcgi_params; fastcgi_pass 127.0.0.1:9000; }

# Deployment
livenessProbe:
  httpGet: {path: /fpm-ping, port: 80}
  periodSeconds: 20
  timeoutSeconds: 5
  failureThreshold: 6        # khoảng 2 phút
Checklist phòng ngừa
- Cảnh báo cho Redis dùng chung:
redis_memory_used_bytes / redis_config_maxmemory > 0.9vàrate(redis_evicted_keys_total[5m]) > 5. - Cảnh báo khi số container restart trong 5 phút vượt ngưỡng trên toàn cluster, kèm lý do (OOMKilled hay liveness probe fail).
- Mỗi chart mới phải trả lời được câu hỏi: liveness probe của nó đi qua những thành phần nào trước khi trả 200?
- Giữ log ingress đủ lâu (gom về Loki có retention) để lần sau đối chiếu được.
- Lượt quét SEO nội bộ có lịch, có giới hạn tốc độ, và không chạy ngay sau khi cache vừa bị xoá.
- Review code: cấm view gọi HTTP tới chính site của nó.
Bài học
- "Liveness probe không kiểm tra database" phải đúng ở cả đường đi của request, không chỉ ở nội dung route.
- Cơ chế tự bảo vệ có thể khuếch đại sự cố: rate limit chặn chính minion, liveness probe giết container đang chờ phụ thuộc hồi lại. Một liveness probe quá nhạy còn nguy hiểm hơn không có liveness probe.
- Hai sự cố trùng thời gian không có nghĩa là cùng nguyên nhân. Đối chiếu hạ tầng, giờ UTC và phụ thuộc trước khi gộp chúng làm một.
- Ghi "chưa xác định" khi chưa xác định. Đoán bừa nguyên nhân sẽ dẫn tới sửa sai chỗ.
Bài tiếp theo
API nội bộ đi vòng qua Cloudflare: lỗi đồng bộ khó phát hiện. Các hệ thống nằm chung mạng private nhưng gọi API cho nhau qua domain public, và một chặng mạng ngoài tầm kiểm soát làm hỏng cả luồng đồng bộ.