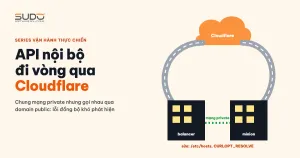
Một kiến trúc rất hay gặp khi hệ thống lớn dần: ứng dụng trung tâm và các website vệ tinh nằm chung một mạng private, nhưng gọi API cho nhau qua domain public, tức là đi vòng ra Internet, qua Cloudflare rồi mới quay về balancer. Mọi thứ chạy tốt cho tới khi chặng public đó suy giảm theo từng đợt: bảng theo dõi đồng bộ hiện lỗi timeout, dữ liệu giữa trụ sở và cửa hàng chậm, trang sản phẩm treo, trong khi mạng private vẫn chạy hoàn hảo. Tài liệu này hướng dẫn cách khoanh vùng loại lỗi này bằng cách ghép từng request giữa nhiều nguồn log, loại trừ từng giả thuyết, đối chứng với một balancer khác, và vì sao giải pháp là kéo API nội bộ ra khỏi Cloudflare.
Bối cảnh và triệu chứng
Ví dụ trong bài là một hệ thống bán lẻ nhiều cửa hàng trên Cloud VPS cùng một datacenter: ứng dụng quản lý bán hàng trung tâm (gọi là HQ) và các website cửa hàng nằm sau balancer A; website bán hàng chính nằm sau balancer B và gọi API tồn kho, đơn hàng của HQ. Cả hai balancer đều đứng sau Cloudflare, và balancer B sẽ được dùng làm đối chứng.
Kiểm tra toàn cảnh thường thấy nhiều luồng bị ảnh hưởng hơn phần hiện trên dashboard:
- HQ → cửa hàng: lỗi trên dashboard, dữ liệu khách hàng chậm đồng bộ.
- Cửa hàng → HQ: phiếu thu, hoá đơn, đơn hàng, tồn kho chậm về HQ.
- Website bán hàng → HQ: trang sản phẩm gọi API đồng bộ trong lúc render, khách bị treo tới hết timeout.
- Người dùng → Cloudflare → balancer A: tỷ lệ 499 (client bỏ cuộc) tăng rõ trong các phút lỗi.
Các nguồn gọi có cùng một phân bố lỗi cURL: phần lớn là cURL 28: Operation timed out ... with 0 bytes received, tiếp đến Connection timed out, và một ít Recv failure: Connection reset by peer.
Quy trình điều tra
Bước 1: lỗi rải đều hay theo đợt?
Gom lỗi theo phút. Ở loại sự cố này, lỗi đến theo đợt, mỗi đợt từ một phút tới gần nửa giờ, và trong cùng một phút request tới nhiều cửa hàng thuộc nhiều PHP-FPM pool khác nhau cùng thất bại. Điều đó gợi ý nguyên nhân nằm ở chặng chung, không phải ở từng site.
Bước 2: ghép từng request giữa ba nguồn log
Phương pháp chính là theo dấu từng request lỗi qua ba nơi, dùng ID của bản ghi đồng bộ làm khoá: log Laravel bên gửi, log Laravel bên nhận (dòng Webhook | received và UPSERTED ... tmp_key), và access log của balancer (ghi khi đã trả xong response). Điều kiện tiên quyết: đồng hồ các máy đồng bộ NTP. Kết quả thường chia làm hai nhóm:
- Nhóm 1: bên nhận đã xử lý xong, nhưng response không về tới bên gửi. PHP nhận request sau một hai giây, xử lý trong vài chục mili giây, balancer ghi đã trả xong, vậy mà bên gửi vẫn timeout.
- Nhóm 2: request không tới được origin. Không có dấu vết ở balancer lẫn PHP; bên nhận chỉ thấy lần retry sau đó.
[T+0s]   INFO:  [SyncWebhook] UPSERTED customers | tmp_key: 1_298553          (cửa hàng)
[T+13s]  ERROR: [SyncService] sendTo CONNECT_ERROR
    | URL: https://store-02.example/... | cURL error 28: Operation timed out after 15000 milliseconds   (HQ)
Lưu ý: có request báo Connection timed out nhưng PHP vẫn nhận được rất nhanh, nên thông báo đó của curl không dùng một mình để khoanh vùng được.
Bước 3: loại trừ những nghi phạm quen thuộc
Nghi phạm đầu tiên thường là PHP-FPM chạm max_children, nhất là khi minion cửa hàng nhỏ mà gánh nhiều pool. Kiểm tra bằng cách đối chiếu: request lỗi có cảnh báo max_children đúng pool đó trong ±10 phút không, và số lần chạm max_children theo ngày có cùng chiều với số lỗi đồng bộ không. Nếu phần lớn request lỗi không có cảnh báo tương ứng, và hai chuỗi số đi ngược chiều, loại giả thuyết này.
Các giả thuyết khác loại bằng số liệu Prometheus một phút một mẫu đúng các phút lỗi:
- CPU balancer, minion, database thấp; CPU steal gần 0. Khác hẳn tình huống ở bài CPU 100% ảo do hypervisor.
- Gói tin vào balancer bằng mức nền; NIC không có lỗi hay drop; không OOM, không
ListenOverflows, không SYN cookies. - conntrack chưa bao giờ đầy (
early_drop=0); firewall không có rule giới hạn; error log nginx không cóupstream timed out. - Mạng private ổn định: Prometheus scrape qua đó không mất mẫu nào.
nstat -az | grep -E 'ListenOverflows|ListenDrops|SyncookiesSent'
cat /proc/sys/net/netfilter/nf_conntrack_count /proc/sys/net/netfilter/nf_conntrack_max
ip -s link show eth0
Bước 4: đối chứng với một balancer khác cũng sau Cloudflare
Khi các nguồn gọi thuộc nhiều dải IP khác nhau mà đều lỗi cùng lúc, điểm chung duy nhất là đích nằm sau balancer A. Để biết lỗi nằm ở Cloudflare nói chung hay riêng đường vào balancer A, so sánh lưu lượng người dùng thật của balancer A với balancer B (cùng datacenter, cùng đi qua Cloudflare) trong các phút lỗi so với nền xung quanh: tỷ lệ lưu lượng phút lỗi/nền và tỷ lệ 499. Nếu chỉ balancer A tụt lưu lượng và tăng 499, sự cố nằm trên đường đi vào balancer A, ảnh hưởng cả người dùng thật, không phải sự cố chung của Cloudflare hay của cả datacenter.
Bước 5: thông tin bên ngoài, và giới hạn của điều tra
- Đối chiếu lịch sử sự cố của Cloudflare và thông báo bảo trì của nhà cung cấp VPS. Trùng thời gian chưa phải là bằng chứng.
- Từ trong hạ tầng, thường không xác định được chặng lỗi là Cloudflare → IP public của balancer hay uplink của nhà cung cấp cho riêng IP đó. Muốn biết cần số liệu Cloudflare Analytics của các zone (tỷ lệ 52x, origin response time) và mở ticket với nhà cung cấp kèm các khung giờ lỗi.
Nguyên nhân gốc
| Tầng | Nội dung |
|---|---|
| Tác nhân kích hoạt | Chặng public giữa Cloudflare và balancer suy giảm theo đợt: kết nối chậm, response kẹt, reset. Nguồn gốc nằm ngoài hạ tầng của mình |
| Gốc rễ (kiến trúc) | Lượng lớn lời gọi API mỗi ngày giữa các máy chung mạng private lại đi qua domain public, Internet và Cloudflare. Luồng nội bộ phụ thuộc hoàn toàn vào một chặng không kiểm soát được |
| Yếu tố khuếch đại (code) | Hàm gửi đồng bộ dùng một timeout chung cho cả kết nối và đọc, không có connect_timeout, không retry ngắn. Website bán hàng gọi API ngay khi render trang |
| Không phải nguyên nhân | PHP-FPM max_children, tài nguyên server, nginx, firewall, conntrack, database, mạng private |
Về an toàn dữ liệu: nếu mọi endpoint nhận đồng bộ đều upsert theo khoá (tmp_key), không cộng trừ số lượng, thì request nhóm 1 (đã ghi nhưng bị coi là lỗi rồi gửi lại) không gây trùng dữ liệu, chỉ tốn thêm request và báo lỗi giả. Hãy kiểm tra điều này trước khi bật retry.
Khắc phục
Nhanh: ánh xạ domain sang IP private của balancer
Nếu balancer lắng nghe 443 trên mọi interface, gọi thẳng IP private vẫn đúng chứng chỉ (giữ nguyên tên domain, SNI không đổi). Thử từ mọi nhóm máy gọi: ssl_verify_result=0, thời gian kết nối dưới 1 ms thay vì hàng trăm mili giây khi đi qua Cloudflare. Kiểm tra xác thực webhook không phụ thuộc IP nguồn. Nếu máy không chạy cache DNS và nsswitch là files dns, /etc/hosts có hiệu lực ngay:
# trên minion HQ (backup trước)
cp /etc/hosts /root/backup_hosts_$(date +%Y%m%d)
cat >> /etc/hosts <<'EOF'
# gọi API nội bộ qua balancer A, không đi vòng qua Cloudflare
10.0.0.24 store-01.example store-02.example store-03.example
EOF

getent hosts store-02.example                       # phải ra 10.0.0.24
curl -sI https://store-02.example | grep -i server  # không còn "server: cloudflare"
Rollback là chép lại file backup. Cái giá là bảo trì tay: thêm hoặc chuyển cửa hàng thì phải sửa /etc/hosts.
Bền vững: cấu hình trong code
Đưa IP nội bộ vào biến môi trường và dùng CURLOPT_RESOLVE để ép phân giải, kèm timeout tách riêng:
// config/sync.php
'internal_ip' => env('SYNC_INTERNAL_IP'),   // để trống = đi DNS public như cũ

$host = parse_url($url, PHP_URL_HOST);
$options = ['connect_timeout' => 3, 'timeout' => 15];
if ($ip = config('sync.internal_ip')) {
    $options['curl'] = [CURLOPT_RESOLVE => ["{$host}:443:{$ip}"]];
}- Retry 1–2 lần với backoff 1–2 giây cho lỗi cURL 28, 35, 56 trước khi ghi nhận lỗi, chỉ khi bên nhận upsert theo khoá.
- Website bán hàng: cache kết quả tồn kho và đơn mới 30–60 giây, giảm timeout, để trang không treo khi API chậm.
Bỏ Cloudflare khỏi đường API nội bộ giải quyết các luồng máy-gọi-máy và lỗi giả "đã ghi nhưng báo lỗi". Nó không giải quyết luồng người dùng thật vẫn đi qua Cloudflare; phần đó cần làm rõ với Cloudflare và nhà cung cấp.
Checklist phòng ngừa
- Quy tắc kiến trúc: máy chủ gọi máy chủ trong cùng mạng private thì đi mạng private. Cloudflare dành cho người dùng từ Internet.
- Log đủ để khoanh vùng: thêm
$request_timevà$upstream_response_timevàolog_formatcủa balancer. - Probe chủ động hai đường: từ máy giám sát, gọi cùng một endpoint qua Cloudflare và qua IP private, so sánh độ trễ và tỷ lệ lỗi. Chênh lệch đột ngột là dấu hiệu chặng public có vấn đề.
- Bảo vệ origin: giới hạn cổng 80/443 trên IP public của balancer chỉ cho dải IP của Cloudflare và mạng private. Trước khi siết, chuyển mọi domain còn trỏ thẳng vào IP này sang Cloudflare.
- Code gọi API luôn có
connect_timeoutriêng, retry có giới hạn và cache khi có thể, như mọi lời gọi mạng trong request path.
Bài học
- Gọi API nội bộ qua Cloudflare là thêm một phụ thuộc không cần thiết. Mạng private chạy tốt suốt sự cố, nhưng không luồng nào dùng nó.
- Ghép từng request giữa nhiều nguồn log phân biệt được "không tới" với "tới rồi nhưng không về", điều mà thông báo lỗi của curl không nói đúng.
- Đối chứng là công cụ khoanh vùng rẻ nhất. Một balancer cùng datacenter, cùng Cloudflare, không bị ảnh hưởng, loại ngay giả thuyết "Cloudflare sập".
- Thừa nhận giới hạn. Từ trong hạ tầng không thấy được chặng giữa Cloudflare và nhà cung cấp; kết luận phải ghi "chưa xác định" cho tới khi có số liệu từ hai bên.
Bài tiếp theo
Checklist bảo trì hạ tầng và quản lý nợ kỹ thuật. Bài kết của Series 3 và của cả bộ ba series: những việc cần làm hằng ngày, hằng tuần, hằng tháng, hằng quý, và cách quản lý nợ kỹ thuật.