Một cửa hàng cần biết doanh số 28 ngày tới để nhập hàng và xếp ca nhân viên. Dữ liệu là một cột doanh số theo ngày trong ba năm. Đó là bài toán dự báo chuỗi thời gian (time series forecasting). Điểm khác biệt so với các bài toán học máy trước là dữ liệu có thứ tự, nên mọi bước chia dữ liệu, tạo đặc trưng, đánh giá đều phải tôn trọng mũi tên thời gian. Bài này đi từ các baseline đơn giản, qua ARIMA và SARIMA, tới gradient boosting với đặc trưng lag, trên dữ liệu giả lập 1.096 ngày, kèm output thật và cả những kết quả không như dự đoán.
Bài nối tiếp Phát hiện bất thường trong giao dịch: Isolation Forest và autoencoder, nơi các giao dịch được coi là độc lập; ở đây giả định đó không còn đúng. Phần gradient boosting dùng lại LightGBM từ Gradient boosting với XGBoost và LightGBM: khi nào thắng deep learning và cách chọn chỉ số từ Đánh giá mô hình phân loại: precision, recall, ROC và dữ liệu lệch. Môi trường chạy lại: Apple M4, 16 GB, CPU, Python 3.10, pandas 2.0.2, NumPy 1.25.0, scikit-learn 1.3.0, statsmodels 0.14.0, LightGBM 3.3.5. Chuỗi thời gian hoàn toàn giả lập, không phải doanh số thật.
Dữ liệu chuỗi thời gian doanh số giả lập
Ta tạo chuỗi thời gian doanh số ngày từ 01/01/2020 đến 31/12/2022 bằng cách nhân các thành phần: xu hướng tăng đều (100 cộng 0,08 mỗi ngày), mùa vụ tuần (thứ Bảy và Chủ nhật cao hơn 25 đến 30%), mùa vụ năm (dao động 15%), khuyến mãi vào ngày 15 và ngày cuối tháng (tăng 35%), và nhiễu Gaussian. Đây là hình dạng quen thuộc của dữ liệu bán lẻ, và vì ta biết công thức sinh nên có thể kiểm tra mô hình nào học được phần nào.
trend = 100 + 0.08 * t
promo = ((idx.day.to_numpy() == 15) | idx.is_month_end).astype(int)
sales = trend * weekly * yearly * (1 + 0.35 * promo) + noise
s = pd.Series(sales.round(1), index=idx, name=doanh_so_trieu)
[Dữ liệu] 1096 ngày, từ 2020-01-01 đến 2022-12-31
count    1096.0
mean      155.7
std        41.1
min        72.5
25%       125.0
50%       151.6
75%       180.1
max       346.9
Đánh giá chuỗi thời gian: không xáo trộn dữ liệu
Khi đánh giá chuỗi thời gian, quy tắc số một là dữ liệu kiểm tra phải nằm sau dữ liệu huấn luyện. Sách Forecasting: Principles and Practice của Hyndman và Athanasopoulos mô tả quy trình rolling forecasting origin: mỗi tập huấn luyện chỉ gồm quan sát trước điểm kiểm tra, rồi lấy trung bình sai số qua nhiều điểm cắt. Trong scikit-learn, TimeSeriesSplit làm điều tương tự: ở lần chia thứ k, tập huấn luyện là k khối đầu và tập kiểm tra là khối k+1, các tập huấn luyện sau là tập chồng của tập trước; tham số test_size cố định độ dài kiểm tra, gap chừa khoảng trống giữa hai tập.
Về chỉ số cho chuỗi thời gian, ngoài MAE, RMSE và MAPE, ta dùng MASE (mean absolute scaled error). Theo sách trên, MASE chia sai số cho MAE của một phương pháp baseline (ở đây là seasonal naive với chu kỳ m = 7) tính trên tập huấn luyện, nên không phụ thuộc đơn vị: MASE nhỏ hơn 1 nghĩa là tốt hơn sai số seasonal naive trung bình ngay trên dữ liệu huấn luyện. MAPE sẽ méo khi có ngày doanh số gần 0, còn MASE không bị vấn đề đó.
Baseline chuỗi thời gian: bốn phương pháp đơn giản nhất
Cũng theo chương phương pháp đơn giản của Hyndman và Athanasopoulos, có bốn baseline: mean (mọi dự báo bằng trung bình lịch sử), naive (bằng giá trị cuối cùng), seasonal naive (bằng giá trị cùng thời điểm của chu kỳ trước, ví dụ cùng thứ trong tuần trước) và drift (đường thẳng từ quan sát đầu tới cuối kéo dài ra). Mỗi baseline cho chuỗi thời gian chỉ vài dòng NumPy:
out["Mean"] = np.full(h, train.mean())
out["Naive"] = np.full(h, train.iloc[-1])
out["Seasonal naive (m=7)"] = np.tile(train.iloc[-7:].to_numpy(), h // 7 + 1)[:h]
out["Drift"] = train.iloc[-1] + np.arange(1, h + 1) * (train.iloc[-1] - train.iloc[0]) / (len(train) - 1)
Baseline là thước đo trung thực khi dự báo chuỗi thời gian: một mô hình không thắng seasonal naive thì không đáng đưa vào sản xuất. Với dữ liệu có mùa vụ tuần rõ như doanh số bán lẻ, seasonal naive là đối thủ đáng gờm, và ta sẽ thấy nó thắng nhiều mô hình "cao cấp" hơn.
ARIMA cho chuỗi thời gian: dừng, sai phân và mùa vụ
ARIMA(p, d, q) kết hợp ba thứ: tự hồi quy bậc p (giá trị hiện tại phụ thuộc p giá trị trước), sai phân bậc d để làm chuỗi dừng, và trung bình trượt bậc q của sai số. Theo tài liệu statsmodels, tham số order là bộ (p, d, q) còn seasonal_order là bộ (P, D, Q, s) với s là chu kỳ mùa vụ (phải lớn hơn 1). Trước khi chọn d, ta kiểm tra tính dừng của chuỗi thời gian bằng kiểm định Dickey-Fuller mở rộng (ADF), có giả thuyết gốc là chuỗi có nghiệm đơn vị (không dừng):
[ADF trên chuỗi gốc] p-value = 0.3130
[ADF sau sai phân bậc 1] p-value = 1.71e-07
[ADF sau sai phân mùa vụ lag 7] p-value = 1.16e-03
Chuỗi gốc có p-value 0,313: không bác bỏ được giả thuyết không dừng, như kỳ vọng với chuỗi có xu hướng tăng. Sau sai phân bậc 1 p-value còn 1,71e-07: chuỗi dừng, nên d = 1. Ta thử hai mô hình ARIMA cho chuỗi thời gian này trên mốc cắt 03/12/2022 (train 1.068 ngày, dự báo 28 ngày kế tiếp): ARIMA(2, 1, 2) không có mùa vụ và SARIMA(1, 1, 1)(1, 1, 1, 7) có mùa vụ tuần. Trong code, ARIMA chỉ là một dòng:
from statsmodels.tsa.arima.model import ARIMA
from statsmodels.tsa.statespace.sarimax import SARIMAX
arima = ARIMA(train, order=(2, 1, 2)).fit().forecast(28)
sarima = SARIMAX(train, order=(1, 1, 1), seasonal_order=(1, 1, 1, 7)).fit(disp=False).forecast(28)
Kết quả dự báo chuỗi thời gian trên một mốc cắt
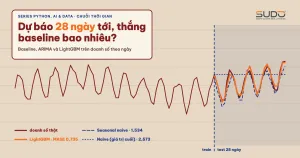
[Một mốc cắt] train đến 2022-12-03 (1068 ngày), test 2022-12-04 → 2022-12-31 (28 ngày), chạy tất cả mô hình mất 4.4 giây
  Mẫu số MASE = MAE seasonal naive m=7 trên train = 13.34
  mô hình | MAE | RMSE | MAPE% | MASE
  LightGBM (lịch + lag ≥ 28)        9.81   12.52   5.52  0.735
  SARIMAX + biến khuyến mãi        10.08   12.88   5.65  0.756
  SARIMA(1,1,1)(1,1,1,7)           10.30   19.66   5.22  0.773
  Seasonal naive (m=7)             20.45   34.08  11.71  1.534
  ARIMA(2,1,2)                     25.35   32.36  14.12  1.901
  Mean                             26.42   37.72  13.46  1.981
  Naive (giá trị cuối)             34.31   40.24  21.43  2.573
  Drift                            34.87   40.95  21.89  2.615
Ba điểm đáng đọc kỹ. Thứ nhất, ARIMA không mùa vụ (MASE 1,901) thua cả seasonal naive (1,534): nó bỏ qua chu kỳ tuần, và dự báo nhiều bước của ARIMA hội tụ về một đường gần phẳng. Khi thêm thành phần mùa vụ, SARIMA giảm MASE xuống 0,773. Thứ hai, naive và drift tệ nhất (MASE trên 2,5) vì doanh số cuối tuần và ngày thường lệch nhau tới 30%, nên "giá trị cuối" phụ thuộc hôm cuối cùng của train rơi vào thứ mấy. Thứ ba, ba mô hình đầu bảng chênh nhau rất ít (0,735, 0,756, 0,773), và chỉ trên 28 ngày thì khác biệt đó nằm trong vùng nhiễu; ta cần nhiều mốc cắt mới kết luận được.
Gradient boosting cho chuỗi thời gian: đặc trưng lịch và lag
Cây quyết định không có khái niệm thời gian, nên ta phải biến chuỗi thời gian thành bảng: mỗi dòng là một ngày, cột là các đặc trưng. Hai nhóm hữu ích: đặc trưng lịch (thứ trong tuần, ngày trong tháng, tháng, ngày có khuyến mãi) và đặc trưng trễ (lag: giá trị của chính chuỗi trước đó, trung bình trượt). Điều kiện sống còn là mọi lag phải lớn hơn hoặc bằng horizon dự báo. Muốn dự báo 28 ngày thì chỉ được dùng lag từ 28 ngày trở lên, vì khi dự báo ngày thứ 20 ta chưa biết doanh số ngày thứ 19:
def make_features(series, min_lag=28):
    d = pd.DataFrame({"y": series})
    d["dow"] = d.index.dayofweek
    d["dom"] = d.index.day
    d["month"] = d.index.month
    d["is_promo"] = ((d.index.day == 15) | d.index.is_month_end).astype(int)
    d["lag28"] = d["y"].shift(min_lag)
    d["lag35"] = d["y"].shift(min_lag + 7)
    d["roll28_28"] = d["y"].shift(min_lag).rolling(28).mean()
    return d
Cách dự báo chuỗi thời gian này gọi là dự báo trực tiếp (direct): một mô hình cho cả horizon, thay vì dự báo từng bước rồi nạp lại kết quả vào làm lag (recursive) vốn dễ tích luỹ sai số. Độ quan trọng (gain) của LightGBM cho thấy mô hình dựa chủ yếu vào lag, đúng như dự đoán vì lag28 và lag35 cùng thứ trong tuần với ngày cần dự báo:
  Độ quan trọng LightGBM (gain, % tổng):
lag28        48.6
lag35        31.6
is_promo     10.0
month         5.1
roll28_28     2.3
dow           1.7
dom           0.7
is_promo chiếm 10%: cây nhận ra hiệu ứng khuyến mãi mà ARIMA thuần không có. Để công bằng, ta cũng thêm một mô hình SARIMAX với exog là biến khuyến mãi (biết trước cho tương lai, như lịch khuyến mãi của doanh nghiệp). Mô hình này đạt MAE 10,08, gần LightGBM (9,81): khi cho ARIMA cùng thông tin, khoảng cách thu hẹp đáng kể.
Rolling origin: đánh giá chuỗi thời gian qua 11 mốc cắt
Một mốc cắt không đủ để kết luận về dự báo chuỗi thời gian. Ta lặp lại toàn bộ quy trình (huấn luyện lại từ đầu mỗi mốc) cho 11 mốc cuối tháng từ 31/01/2022 đến 30/11/2022, mỗi lần dự báo 28 ngày, rồi lấy MASE trung bình:
[Rolling origin] 11 mốc cắt (cuối tháng 1 → tháng 11/2022), mỗi lần dự báo 28 ngày; MASE trung bình ± độ lệch chuẩn
  (tổng thời gian 32 giây)
  LightGBM (lịch + lag ≥ 28)      0.610 ± 0.127 | tốt nhất 0.43, tệ nhất 0.76
  SARIMAX + biến khuyến mãi       0.680 ± 0.251 | tốt nhất 0.42, tệ nhất 1.35
  SARIMA(1,1,1)(1,1,1,7)          1.107 ± 0.391 | tốt nhất 0.59, tệ nhất 1.95
  Seasonal naive (m=7)            1.439 ± 0.268 | tốt nhất 1.04, tệ nhất 1.87
  ARIMA(2,1,2)                    1.975 ± 0.302 | tốt nhất 1.51, tệ nhất 2.53
  Mean                            3.232 ± 1.204 | tốt nhất 1.74, tệ nhất 4.99
  Naive (giá trị cuối)            4.635 ± 2.881 | tốt nhất 1.80, tệ nhất 10.91
  Drift                           4.784 ± 2.973 | tốt nhất 1.84, tệ nhất 11.21
Bức tranh rõ hơn nhiều khi dự báo chuỗi thời gian qua nhiều mốc. LightGBM có MASE trung bình 0,610 và ổn định (độ lệch chuẩn 0,127, tệ nhất 0,76). SARIMAX có khuyến mãi gần bằng ở mức trung bình (0,680) nhưng dao động gấp đôi (độ lệch chuẩn 0,251) và có mốc tệ tới 1,35.
SARIMA thuần (1,107) tốt hơn seasonal naive (1,439) ở mức trung bình nhưng dao động mạnh (độ lệch chuẩn 0,391, có mốc tệ tới 1,95, kém hơn cả mốc tệ nhất của seasonal naive là 1,87). Nguyên nhân nằm ở các ngày khuyến mãi (15 và cuối tháng, doanh số nhảy 35%) mà SARIMA chu kỳ 7 không biết. Ta kiểm chứng bằng cách gộp sai số tuyệt đối từng ngày qua 11 mốc cắt rồi tách ngày khuyến mãi khỏi ngày thường:
[Sai số theo loại ngày, gộp 11 mốc cắt] MAE ngày khuyến mãi (15 và cuối tháng) so với ngày thường:
  SARIMA(1,1,1)(1,1,1,7)         khuyến mãi  55.82 (n=12) | thường  12.81 (n=296) | tỉ lệ 4.36
  SARIMAX + biến khuyến mãi      khuyến mãi  11.75 (n=12) | thường   8.75 (n=296) | tỉ lệ 1.34
  LightGBM (lịch + lag ≥ 28)     khuyến mãi  13.95 (n=12) | thường   7.68 (n=296) | tỉ lệ 1.82
  Seasonal naive (m=7)           khuyến mãi  59.28 (n=12) | thường  17.11 (n=296) | tỉ lệ 3.46
  Sai số của SARIMA (không biết khuyến mãi) tách theo mốc cắt, MASE từng mốc:
  0.88 0.59 0.82 0.90 1.03 1.38 1.95 1.42 1.53 0.91 0.77
SARIMA sai gấp 4,36 lần trên ngày khuyến mãi (MAE 55,82 so với 12,81), trong khi SARIMAX có biến khuyến mãi chỉ sai gấp 1,34 lần. Đây là bằng chứng trực tiếp cho giải thích trên, nhưng chưa phải toàn bộ: mẫu ngày khuyến mãi nhỏ (12 ngày: mỗi cửa sổ 28 ngày chứa đúng ngày 15, riêng cửa sổ tháng Hai có thêm ngày 28), và ngay cả ngày thường SARIMA (12,81) vẫn kém SARIMAX (8,75), nên nhiễu ước lượng tham số mùa vụ cũng góp phần. Mốc tệ nhất (MASE 1,95) là mốc cuối tháng 7; bài không đi sâu giải thích riêng mốc này. Đây cũng là dữ liệu giả lập mà ta tự đặt hiệu ứng khuyến mãi mạnh; trên dữ liệu thật, khoảng cách giữa các nhóm mô hình thường hẹp hơn.
Những cái bẫy của chuỗi thời gian: lag và cross-validation
Rò rỉ tương lai qua lag ngắn
Thử dùng lag7 cho bài toán dự báo chuỗi thời gian 28 ngày, và để dự báo ta lấy lag7 từ chính 28 ngày test thật (điều không thể làm ngoài đời, vì lúc đó chưa có doanh số ngày thứ 21):
[Rò rỉ tương lai] LightGBM dùng lag7 nhưng lấy lag từ chính 28 ngày test thật:
  MAE = 8.84, MASE = 0.662  (so với cách đúng, lag ≥ 28: MAE = 9.81)
Kết quả "đẹp" hơn (MAE 8,84 so với 9,81), nhưng chỉ nhỉnh khoảng 10% trong thí nghiệm này. Chênh lệch nhỏ vì dữ liệu giả lập có mùa vụ tuần rất đều, nên lag28 đã chứa gần hết thông tin mà lag7 có. Đừng vì thế coi nhẹ rò rỉ: trên dữ liệu có cú sốc ngắn hạn hoặc tự tương quan mạnh, lag ngắn bị rò rỉ có thể khiến mô hình tốt giả tạo, và bạn chỉ phát hiện ra khi triển khai.
KFold xáo trộn so với TimeSeriesSplit
[CV trên train, cùng mô hình LightGBM lag ≥ 28]
  KFold xáo trộn  : MAE = 6.64 ± 0.45
  TimeSeriesSplit : MAE = 7.06 ± 1.30 (từng fold: [9.17 6.19 7.46 7.18 5.29])
  MAE thật trên 28 ngày test sau mốc cắt: 9.81
KFold xáo trộn cho MAE 6,64, lạc quan hơn TimeSeriesSplit (7,06) và cả hai đều lạc quan hơn MAE thật sau mốc cắt (9,81). Chênh lệch giữa hai cách CV nhỏ ở đây vì ta đã dùng lag ≥ 28 nên đặc trưng không rò rỉ, và chuỗi chỉ có xu hướng tuyến tính nhẹ. Tuy vậy, KFold xáo trộn cho độ lệch chuẩn thấp hơn hẳn (0,45 so với 1,30), tức là nó che bớt độ bất định thật. Quy tắc an toàn: chỉ dùng TimeSeriesSplit hoặc rolling origin, và đừng tin một con số CV đơn lẻ làm dự báo cho tương lai.
Cây không ngoại suy xu hướng
Mô hình cây dự báo chuỗi thời gian bằng giá trị trung bình trong các lá đã thấy khi huấn luyện, nên không thể vượt khỏi miền giá trị cũ. Ta kiểm chứng bằng cách huấn luyện chỉ trên 2020 đến 2021 với đặc trưng lịch, rồi dự báo cả năm 2022:
[Xu hướng] doanh số trung bình năm 2020 → 2022: 124.1 → 187.3
  LightGBM chỉ đặc trưng lịch, train 2020-2021, dự báo cả 2022: giá trị dự báo trung bình = 142.5, thực tế = 187.3
Doanh số thật tăng từ 124,1 lên 187,3, mô hình dự báo 2022 chỉ khoảng 142,5, thấp hơn 24% so với thực tế, vì chưa từng thấy mức doanh số cao như vậy. Lag có tác dụng "tải" mức hiện tại vào đặc trưng, nên mô hình có lag (như ở trên) bớt bị vấn đề này; nhưng với xu hướng mạnh, nên khử xu hướng (dự báo phần chênh so với lag) hoặc kết hợp với mô hình có xu hướng tường minh.
So sánh ba họ phương pháp dự báo chuỗi thời gian
| Tiêu chí | Baseline | ARIMA / SARIMA(X) | Gradient boosting |
|---|---|---|---|
| Công sức cài đặt | Vài dòng | Chọn (p,d,q)(P,D,Q,s), kiểm tra dừng | Thiết kế đặc trưng lag, lịch |
| Mùa vụ | Seasonal naive | Có, qua seasonal_order | Qua đặc trưng lịch và lag |
| Biến ngoại sinh (khuyến mãi) | Không | SARIMAX, exog | Thêm cột, dễ |
| Xu hướng | Drift | Có, qua sai phân | Không ngoại suy |
| MASE trong bài (rolling) | 1,439 (seasonal naive) | 1,107 (SARIMA), 0,680 (có exog) | 0,610 |
| Độ ổn định (độ lệch chuẩn) | 0,268 | 0,391 / 0,251 | 0,127 |
Khi nào không nên dùng gradient boosting cho chuỗi thời gian
- Chuỗi thời gian ngắn: vài chục điểm thì ARIMA hoặc làm mịn mũ ổn định hơn nhiều so với cây.
- Cần khoảng tin cậy chuẩn cho chuỗi thời gian: ARIMA cho khoảng dự báo từ mô hình xác suất; LightGBM cần thêm hồi quy phân vị hoặc conformal prediction.
- Xu hướng mạnh và kéo dài: cây không ngoại suy, như ví dụ 142,5 so với 187,3.
- Hàng nghìn chuỗi thời gian nhỏ: huấn luyện lại riêng từng chuỗi tốn công vận hành; cân nhắc mô hình toàn cục hoặc baseline.
Lỗi thường gặp khi dự báo chuỗi thời gian
- Chia ngẫu nhiên (
train_test_split, KFold xáo trộn): dữ liệu tương lai lọt vào huấn luyện; luôn chia theo thời gian. - Dùng lag ngắn hơn horizon: khi dự báo thật, lag đó chưa tồn tại.
- Bỏ qua baseline cho chuỗi thời gian: ARIMA(2,1,2) trong bài còn thua seasonal naive trên một mốc cắt.
- Kết luận từ một mốc cắt: MASE của SARIMA dao động từ 0,59 đến 1,95 qua 11 mốc.
- Chọn d và D bằng cảm tính: hãy kiểm định ADF và xem biểu đồ, không sai phân thừa.
- Quên huấn luyện lại định kỳ: chuỗi thời gian đổi quy luật khi có cú sốc, thay đổi khuyến mãi hay mùa lễ làm mô hình lỗi thời.
Checklist
- Với chuỗi thời gian, luôn bắt đầu bằng bốn baseline, báo cáo MASE kèm MAE.
- Chia chuỗi thời gian và cross-validation theo thời gian, dùng nhiều mốc cắt.
- Kiểm tra tính dừng của chuỗi thời gian bằng ADF, chọn d, thêm seasonal_order khi có chu kỳ.
- Với gradient boosting, mọi lag lớn hơn hoặc bằng horizon, thêm đặc trưng lịch và biến ngoại sinh biết trước.
- Kiểm tra mô hình cây trên chuỗi thời gian có xu hướng mạnh, cân nhắc khử xu hướng.
- Theo dõi sai số dự báo chuỗi thời gian sau triển khai và huấn luyện lại định kỳ.
Mã nguồn đầy đủ trong code/s7-18 (forecast_demo.py, output.txt, requirements.txt), chạy bằng python forecast_demo.py. Mọi số liệu là output thật từ Apple M4, 16 GB, CPU, hạt giống cố định (rolling origin chạy khoảng 32 giây). Hiệu ứng khuyến mãi do ta tự đặt, nên thứ hạng mô hình không áp dụng chung cho chuỗi thời gian thật.
Bài tiếp theo
Xây hệ gợi ý sản phẩm bằng Python: content-based và collaborative filtering. Sau dự báo doanh số tổng, bài kế tiếp đi xuống mức từng khách hàng: gợi ý sản phẩm nên mua tiếp bằng content-based và collaborative filtering.