Một mô hình chấm điểm tín dụng từ chối khoản vay của khách hàng. Khách hỏi vì sao, bộ phận rủi ro hỏi mô hình có đang dựa vào dữ liệu hợp lý không, cơ quan quản lý hỏi bằng chứng. Với gradient boosting, câu trả lời "vì hàng trăm cây quyết định như vậy" không đủ. SHAP (SHapley Additive exPlanations) trả lời bằng cách chia phần chênh lệch giữa dự đoán của một khách và dự đoán trung bình cho từng đặc trưng, theo một định nghĩa có nền tảng lý thuyết trò chơi. Bài này dùng đúng bài toán đó (dữ liệu giả lập, 10.000 khách) để cài đặt Shapley bằng tay, kiểm tra tính chất cộng bằng số, so SHAP với hai thước đo độ quan trọng khác và chỉ ra những chỗ SHAP dễ bị hiểu sai.
Bài nối tiếp Gradient boosting với XGBoost và LightGBM: khi nào thắng deep learning, bài kết luận rằng độ quan trọng theo gain chưa đủ tin cậy. Đặc trưng tương quan và rò rỉ dữ liệu ảnh hưởng thế nào tới diễn giải đã có ở Feature engineering cho dữ liệu bảng: mã hoá, chuẩn hoá và rò rỉ dữ liệu. Môi trường: Apple M4, 16 GB, Python 3.12; mọi API dùng trong bài (TreeExplainer, KernelExplainer, shap.Explanation, shap.plots.waterfall, beeswarm, scatter) đã có từ shap 0.41 (tháng 6/2022) và XGBoost 1.7 (tháng 10/2022), cùng ra trước tháng 3/2023.
SHAP là gì và đến từ đâu
Giá trị Shapley xuất phát từ lý thuyết trò chơi hợp tác. Theo chương Shapley values trong sách Interpretable Machine Learning của Christoph Molnar, mỗi giá trị đặc trưng của một mẫu là một "người chơi", phần thưởng là dự đoán trừ dự đoán trung bình, và đóng góp của một đặc trưng là mức thay đổi dự đoán khi thêm nó vào một tập đặc trưng, lấy trung bình có trọng số trên mọi tập đặc trưng khả dĩ. Phương pháp thoả bốn tiên đề: hiệu quả (các đóng góp cộng lại bằng dự đoán trừ trung bình), đối xứng, giả (đặc trưng không bao giờ đổi dự đoán thì bằng 0) và cộng tính.
Bài báo A Unified Approach to Interpreting Model Predictions của Scott Lundberg và Su-In Lee (NIPS 2017) đặt tên SHAP cho khung này. Họ chỉ ra một lớp "đo lường quan trọng cộng tính" có nghiệm duy nhất với một số tính chất mong muốn, và gộp sáu phương pháp giải thích có sẵn vào cùng khung. Kết quả thực dụng: giải thích của SHAP cho một dự đoán luôn có dạng
f(x) = giá_trị_cơ_sở + SHAP(đặc trưng 1) + SHAP(đặc trưng 2) + ... + SHAP(đặc trưng p)với giá trị cơ sở là dự đoán trung bình. Mỗi SHAP dương đẩy dự đoán lên so với trung bình, âm kéo xuống. Quan trọng là đơn vị: với mô hình phân loại như XGBoost, SHAP mặc định nằm trên thang log-odds, không phải xác suất. Ta sẽ thấy hệ quả của điều đó ở phần sau.
Dữ liệu và mô hình
Ta sinh 10.000 khách vay với sáu cột: tuổi, thu nhập hàng tháng, tổng chi tiêu, số tháng làm việc, tỉ lệ nợ trên thu nhập và số lần trễ hạn. Nhãn là vỡ nợ, sinh từ một hàm logistic trong đó tong_chi_tieu không có tác động trực tiếp, nhưng được tạo bằng khoảng 55 đến 75% thu nhập cộng nhiễu. Ta cố ý như vậy để sau này kiểm tra SHAP xử lý đặc trưng tương quan ra sao. Dữ liệu hoàn toàn giả lập, không có thông tin cá nhân.
[1] Dữ liệu: (10000, 6) | tỉ lệ vỡ nợ: 0.215 | corr(thu_nhap, tong_chi_tieu) = 0.96
    XGBoost AUC test = 0.7265
Mô hình là XGBClassifier 300 cây, độ sâu 3, learning rate 0,05, huấn luyện trên 75% dữ liệu; AUC trên 25% còn lại là 0,7265.
TreeExplainer: giải thích một dự đoán và kiểm tra tính chất cộng
Với mô hình cây, SHAP có thuật toán riêng. Bài báo Consistent Individualized Feature Attribution for Tree Ensembles (Lundberg, Erion, Lee) trình bày thuật toán chính xác cho cây nhanh hơn vét cạn theo cấp số mũ, giá trị SHAP tương tác, và cho biết cài đặt đã được tích hợp vào XGBoost và LightGBM. Dùng thì rất ngắn:
expl = shap.TreeExplainer(model)
sv = expl.shap_values(X_te)                      # ma trận (số dòng, số đặc trưng), thang log-odds
margin = model.predict(X_te, output_margin=True)
np.abs(expl.expected_value + sv.sum(1) - margin).max()
[2] TreeExplainer và tính chất cộng (local accuracy), đầu ra là log-odds
giá trị cơ sở E[f(x)] (log-odds) = -1.2989 -> xác suất 0.214
sai số lớn nhất |cơ sở + tổng SHAP - log-odds mô hình| trên 2500 dòng = 3.34e-06Giá trị cơ sở là -1,2989 log-odds, tương ứng xác suất 0,214, gần đúng tỉ lệ vỡ nợ 0,215 của dữ liệu. Trên toàn bộ 2.500 khách kiểm tra, cơ sở cộng tổng SHAP khớp log-odds của mô hình với sai số lớn nhất 3,34e-06, mức sai số dấu phẩy động đơn của XGBoost. Đó là tính chất local accuracy mà ta kiểm chứng bằng số thay vì tin tài liệu. Giờ lấy một khách trong nhóm rủi ro cao nhất:
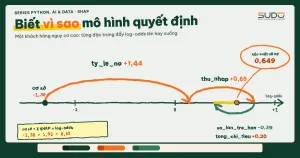
    Khách #7535 (nằm trong nhóm rủi ro cao): xác suất vỡ nợ dự đoán = 0.649
      ty_le_no           = 0.776        SHAP = +1.441
      thu_nhap           = 1.314e+07    SHAP = +0.654
      so_lan_tre_han     = 0            SHAP = -0.394
      tong_chi_tieu      = 5.66e+06     SHAP = +0.199
      tuoi               = 35           SHAP = +0.009
      so_thang_lam_viec  = 67           SHAP = +0.007
      cơ sở -1.299 + tổng SHAP +1.915 = +0.617 (log-odds mô hình: +0.617)
Đọc như một báo cáo cho bộ phận rủi ro: khách này có xác suất vỡ nợ 64,9% so với 21,4% trung bình. Yếu tố đẩy rủi ro lên mạnh nhất là tỉ lệ nợ 0,776 (+1,441), kế đến là thu nhập 13,1 triệu đồng thấp hơn mức điển hình (+0,654). Việc chưa từng trễ hạn kéo rủi ro xuống (-0,394), còn tuổi và số tháng làm việc gần như không đóng góp.
Điều đáng chú ý: tong_chi_tieu được cộng +0,199 dù dữ liệu sinh ra không cho nó tác động trực tiếp; ta quay lại điểm này ở phần đặc trưng tương quan.
Tự tính Shapley bằng định nghĩa để hiểu SHAP không phải phép màu
Ta kiểm tra bằng cách cài đặt đúng định nghĩa. Với p = 6 đặc trưng chỉ có 26 = 64 tập con, vét cạn được. Hàm giá trị v(S) là dự đoán trung bình khi các đặc trưng trong S lấy theo khách đang xét còn các đặc trưng còn lại lấy từ 100 dòng nền:
def value(S, x):
    B = bg.copy()                                   # bg: 100 dòng nền lấy từ tập huấn luyện
    for c in S: B[c] = x[c]
    return model.predict(B, output_margin=True).mean()

# với mỗi đặc trưng c: phi[c] = tổng trên mọi tập con S của các đặc trưng còn lại
#   trọng số * (v(S ∪ {c}) - v(S)),  trọng số = |S|! (p-|S|-1)! / p!
[3] Shapley value tính bằng định nghĩa (vét cạn mọi tập con) so với shap, interventional, nền 100 dòng
6 đặc trưng -> 64 tập con; vét cạn: 0.09s | TreeExplainer: 0.0023s
tuoi vét cạn = +0.01681 | shap = +0.01681 | lệch = 2.3e-08
thu_nhap vét cạn = +0.71914 | shap = +0.71914 | lệch = 7.3e-08
tong_chi_tieu vét cạn = +0.16540 | shap = +0.16540 | lệch = 1.3e-07
so_thang_lam_viec vét cạn = +0.05645 | shap = +0.05645 | lệch = 2.7e-08
ty_le_no vét cạn = +1.47391 | shap = +1.47391 | lệch = 8.3e-07
so_lan_tre_han vét cạn = -0.37593 | shap = -0.37594 | lệch = 1.6e-07Hai cách khớp nhau tới sai số dấu phẩy động (tối đa 8,3e-07), nên TreeExplainer với dữ liệu nền không làm gì khác định nghĩa; nó chỉ tính nhanh hơn. Chi phí vét cạn là vấn đề thật: số tập con tăng theo luỹ thừa của p, từ 64 (6 đặc trưng) lên 4.096 (12), hơn một triệu (20) và 1.073.741.824 (30). Vì vậy với mô hình không phải cây, người ta dùng KernelExplainer lấy mẫu xấp xỉ, còn cho mô hình cây thì dùng thuật toán chuyên biệt.
Lưu ý một chi tiết hay bị bỏ qua: ở bước trước, TreeExplainer(model) không có dữ liệu nền dùng chế độ path-dependent, ước lượng kỳ vọng từ số mẫu đi qua mỗi nhánh của cây. Với dữ liệu nền 100 dòng nó dùng chế độ interventional. Kết quả cho cùng khách ở chế độ mặc định:
(so sánh) path-dependent mặc định, không cần dữ liệu nền: tuoi +0.009, thu_nhap +0.654, tong_chi_tieu +0.199, so_thang_lam_viec +0.007, ty_le_no +1.441, so_lan_tre_han -0.394So với bản interventional: thu_nhap +0,654 so với +0,719, tong_chi_tieu +0,199 so với +0,165, ty_le_no +1,441 so với +1,474. Thứ tự và dấu giống nhau, độ lớn lệch vài phần trăm, vì tham chiếu khác nhau (mẫu nền 100 dòng so với phân bố huấn luyện ngầm trong cây).
Độ quan trọng toàn cục: SHAP, gain và permutation cho kết quả khác nhau
Gộp SHAP trên nhiều khách bằng trung bình giá trị tuyệt đối (mean|SHAP|) cho độ quan trọng toàn cục. Ta so với hai thước đo phổ biến khác: độ quan trọng theo gain của XGBoost (đã gặp ở bài trước; cột gain TB là get_score(importance_type="gain"), tức mức giảm loss trung bình mỗi lần chia, còn total_gain là mức giảm loss tổng cộng) và permutation importance (mức giảm AUC trên tập kiểm tra khi xáo trộn một cột), cả ba chuẩn hoá về phần trăm:
[4] Ba thước đo độ quan trọng toàn cục trên tập test (chuẩn hoá về %)
    đặc trưng          mean|SHAP|    gain TB  total_gain permutation AUC
    ty_le_no                24.9%      20.3%       26.4%          32.0%
    thu_nhap                24.4%      15.9%       20.3%          28.9%
    so_lan_tre_han          19.9%      31.9%       15.8%          21.3%
    so_thang_lam_viec       16.0%      12.1%       16.0%          14.6%
    tuoi                     8.7%       8.6%        7.9%           2.5%
    tong_chi_tieu            6.1%      11.2%       13.6%           0.8%
    số lần chia trong 300 cây: {'tuoi': 281, 'thu_nhap': 390, 'tong_chi_tieu': 371, 'so_thang_lam_viec': 406, 'ty_le_no': 397, 'so_lan_tre_han': 151}
Ba cột kể ba câu chuyện khác nhau. Theo gain trung bình, so_lan_tre_han đứng đầu (31,9%), nhưng theo total_gain nó chỉ còn 15,8%, vì cột này chỉ được chia 151 lần trong 300 cây, ít hơn nhiều so với 371 đến 406 lần của các cột liên tục: ít lần chia nhưng mỗi lần giảm loss nhiều, nên mức trung bình cao còn tổng thì thấp. Đây là cách đọc phù hợp với số liệu, ta không chạy thêm thí nghiệm để khẳng định nguyên nhân. Theo SHAP và permutation, ty_le_no dẫn đầu. Biến tong_chi_tieu, vốn không có tác động trực tiếp, nhận 11,2% theo gain trung bình, 13,6% theo total_gain nhưng chỉ 0,8% theo permutation; SHAP cho 6,1%, ở giữa. Lưu ý gain tính trên dữ liệu huấn luyện, permutation trên tập kiểm tra.
Không có thước đo nào "đúng" tuyệt đối vì chúng trả lời các câu hỏi khác nhau: gain đo mức mô hình dùng đặc trưng khi huấn luyện, permutation đo mức điểm số phụ thuộc đặc trưng, SHAP đo mức đặc trưng dịch chuyển dự đoán so với tham chiếu. Điểm chung đáng tin: ba thước đo đều xếp ty_le_no, thu_nhap và so_lan_tre_han trong nhóm đầu, đúng với cách ta sinh dữ liệu.
Đặc trưng tương quan: SHAP chia công, không phát hiện "bản sao"
Ta quay lại tong_chi_tieu, tương quan 0,96 với thu_nhap. Mô hình cây chia công việc giữa hai cột gần như trùng thông tin, nên SHAP cũng chia theo:
[5] Đặc trưng tương quan: tong_chi_tieu không tác động trực tiếp tới nhãn nhưng gần như bản sao của thu_nhap
    mean|SHAP|: thu_nhap = 0.413 | tong_chi_tieu = 0.103
    AUC test: đủ 6 cột = 0.726542 | bỏ tong_chi_tieu = 0.726545
    mean|SHAP| của thu_nhap: 0.453 khi bỏ tong_chi_tieu (trước đó thu_nhap + tong_chi_tieu = 0.516)
Bỏ hẳn cột tong_chi_tieu không làm đổi AUC (0,726542 so với 0,726545), tức cột đó không cung cấp thông tin thêm; nhưng trong mô hình đầy đủ SHAP vẫn gán cho nó giá trị trung bình 0,103. Khi bỏ cột, thu_nhap nhận 0,453 thay vì 0,413: phần "công" bị chia cho bản sao đã quay về cột gốc (tổng hai cột trước đó là 0,516, không bằng 0,453 vì mô hình khác nhau, chọn chia khác nhau).
Bài học: SHAP giải thích mô hình, không giải thích thế giới. Nếu mô hình dùng tong_chi_tieu như đại diện của thu nhập, SHAP sẽ báo đúng điều đó, và người đọc không được kết luận chi tiêu gây ra vỡ nợ. Molnar cũng cảnh báo rằng với đặc trưng tương quan, lấy mẫu độc lập có thể tạo ra những mẫu phi thực tế, còn lấy mẫu có điều kiện lại phá tính đối xứng.
Tài liệu của thư viện shap gợi ý gom cụm các đặc trưng tương quan rồi xem biểu đồ cột theo cụm.
Các biểu đồ SHAP và cách đọc đúng
Thư viện có sẵn ba biểu đồ hay dùng, đều từ cùng một đối tượng Explanation:
exp = shap.Explanation(values=sv, base_values=np.full(len(sv), expl.expected_value),
                       data=X_te.values, feature_names=cols)
shap.plots.waterfall(exp[i])            # một dự đoán: từ giá trị cơ sở tới f(x)
shap.plots.beeswarm(exp)                # toàn bộ mẫu: phân bố SHAP của từng đặc trưng
shap.plots.scatter(exp[:, "ty_le_no"]) # SHAP theo giá trị đặc trưng (dependence)- Waterfall cho một khách, bắt đầu từ giá trị cơ sở và cộng từng đóng góp tới
f(x); dùng để giải trình từng quyết định. - Beeswarm vẽ mỗi khách một chấm, trục ngang là giá trị SHAP, màu là giá trị đặc trưng (thấp tới cao). Trong biểu đồ của ta, chấm đỏ của
ty_le_nonằm bên phải (tỉ lệ nợ cao đẩy rủi ro lên), chấm đỏ củathu_nhapnằm bên trái (thu nhập cao kéo rủi ro xuống), đúng hướng nghiệp vụ. - Scatter cho thấy dạng quan hệ (tuyến tính, bậc thang, ngưỡng), thứ mà một con số độ quan trọng không thể cho.
Biểu đồ beeswarm còn lộ ra một cấu trúc mà bảng ở trên che đi. Với so_lan_tre_han, các chấm tách thành những cụm rời rạc (0, 1, 2, 3 lần trễ hạn) vì biến này nhận ít giá trị; còn so_thang_lam_viec có đuôi dài phía âm do khách có thâm niên rất cao được kéo rủi ro xuống mạnh. Bài không nhúng hình; chạy shap_demo.py để xem ba PNG. Bằng số, khoảng SHAP trên tập test (thang log-odds) là:
      ty_le_no           -1.08 | +1.75
      thu_nhap           -1.30 | +1.36
      so_lan_tre_han     -0.44 | +2.03
      so_thang_lam_viec  -2.67 | +0.54
      tuoi               -0.38 | +0.61
      tong_chi_tieu      -0.93 | +0.60
Đuôi âm của so_thang_lam_viec tới -2,67 là lớn nhất về độ sâu trong sáu cột, còn so_lan_tre_han có đuôi dương tới +2,03 (khách trễ hạn nhiều lần).
Thang log-odds và thang xác suất
SHAP của mô hình phân loại mặc định tính theo log-odds, nơi mô hình XGBoost là một tổng cộng tính. Nhưng người nghe quen với xác suất, và quan hệ giữa hai thang không tuyến tính. Cùng một mức +1,0 log-odds cho mức tăng xác suất rất khác nhau tuỳ điểm xuất phát:
[6] Cùng một thay đổi 1 đơn vị SHAP (log-odds) tương ứng mức thay đổi xác suất rất khác nhau
    từ log-odds -4.0 (xác suất 0.018) cộng thêm +1.0 -> xác suất 0.047 (tăng 0.029)
    từ log-odds -2.0 (xác suất 0.119) cộng thêm +1.0 -> xác suất 0.269 (tăng 0.150)
    từ log-odds +0.0 (xác suất 0.500) cộng thêm +1.0 -> xác suất 0.731 (tăng 0.231)
Vì thế "tỉ lệ nợ đóng góp +1,441" không có nghĩa xác suất vỡ nợ tăng 1,441 hay 144%. Khi báo cáo cho người không chuyên, nên nói rõ đơn vị, hoặc chuyển cả chuỗi sang xác suất (như ta làm với khách #7535: từ 21,4% lên 64,9%) và chỉ xếp hạng các yếu tố theo thứ tự ảnh hưởng thay vì diễn giải từng con số tuyệt đối.
Chi phí: TreeExplainer và KernelExplainer
KernelExplainer áp dụng cho mô hình bất kỳ nhưng phải lấy mẫu các tập con đặc trưng. Ta chạy cả hai trên cùng mô hình:
[7] Chi phí: TreeExplainer (chính xác) so với KernelExplainer (xấp xỉ, không phụ thuộc mô hình)
    TreeExplainer, 2500 dòng: 0.064s
    KernelExplainer, 20 dòng, nền 50 dòng, nsamples=200: 0.11s
    chênh lệch trung bình |Kernel - Tree interventional| trên 20 dòng: 1.29e-07 (thang log-odds)
Cần đọc đúng: ở đây Kernel gần như trùng Tree (lệch 1,29e-07) vì chỉ có 64 tập con, nhỏ hơn nsamples=200, nên nó duyệt hết và thực chất cho kết quả chính xác. Con số thời gian (0,064 giây cho 2.500 dòng so với 0,11 giây cho 20 dòng, tức khoảng 26 micro giây so với 5,5 mili giây mỗi dòng) cho thấy chênh lệch cỡ hàng trăm lần về thông lượng. Thời gian dao động giữa các lần chạy (các lần chạy lại cho 0,05 đến 0,11 giây ở Kernel nên tỉ lệ nằm trong khoảng vài trăm lần), nên chỉ tin vào bậc độ lớn, trên bài toán 6 đặc trưng; với 30 hay 50 đặc trưng, Kernel buộc phải xấp xỉ và sai số, phương sai sẽ xuất hiện.
Khi nào không nên tin hoặc dùng SHAP
- Kết luận nhân quả: SHAP cho biết mô hình dùng đặc trưng thế nào, không cho biết thay đổi đặc trưng ngoài đời có làm kết quả đổi hay không.
- Đặc trưng tương quan mạnh: công bị chia bất định giữa các bản sao; hãy gom cụm hoặc bỏ bớt trước khi diễn giải.
- Giải thích cho người dùng cuối theo quy định (ví dụ từ chối tín dụng): cần kiểm tra pháp lý riêng; một biểu đồ SHAP không tự đủ làm căn cứ.
Lỗi thường gặp
- Diễn giải SHAP của XGBoost như phần trăm xác suất trong khi đó là log-odds.
- Tính SHAP trên tập huấn luyện rồi kết luận về dữ liệu mới; nên tính trên tập kiểm tra hoặc dữ liệu thật gần đây.
- Coi mean|SHAP| như bằng chứng nhân quả hoặc so sánh số tuyệt đối giữa các mô hình khác nhau.
- Chỉ nhìn biểu đồ cột tổng hợp mà bỏ qua beeswarm và scatter, nơi lộ ra phi tuyến và ngưỡng.
Checklist giải thích mô hình với SHAP
- Dùng
TreeExplainercho mô hình cây; kiểm tra tính chất cộng bằng cách so cơ sở cộng tổng SHAP với đầu ra mô hình. - Ghi rõ đơn vị (log-odds hay xác suất), chế độ tính (path-dependent hay interventional) và tập nền, vì kết quả phụ thuộc dữ liệu tham chiếu.
- So SHAP với permutation importance; khác biệt lớn là dấu hiệu cần điều tra, thường do đặc trưng tương quan.
- Dùng waterfall cho từng quyết định, beeswarm và scatter cho hành vi chung của mô hình.
- Không kết luận nhân quả từ SHAP; kiểm chứng giả thuyết bằng thí nghiệm hoặc dữ liệu can thiệp.
Mã nguồn đầy đủ nằm trong code/s7-15 (shap_demo.py, output.txt, requirements.txt, ba hình PNG); chạy bằng python shap_demo.py trong venv. Trên macOS, XGBoost và LightGBM cần thư viện OpenMP (libomp). Mọi số liệu là output thật trên Apple M4, 16 GB.
Bài tiếp theo
Phân cụm khách hàng: K-Means, DBSCAN và giảm chiều với PCA. Từ học có giám sát với nhãn, bài sau chuyển sang học không giám sát: tìm nhóm khách hàng tự nhiên trong dữ liệu khi không có nhãn, và cách đánh giá chất lượng cụm.