Hai mô hình giống hệt nhau về thuật toán có thể cho kết quả khác nhau từ vài điểm đến hàng chục điểm AUC chỉ vì cách biểu diễn dữ liệu đầu vào, như các thí nghiệm dưới đây sẽ cho thấy. Đó là lý do feature engineering, tức biến cột thô của bảng thành đặc trưng mà mô hình học được, là một bước đáng đầu tư trong các dự án machine learning trên dữ liệu bảng. Bài này làm feature engineering trên một bài toán dự đoán đơn hàng bị hoàn (dữ liệu giả lập, 6.000 đơn) và đi qua bốn việc cụ thể: chuẩn hoá biến số, mã hoá biến phân loại có 80 giá trị, tạo đặc trưng thời gian, và quan trọng nhất là nhận diện rò rỉ dữ liệu trước khi nó biến một mô hình vô dụng thành mô hình "xuất sắc".
Bài nối tiếp Đánh giá mô hình phân loại: precision, recall, ROC và dữ liệu lệch và Machine learning với scikit-learn: Pipeline, cross-validation và tuning; ta dùng lại Pipeline và ColumnTransformer ở đó. Lý do chuẩn hoá thường giúp gradient descent hội tụ nhanh hơn có ở Hồi quy tuyến tính và gradient descent: tự cài đặt bằng NumPy. Môi trường: Apple M4, 16 GB, Python 3.10, scikit-learn 1.2.0, pandas 1.5.3, NumPy 1.24.1; mọi API dùng trong bài đã có từ scikit-learn 1.1.
Feature engineering là gì và vì sao quyết định chất lượng mô hình
Theo sách Feature Engineering and Selection của Max Kuhn và Kjell Johnson (2018), việc biểu diễn lại các biến dự đoán (predictor) là một bước mô hình hoá thực thụ, không phải việc dọn dẹp phụ. Chính các tác giả cảnh báo rằng quá trình này cũng có thể gây overfitting vì số cách biểu diễn khả dĩ rất lớn. Hệ quả thực tế: mỗi lần "thử thêm một đặc trưng" là một lần ta nhìn vào dữ liệu và chọn, nên phải đo bằng cross-validation chứ không bằng cảm tính.
Với dữ liệu bảng, feature engineering xoay quanh bốn nhóm: biến số (chuẩn hoá, log), biến phân loại (one-hot, ordinal, target encoding), thời gian (tách giờ, thứ, tuần) và giá trị thiếu, nơi đôi khi chính việc thiếu là tín hiệu. Quy tắc xuyên suốt của feature engineering: mọi phép biến đổi có học thống kê từ dữ liệu phải học chỉ trên tập huấn luyện; vi phạm là rò rỉ dữ liệu.
Dữ liệu minh hoạ cho feature engineering: đơn hàng thương mại điện tử
Ta sinh 6.000 đơn với giá trị đơn (VND, phân phối lệch phải), số sản phẩm, quận giao hàng (80 giá trị, tần suất kiểu Zipf: vài quận rất đông, nhiều quận hiếm), kênh bán, size, giờ đặt, thời điểm đặt và số ngày kể từ lần mua trước (thiếu với khách mới). Nhãn là đơn bị hoàn, sinh từ một hàm logistic có nhiễu, nên ta biết chắc biến nào có tín hiệu thật. Dữ liệu hoàn toàn giả lập, không có thông tin cá nhân.
[1] Dữ liệu: (6000, 8) | tỉ lệ hoàn: 0.400
Số quận: 80 | quận hiếm nhất: 19 đơn | đông nhất: 783
Thiếu so_ngay_tu_lan_mua: 36.2%
Độ lệch (skew) gia_tri: 4.48 -> sau log1p: 0.00
Ta chia 75/25 có phân tầng; mọi số "CV AUC" dưới đây là trung bình ± độ lệch chuẩn của cross-validation 5-fold chỉ trên 4.500 đơn huấn luyện.
Feature engineering cho biến số: chuẩn hoá có tác dụng khi nào
Tài liệu Preprocessing data của scikit-learn mô tả StandardScaler (trừ trung bình, chia độ lệch chuẩn), MinMaxScaler (đưa về đoạn [0, 1]) và RobustScaler (dùng trung vị và khoảng tứ phân vị, chịu được ngoại lai). Trong feature engineering, chuẩn hoá không phải lúc nào cũng cải thiện điểm số. Ta thử trên hai biến gia_tri (cỡ hàng trăm nghìn) và so_san_pham (cỡ vài đơn vị) với hai mô hình khác bản chất:
pipe = make_pipeline(ColumnTransformer([("n", tf, ["gia_tri", "so_san_pham"])]), LogisticRegression(max_iter=3000))
# tf lần lượt: "passthrough", StandardScaler(), RobustScaler(), log1p + StandardScaler
không chuẩn hoá 0.6691 ± 0.0155
StandardScaler 0.6762 ± 0.0133
RobustScaler 0.6762 ± 0.0133
log1p + StandardScaler 0.6831 ± 0.0163
Cùng 2 biến với k-NN (k=25), nơi khoảng cách phụ thuộc trực tiếp vào thang đo:
không chuẩn hoá 0.6416 ± 0.0179
StandardScaler 0.6514 ± 0.0208
log1p + StandardScaler 0.6532 ± 0.0223
Số vòng lặp lbfgs (không chuẩn hoá): 5
Số vòng lặp lbfgs (StandardScaler): 6
Phạt L2 làm nghiệm phụ thuộc thang đo; với C=0.001 (phạt mạnh), CV AUC của Logistic Regression:
C=0.001, không chuẩn hoá 0.6691 ± 0.0155
C=0.001, StandardScaler 0.6728 ± 0.0130
Ví dụ: gia_tri trung bình train = 332719, độ lệch chuẩn = 378333 (mean_/scale_ của scaler)Ba điều đọc được từ số thật trong bước feature engineering này. Thứ nhất, với hồi quy logistic, StandardScaler và RobustScaler cho AUC trùng nhau đến bốn chữ số (0,6762), còn bản không chuẩn hoá thấp hơn một chút (0,6691). LogisticRegression mặc định có phạt L2 với C=1, nên nghiệm tối ưu phụ thuộc thang đo của đặc trưng; việc hai scaler cho kết quả trùng nhau là do chúng đưa đặc trưng về thang tương đương và phạt L2 yếu so với 4.500 mẫu. Dòng C=0.001 minh hoạ chiều ngược lại: khi phạt mạnh, kết quả của hai cách chuẩn hoá lệch nhau (0,6691 so với 0,6728).
Số vòng lặp lbfgs (5 so với 6) trong bản scikit-learn 1.2.0 này không cho thấy lợi thế tốc độ của chuẩn hoá, nên ta không kết luận gì về tốc độ hội tụ từ lần chạy này; đây là chỗ số vòng lặp phụ thuộc phiên bản và tiêu chí dừng của bộ giải.
Thứ hai, k-NN nhạy với thang đo vì khoảng cách bị biến có độ lớn cao nhất chi phối: AUC tăng từ 0,6416 lên 0,6514. Thứ ba, biến đổi log1p trên biến lệch phải (skew 4,48 xuống 0,00) cho thêm một chút, nhưng chênh lệch khoảng 0,007 nhỏ hơn độ lệch chuẩn giữa các fold nên không nên diễn giải quá.
Quy tắc rút ra cho feature engineering biến số: chuẩn hoá nên dùng với mô hình dựa trên khoảng cách (k-NN, SVM, K-Means) và mô hình tuyến tính có regularization (phạt L2 làm nghiệm phụ thuộc thang đo) hoặc tối ưu bằng gradient; không cần với cây quyết định và các mô hình cây tăng cường (bài sau trong series). Biến đổi log hữu ích khi quan hệ với nhãn gần dạng nhân và phân phối lệch nặng, như giá trị đơn hàng.
Feature engineering cho biến phân loại có nhiều giá trị
Biến quan có 80 giá trị, từ quận chỉ có 19 đơn tới quận có 783 đơn. Ta so sánh các cách mã hoá trong feature engineering, mỗi cách đặt trong cùng ColumnTransformer với các biến còn lại (log giá trị, số sản phẩm, size theo thứ tự S < M < L < XL, kênh bán one-hot, cờ "khách mới"):
OneHotEncoder(handle_unknown="infrequent_if_exist", min_frequency=60) # biến thể gộp quận hiếm không dùng quận 0.7236 ± 0.0242
OrdinalEncoder (mã 0..79) 0.7247 ± 0.0234
OneHotEncoder (80 cột) 0.7549 ± 0.0174
OneHot + min_frequency=60 0.7389 ± 0.0167 (18 cột, gộp 63 quận hiếm)Trong feature engineering, OrdinalEncoder gán mã 0 đến 79 theo thứ tự chữ cái, một thứ tự vô nghĩa với quận giao hàng; mô hình tuyến tính coi nó là một đường thẳng và gần như không học được gì (0,7247 so với 0,7236 khi bỏ hẳn biến). Trong feature engineering, chỉ dùng ordinal cho biến có thứ tự thật như size, hoặc cho mô hình cây. OneHotEncoder cho mỗi quận một cột nhị phân và nâng AUC lên 0,7549. Với handle_unknown="ignore", quận lạ xuất hiện ở lúc dự đoán sẽ thành vectơ toàn 0 thay vì làm sập pipeline.
Khi cardinality lên hàng nghìn, feature engineering cho biến phân loại phải tính đến kích thước ma trận: one-hot sinh ma trận rộng. Từ scikit-learn 1.1, min_frequency gộp các giá trị hiếm vào một cột "infrequent". Ở đây min_frequency=60 gộp 63 quận hiếm, còn 18 cột, đổi lấy việc mất thông tin về từng quận hiếm: AUC giảm xuống 0,7389. Đây là đánh đổi có thể điều chỉnh, và nó cũng cho tính ổn định: quận chỉ có 19 đơn thì hệ số học được rất nhiễu.
Target encoding: mạnh nhưng dễ tự làm hỏng
Target encoding là kỹ thuật feature engineering thay mỗi giá trị bằng trung bình nhãn của nhóm đó. Bài báo gốc của Micci-Barreca (SIGKDD Explorations, 2001) đề xuất trộn trung bình nhóm với trung bình toàn cục theo cỡ nhóm, để nhóm nhỏ không bị ước lượng thất thường. Công thức làm mượt ta cài đặt: (n·mean_nhóm + m·mean_toàn_cục) / (n + m), với m là độ mạnh của việc kéo về trung bình chung. Ta tự viết một lớp nhỏ với tuỳ chọn out-of-fold: mỗi dòng huấn luyện chỉ được mã hoá bằng thống kê của các fold còn lại.
for a, b in KFold(5, shuffle=True, random_state=0).split(c):
    mp, mu = fit_map(c.iloc[a], t[a])                    # thống kê chỉ từ các fold khác
    out[b] = c.iloc[b].map(mp).fillna(mu).to_numpy()     # fold b được mã hoá bằng chúng
Để thấy hậu quả, ta tạo một "mã khách" gần như duy nhất (khoảng 3.000 giá trị cho 4.500 dòng, không mang thông tin gì về nhãn) và để HistGradientBoostingClassifier học từ riêng đặc trưng đã mã hoá đó:
[3b] Target encoding cho biến 'ma_khach' gần như duy nhất (ID khách: ~3.000 giá trị cho 4.500 dòng, không mang thông tin)
  ngây thơ (m=1, in-sample)        AUC train = 0.914 | AUC test = 0.503
  out-of-fold (cross-fitting)      AUC train = 0.579 | AUC test = 0.472
Mã hoá ngây thơ cho AUC huấn luyện 0,914 trên một đặc trưng thuần nhiễu, rồi sụp về 0,503 (ngẫu nhiên) trên tập kiểm tra: mô hình chỉ thuộc lòng nhãn của từng dòng thông qua đặc trưng. Bản out-of-fold cho AUC huấn luyện 0,579, gần mức ngẫu nhiên, đúng như sự thật là biến này vô dụng. Điểm cốt lõi: đặc trưng tính từ nhãn phải tính không dùng nhãn của chính dòng đó.
Với biến có tín hiệu thật và cỡ nhóm lớn, kết quả khác hẳn:
[3c] Target encoding quận (80 giá trị, có tín hiệu thật) với LogisticRegression trên cả bảng
  in-sample, m=20      AUC train = 0.7706 | AUC test = 0.7607
  out-of-fold, m=20    AUC train = 0.7528 | AUC test = 0.7591
  (so sánh) OneHot 80 cột:  AUC train = 0.7737 | AUC test = 0.7629
Mỗi quận trung bình có khoảng 56 đơn nên rò rỉ nhỏ: AUC kiểm tra gần nhau và one-hot không thua (0,7629). Chỉ cột AUC huấn luyện khác: bản in-sample lạc quan hơn, bản out-of-fold sát điểm kiểm tra hơn. Kết luận trung thực: target encoding đáng dùng khi cardinality rất lớn (mã bưu chính, mã sản phẩm); với vài chục giá trị, one-hot đủ tốt.
Feature engineering cho thời gian: biến vòng và cách tách thành phần
Giờ đặt hàng là biến tuần hoàn: 23 giờ và 0 giờ cách nhau một tiếng, nhưng trên trục số 0..23 chúng cách nhau 23 đơn vị. Cách feature engineering phổ biến là biểu diễn bằng cặp sin và cos của 2π·giờ/24, để giờ nằm trên một đường tròn. Ta so ba cách trên cùng bảng:
np.c_[np.sin(2 * np.pi * h / 24), np.cos(2 * np.pi * h / 24)] # h = giờ đặt, 0..23 gio_dat thô (0..23) tuyến tính 0.7281 ± 0.0206
sin/cos của gio_dat 0.7507 ± 0.0209
OneHot 24 giờ 0.7488 ± 0.0198Giờ thô gần như không giúp gì (0,7281 so với 0,7236 khi không có), trong khi sin/cos nâng lên 0,7507 chỉ bằng hai cột, ngang với one-hot 24 cột (0,7488). Biến đổi này trong feature engineering hợp với dữ liệu của ta vì nhãn sinh theo cosin của giờ; trên dữ liệu thật hãy vẽ tỉ lệ nhãn theo giờ trước khi chọn. Tương tự cho thứ, tháng; với ngay_dat đầy đủ, hãy tách thứ, tuần, cờ cuối tuần và ngày lễ thay vì đưa timestamp thô.
Rò rỉ dữ liệu trong feature engineering: bốn dạng hay gặp
Mục Common pitfalls and recommended practices của scikit-learn định nghĩa rò rỉ dữ liệu là việc dùng thông tin không có sẵn tại thời điểm dự đoán để xây mô hình, dẫn tới ước lượng hiệu năng quá lạc quan, và nêu quy tắc: không bao giờ gọi fit trên dữ liệu kiểm tra. Ta tái hiện bốn dạng rò rỉ trong feature engineering bằng số thật, vì feature engineering sai cách là nguồn rò rỉ phổ biến nhất.
Dạng 1: chọn đặc trưng trên toàn bộ dữ liệu
Tài liệu trên dùng ví dụ 200 mẫu, 10.000 đặc trưng ngẫu nhiên, nhãn ngẫu nhiên. Ta làm lại theo cùng tinh thần: đúng ra không mô hình nào vượt quá 0,5 accuracy.
SelectKBest(f_classif, k=25).fit(Xn, yn)     # SAI: chọn đặc trưng bằng cả nhãn của tập kiểm tra
make_pipeline(SelectKBest(f_classif, k=25), LogisticRegression(max_iter=1000)).fit(Xa, ya)   # ĐÚNG
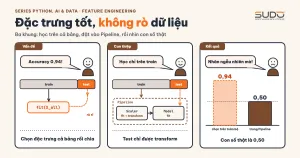
Nhãn ngẫu nhiên, 10.000 đặc trưng nhiễu, 200 mẫu (đúng ra accuracy ≈ 0.5)
- chọn đặc trưng trên TOÀN BỘ dữ liệu rồi chia: accuracy test = 0.94
- Pipeline (chọn trên train của từng lần): accuracy test = 0.50
- CV 5-fold, chọn trước: 0.88 | CV 5-fold với Pipeline: 0.53Accuracy 0,94 trên dữ liệu thuần nhiễu là con số đủ để thuyết phục cả một ban giám đốc, và hoàn toàn sai. Khi bước chọn đặc trưng nằm trong Pipeline, nó chỉ học trên phần huấn luyện của từng fold và kết quả trở về mức ngẫu nhiên 0,50 và 0,53, đúng với sự thật.
Dạng 2: chuẩn hoá hoặc điền thiếu trước khi chia
Dạng hiền hơn nhưng phổ biến nhất trong feature engineering. Trung bình giá trị đơn trên tập huấn luyện là 332.719, trên toàn bộ là 333.553. Để đo tác hại, ta so k-NN trên hai biến số khi StandardScaler được fit trên toàn bộ dữ liệu (cả tập kiểm tra) và khi chỉ fit trên tập huấn luyện:
  k-NN, scaler fit trên TOÀN BỘ (train + test)   AUC test = 0.6792
  k-NN, scaler fit chỉ trên train                AUC test = 0.6801
Hai số gần như bằng nhau (thậm chí bản rò rỉ thấp hơn một chút do nhiễu): với 6.000 dòng và một bước chuẩn hoá đơn giản, rò rỉ này không đo được. Điều đó không có nghĩa là an toàn. Nó nguy hiểm khi bước tiền xử lý mạnh hơn (chọn đặc trưng như ở dạng 1, PCA, target encoding), nên hãy luôn dùng Pipeline.
Dạng 3: đặc trưng chỉ biết sau sự kiện
Ta thêm cột da_hoan_tien (đơn đã có phiếu hoàn tiền hay chưa), một cột sinh ra sau khi đơn bị hoàn:
  Đặc trưng ['gia_tri', 'so_san_pham']                    AUC test = 0.6671
  Đặc trưng ['gia_tri', 'so_san_pham', 'da_hoan_tien']    AUC test = 0.9494
  (da_hoan_tien chỉ biết sau khi đơn đã bị hoàn -> khi dự đoán thật sẽ không có)
AUC nhảy từ 0,6671 lên 0,9494, nhưng lúc dự đoán đơn mới, cột này chưa tồn tại. Loại rò rỉ này nằm ở nghiệp vụ chứ không ở code. Câu hỏi kiểm tra cho từng cột: "tại thời điểm cần dự đoán, ta có giá trị này chưa?". Dấu hiệu cảnh báo là một đặc trưng đơn lẻ có độ quan trọng cao đến khó tin.
Dạng 4: nhìn vào tương lai khi tổng hợp theo thời gian
Đặc trưng tổng hợp như "tỉ lệ hoàn của quận trong tuần" rất tự nhiên với dữ liệu giao dịch. Nhưng nếu tính bằng groupby(...).transform("mean"), mỗi đơn được tính cùng các đơn đến sau nó trong tuần, và cả nhãn của chính nó. Phiên bản đúng chỉ dùng các đơn đã xảy ra trước đó, làm mượt về tỉ lệ chung:
g = d2.groupby(["quan", "tuan"])["y"]
d2["ty_le_tuan_ca_tuan"] = g.transform("mean")                       # SAI: gồm cả đơn hiện tại và các đơn sau đó
cum_sum = g.cumsum() - d2["y"]; cum_cnt = g.cumcount()               # ĐÚNG: chỉ các đơn đã xảy ra trước đó trong tuần
d2["ty_le_tuan_qua_khu"] = ((cum_sum + 0.4 * 5) / (cum_cnt + 5))
[6] Rò rỉ theo thời gian: tỉ lệ hoàn của quận trong tuần
chỉ gia_tri, so_san_pham AUC test (25% cuối) = 0.6550
+ ty_le_tuan_qua_khu AUC test (25% cuối) = 0.6599
+ ty_le_tuan_ca_tuan AUC test (25% cuối) = 0.8365
Số đơn trung bình mỗi (quận, tuần): 3.6Vì mỗi nhóm (quận, tuần) chỉ có khoảng 3,6 đơn, "trung bình cả tuần" gần như chứa luôn nhãn của chính dòng đó nên AUC vọt lên 0,8365, trong khi bản chỉ dùng quá khứ gần như không đổi (0,6599 so với 0,6550, đúng vì tín hiệu thật ở đây yếu). Bài học: đặc trưng tổng hợp theo thời gian phải "tính tới thời điểm t", và khi dữ liệu có chiều thời gian hãy chia train/test theo thời gian.
Ghép feature engineering vào Pipeline không rò rỉ
Ba nguyên tắc biến feature engineering ở trên thành thói quen cho mọi dự án feature engineering sau này: chia dữ liệu trước mọi thao tác học; đặt mọi biến đổi có fit vào Pipeline và ColumnTransformer để cross-validation học lại từ đầu trong từng fold; coi mọi đặc trưng dẫn xuất từ nhãn hoặc từ tương lai là nghi phạm.
Khi nào không nên làm thêm feature engineering
- Dữ liệu quá ít: feature engineering thêm cột chỉ thêm khả năng overfit, nhất là khi số cột gần bằng số dòng.
- Mô hình cây: feature engineering kiểu chuẩn hoá là thừa, vì cây không cần chuẩn hoá và ít nhạy với phép biến đổi đơn điệu như log; hãy dồn công sức vào đặc trưng nghiệp vụ (tỉ lệ, khoảng cách thời gian, tổng hợp theo khách).
- Feature engineering tự động hàng loạt: dễ tạo tương quan giả, khó giải thích; mỗi đặc trưng nên có giả thuyết nghiệp vụ.
Lỗi thường gặp và checklist feature engineering
Lỗi thường gặp: gọi fit_transform trên tập kiểm tra; quên handle_unknown nên pipeline sập khi gặp giá trị mới; dùng ordinal encoding cho biến không có thứ tự với mô hình tuyến tính hoặc k-NN; target encoding không out-of-fold, nhất là với biến gần như duy nhất như mã khách; chia ngẫu nhiên cho dữ liệu có thời gian rồi ngạc nhiên khi mô hình kém sau triển khai.
Checklist:
- Feature engineering có học (scaler, encoder, chọn đặc trưng) chỉ chạy sau khi chia train/test, theo thời gian nếu dữ liệu có thời gian.
- Mọi bước nằm trong
Pipeline; đánh giá bằng cross-validation phân tầng, chạm tập kiểm tra một lần. - Biến số: chuẩn hoá cho mô hình dựa trên khoảng cách hoặc gradient; log cho biến lệch phải.
- Biến phân loại: one-hot với
handle_unknownvàmin_frequency; ordinal chỉ cho biến có thứ tự; target encoding luôn out-of-fold. - Biến tuần hoàn (giờ, thứ, tháng): sin/cos hoặc one-hot, không dùng số thô.
- Với mỗi đặc trưng mới, hỏi: có sẵn lúc dự đoán không, có dùng nhãn hay dữ liệu tương lai không.
Mã nguồn đầy đủ nằm trong code/s7-13 (fe_demo.py, output.txt, requirements.txt); chạy bằng python fe_demo.py trong venv. Mọi số liệu là output thật trên Apple M4, 16 GB, Python 3.10, scikit-learn 1.2.0, pandas 1.5.3; dữ liệu giả lập với hạt giống cố định nên chạy lại cho cùng kết quả trên cùng phiên bản (phiên bản thư viện khác có thể lệch ở chữ số thập phân cuối).
Bài tiếp theo
Gradient boosting với XGBoost và LightGBM: khi nào thắng deep learning. Sau khi feature engineering xong và có bảng đặc trưng sạch, bài sau giới thiệu các mô hình cây tăng cường, thứ thường cho kết quả tốt nhất trên dữ liệu bảng, và so sánh trung thực với mạng nơ-ron.