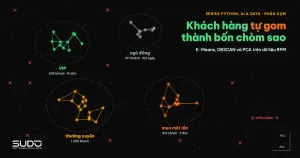
Khách mua một lần, khách thường xuyên và khách VIP cần thông điệp khác nhau, nhưng không ai muốn chia nhóm theo cảm tính. Phân cụm (clustering) giải quyết đúng chỗ này: thuật toán tự gom các khách hàng giống nhau mà không cần nhãn có sẵn. Bài này đi qua ba công cụ cốt lõi của phân cụm trong scikit-learn là K-Means, DBSCAN và PCA, trên dữ liệu RFM (recency, frequency, monetary) giả lập 3.000 khách, mọi con số đều là output thật chạy trên máy.
Bài phân cụm này mở đầu nhóm bài về học không giám sát, nối tiếp Giải thích mô hình với SHAP: biết vì sao mô hình quyết định (học có giám sát) và dùng lại kiến thức chuẩn hoá ở Feature engineering cho dữ liệu bảng: mã hoá, chuẩn hoá và rò rỉ dữ liệu. Môi trường chạy lại: Apple M4, 16 GB, scikit-learn 1.9.1, NumPy 2.5.4, pandas 3.1.1.
Mọi API dùng trong bài (KMeans, DBSCAN, PCA, silhouette_score, davies_bouldin_score, NearestNeighbors, np.random.default_rng, groupby().agg dạng named aggregation) đã có từ scikit-learn 1.2, NumPy 1.24 và pandas 1.5, là các bản phổ biến vào tháng 4/2023. Dữ liệu hoàn toàn giả lập.
Bài toán phân cụm khách hàng và dữ liệu RFM
Để phân cụm, phân tích RFM mô tả mỗi khách bằng ba con số: recency là số ngày kể từ lần mua cuối, frequency là số đơn trong 12 tháng, monetary là tổng chi tiêu. Ba số này đủ để tách các hành vi mua sắm cơ bản. Trong bài, ta sinh dữ liệu từ bốn nhóm ẩn (mua một lần, thường xuyên, VIP, ngủ đông) rồi giấu nhãn đi, để có thể kiểm tra xem thuật toán tìm lại được cấu trúc ẩn đến đâu. Trong thực tế bạn không có nhãn này, và đó là điểm khó nhất của phân cụm: không có đáp án để chấm.
def seg(n, rec, freq, mon, label):
    return pd.DataFrame({
        "recency_days": rng.gamma(4, rec / 4, n).clip(1, 365),
        "frequency": rng.poisson(freq, n) + 1,
        "monetary_vnd": rng.lognormal(np.log(mon), 0.35, n),
        "true_segment": label})

df = pd.concat([seg(900, 120, 1, 400_000, "mua một lần"),
                seg(1400, 45, 4, 1_800_000, "thường xuyên"),
                seg(500, 12, 14, 9_000_000, "VIP"),
                seg(200, 250, 5, 2_500_000, "ngủ đông")], ignore_index=True)
Output thật khi mô tả dữ liệu cho thấy ngay vấn đề thang đo: monetary_vnd có trung bình khoảng 2,77 triệu và giá trị lớn nhất hơn 24 triệu, trong khi frequency trung bình chỉ 6 đơn.
[Dữ liệu] shape = (3000, 3)
      recency_days  frequency  monetary_vnd
mean          73.0        6.0     2769610.0
50%           49.0        4.0     1690528.0
max          365.0       28.0    24068896.0
K-Means: cách thuật toán hoạt động
Theo tài liệu Clustering của scikit-learn, K-Means chọn các tâm cụm (centroid) sao cho tối thiểu hoá inertia, tức tổng bình phương khoảng cách từ mỗi điểm tới tâm gần nhất. Thuật toán Lloyd lặp hai bước: gán mỗi điểm vào tâm gần nhất, rồi tính lại mỗi tâm là trung bình các điểm được gán, và dừng khi tâm dịch chuyển nhỏ hơn dung sai. Thuật toán luôn hội tụ nhưng có thể chỉ tới một cực tiểu địa phương, nên tài liệu khuyên chạy nhiều lần với khởi tạo khác nhau. Khởi tạo k-means++ (mặc định) đặt các tâm ban đầu cách xa nhau, thường cho kết quả tốt hơn khởi tạo ngẫu nhiên.
Hệ quả của việc tối thiểu hoá bình phương khoảng cách Euclid là K-Means ngầm giả định các cụm lồi và có dạng cầu. Tài liệu nói rõ inertia "phản ứng kém với cụm kéo dài hoặc đa tạp có hình dạng bất thường", và không chuẩn hoá nên trong không gian nhiều chiều, khoảng cách Euclid phồng lên theo lời nguyền số chiều. Ta sẽ thấy cả hai điểm yếu này bằng số liệu bên dưới.
Chuẩn hoá trước khi phân cụm
Vì dựa trên khoảng cách, mọi thuật toán phân cụm đều nhạy với thang đo. Thí nghiệm đầu tiên của bài phân cụm này: chạy K-Means với k = 4 trên dữ liệu thô, rồi so với nhóm thật bằng chỉ số ARI (adjusted Rand index, 1 là khớp hoàn toàn, 0 là ngẫu nhiên). Tiếp theo, ta lấy logarit của cả ba cột (các cột này lệch phải) rồi chuẩn hoá bằng StandardScaler.
X = df.copy()
for c in X.columns:
    X[c] = np.log1p(X[c])
Xs = StandardScaler().fit_transform(X)
km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Xs)
[K-Means trên dữ liệu thô] ARI so với nhóm thật = 0.481 | silhouette = 0.592
Có hai điều đáng chú ý. Thứ nhất, trên dữ liệu thô, cột tiền gần như quyết định mọi thứ nên ARI chỉ 0,481; sau khi log và chuẩn hoá, ARI ở k = 4 tăng lên 0,866 (xem bảng ở mục kế tiếp). Thứ hai, silhouette trên dữ liệu thô (0,592) cao hơn sau chuẩn hoá (0,457), dù cụm chuẩn hoá đúng hơn nhiều: silhouette đo độ tách trong chính không gian tính khoảng cách, và một chiều chiếm ưu thế làm cụm trông tách rõ theo chiều đó. Đừng so silhouette giữa hai không gian đặc trưng khác nhau.
Chọn số cụm k khi phân cụm
Khi phân cụm bằng K-Means, bạn bắt buộc đưa ra k. Ba công cụ nội bộ phổ biến là inertia (phương pháp khuỷu tay), silhouette và Davies-Bouldin. Theo tài liệu scikit-learn, hệ số silhouette của một mẫu là (b - a) / max(a, b), trong đó a là khoảng cách trung bình tới các điểm cùng cụm và b là khoảng cách trung bình tới cụm gần nhất còn lại; giá trị càng cao thì cụm càng rõ. Chỉ số Davies-Bouldin thì càng thấp càng tốt, thấp nhất là 0. Ta quét k từ 2 tới 7 và thêm cột ARI (chỉ có ở dữ liệu giả lập) để đối chiếu:
[Chọn k] k | inertia | silhouette | davies_bouldin | ARI
  2 |    4523.4 | 0.472 | 0.707 | 0.272
  3 |    2430.8 | 0.478 | 0.767 | 0.814
  4 |    1842.0 | 0.457 | 0.806 | 0.866
  5 |    1594.6 | 0.391 | 0.981 | 0.682
  6 |    1413.0 | 0.385 | 0.908 | 0.610
  7 |    1241.9 | 0.340 | 1.043 | 0.500
Kết quả thật không "đẹp như sách": silhouette cao nhất ở k = 3 (0,478), Davies-Bouldin tốt nhất ở k = 2 (0,707), còn k = 4, cấu trúc thật của dữ liệu, chỉ đứng thứ hai về silhouette. Inertia luôn giảm khi tăng k nên khuỷu tay chỉ thấy rõ chỗ gãy quanh k = 3 đến 4.
Nhiều khả năng do nhóm "ngủ đông" chỉ có 200 khách và nằm sát nhóm "thường xuyên" trong không gian log, nên chỉ số nội bộ ưu tiên gộp lại. Hai bằng chứng trong output ở mục hồ sơ cụm bên dưới: ở k = 3, 192 trong 200 khách ngủ đông nằm chung cụm với 1.356 khách thường xuyên; ở k = 4, tâm cụm ngủ đông cách tâm cụm gần nhất (1,54 đơn vị chuẩn hoá) gần hơn hẳn các cụm còn lại (2,08 và 3,28). Cách làm đúng là dùng các chỉ số này để thu hẹp k (3 đến 5), rồi chọn theo nghiệp vụ: 200 khách ngủ đông có đáng một chiến dịch riêng không?
Phân cụm bằng K-Means không ổn định nếu bỏ n_init
Tham số n_init là số lần chạy với các tâm khởi tạo khác nhau; scikit-learn giữ lần có inertia thấp nhất. Để thấy tác dụng, ta cố ý dùng init="random" và chạy với 8 hạt giống:
[Độ ổn định, k=4] inertia qua 8 hạt giống
  init=random n_init= 1: min=1842.0 max=2231.7 số giá trị khác nhau=3
  init=random n_init=10: min=1842.0 max=1842.0 số giá trị khác nhau=1
Với một lần khởi tạo, có hạt giống rơi vào cực tiểu địa phương có inertia 2231,7, tệ hơn nghiệm tốt nhất 21%. Với 10 lần khởi tạo, cả 8 hạt giống đều ra cùng nghiệm 1842,0.
Đọc hồ sơ sau khi phân cụm, không chỉ nhìn nhãn
Kết quả phân cụm chỉ có giá trị khi người làm kinh doanh gọi được tên từng cụm. Cách chuẩn là tính trung vị (hoặc trung bình) của các biến gốc theo cụm, và giữ nguyên đơn vị dễ hiểu (ngày, đơn, đồng):
prof = df.assign(cum=km.labels_).groupby("cum").agg(
    n=("frequency", "size"), recency=("recency_days", "median"),
    frequency=("frequency", "median"), monetary=("monetary_vnd", "median"))
[Hồ sơ cụm, k=4] (trung vị theo cụm)
        n  recency  frequency   monetary
cum
0     317    162.0        6.0  2199907.0
1    1265     39.0        5.0  1803001.0
2     913    103.0        2.0   402657.0
3     505     11.0       15.0  8891129.0
Đọc bảng: cụm 3 (505 khách) mua mới nhất, 15 đơn, gần 8,9 triệu: nhóm VIP. Cụm 1 (1.265 khách) mua đều, chi tiêu vừa: nhóm thường xuyên. Cụm 2 (913 khách) mua ít, chi ít: mua một lần. Cụm 0 (317 khách) từng chi khá nhưng đã 162 ngày chưa quay lại: nhóm cần kéo về. So với nhóm thật, bảng chéo cho thấy K-Means gom gần như đúng:
true_segment  VIP  mua một lần  ngủ đông  thường xuyên
row_0
0               0            2       197           118
1               1            9         3          1252
2               0          889         0            24
3             499            0         0             6
Cụm 0 chứa 197 trên 200 khách ngủ đông nhưng lẫn 118 khách thường xuyên (những người lâu chưa mua, đúng là nên được coi như sắp ngủ đông). Để kiểm tra lý do chỉ số nội bộ ưa k = 3, ta in thêm bảng chéo ở k = 3 và khoảng cách giữa tâm cụm 0 với ba tâm còn lại:
[Bảng chéo k=3: nhóm ngủ đông bị gộp ở đâu]
true_segment  VIP  mua một lần  ngủ đông  thường xuyên
row_0
0             499            0         0            18
1               0          889         8            26
2               1           11       192          1356
[Khoảng cách tâm cụm 0 (ngủ đông) tới tâm các cụm k=4 khác, trong không gian chuẩn hoá] [1.54 2.08 3.28]
Ở k = 3, 192 khách ngủ đông bị gộp vào cụm 2 cùng 1.356 khách thường xuyên, đúng như suy đoán. Khoảng cách 1,54 tới cụm thường xuyên (cụm 1) nhỏ nhất trong ba khoảng cách.
PCA: giảm chiều để trực quan hoá và hỗ trợ phân cụm
PCA (principal component analysis) tìm các trục trực giao mà dữ liệu biến thiên nhiều nhất. Theo tài liệu Decomposition của scikit-learn, PCA căn giữa dữ liệu nhưng không tự chuẩn hoá thang đo trước khi chạy SVD, vì vậy phải chuẩn hoá trước như ta đã làm. Trong ngữ cảnh phân cụm, PCA có hai vai trò: vẽ dữ liệu nhiều chiều lên mặt phẳng 2D, và giảm nhiễu trước khi chạy K-Means (tài liệu ghi PCA trước K-Means "có thể giảm bớt" vấn đề số chiều và tăng tốc). Kết quả trên dữ liệu RFM:
[PCA] explained_variance_ratio_ = [0.792 0.147 0.061] | tích luỹ = [0.792 0.939 1.   ]
  thành phần PC1 (recency, frequency, monetary) = [-0.538  0.591  0.601]
  K-Means trên 2 PC: silhouette = 0.514, ARI = 0.834
PC1 giải thích 79,2% phương sai, với trọng số âm cho recency và dương cho frequency lẫn monetary: đây là trục "mức độ gắn bó" của khách (mua gần, mua nhiều, chi nhiều). Hai thành phần đầu giữ 93,9% phương sai, đủ để vẽ biểu đồ phân tán theo cụm. K-Means trên hai thành phần cho ARI 0,834, thấp hơn một chút so với 0,866 khi dùng đủ ba chiều: giảm chiều luôn mất thông tin, và 6,1% phương sai bị bỏ đi ở đây vẫn chứa chút tín hiệu.
PCA có cứu được dữ liệu nhiều chiều không?
Ta thử mô phỏng tình huống khó hơn: thêm 20 cột nhiễu Gaussian vào dữ liệu đã chuẩn hoá (tổng cộng 23 chiều), rồi so K-Means trực tiếp với K-Means sau khi PCA xuống 3 chiều.
[Thêm 20 cột nhiễu] 23 chiều: ARI = 0.570 | PCA 3 chiều rồi K-Means: ARI = 0.565
Nhiễu làm ARI rơi từ 0,866 xuống 0,570, và PCA 3 chiều không cứu được (0,565). Lý do: PCA chỉ giữ hướng có phương sai lớn, mà 20 cột nhiễu độc lập mỗi cột đều có phương sai 1, ngang với nhiều thành phần tín hiệu, nên các thành phần giữ lại vẫn lẫn nhiễu. PCA không phân biệt tín hiệu với nhiễu; nó chỉ biết phương sai. Với phân cụm, biện pháp hiệu quả hơn là chọn đặc trưng có ý nghĩa nghiệp vụ ngay từ đầu. PCA vẫn rất hữu ích để trực quan hoá và nén các đặc trưng tương quan cao, nhưng đừng coi nó là phép chữa mọi vấn đề số chiều.
DBSCAN: phân cụm theo mật độ
DBSCAN (Ester, Kriegel, Sander, Xu, KDD 1996) nhìn cụm như vùng mật độ cao ngăn cách nhau bởi vùng mật độ thấp. Hai tham số: eps là bán kính lân cận, min_samples là số điểm tối thiểu trong bán kính đó để một điểm trở thành core point. Một cụm là tập các core point nối được với nhau cộng các điểm biên gần chúng; điểm không thuộc cụm nào được gán nhãn -1 (nhiễu). Theo bài báo gốc KDD-96 và tài liệu sklearn.cluster.DBSCAN, ưu điểm là không cần chọn số cụm, tìm được cụm hình dạng bất kỳ và có khái niệm nhiễu; nhược điểm là khó chọn eps, và kém khi các cụm có mật độ rất khác nhau.
Để thấy khác biệt với K-Means, ta dùng bộ dữ liệu hai hình trăng khuyết (1.500 điểm, nhiễu Gaussian 0,07) cộng thêm 30 điểm ngoại lai rải ngẫu nhiên:
M, ym = make_moons(1500, noise=0.07, random_state=0)
M = np.vstack([M, rng.uniform(-1.5, 2.5, (30, 2))])
kmm = KMeans(n_clusters=2, n_init=10, random_state=0).fit(M)
db = DBSCAN(eps=0.15, min_samples=8).fit(M)
[Dữ liệu hình trăng khuyết] K-Means vs DBSCAN
  K-Means: ARI = 0.249
  DBSCAN : ARI = 0.991 | số cụm = 2 | điểm nhiễu = 25
K-Means cắt đôi hai hình trăng bằng một đường thẳng (ARI 0,249) vì giả định cụm lồi; DBSCAN lần theo hình dạng và tìm đúng hai cụm (ARI 0,991), đồng thời đánh dấu 25 điểm nhiễu.
Chọn eps và min_samples cho phân cụm DBSCAN
Tài liệu scikit-learn nhấn mạnh eps "rất quan trọng và thường không thể để mặc định". Thử quét eps với min_samples=8 trên dữ liệu trăng khuyết:
[DBSCAN: ảnh hưởng của eps, min_samples=8]
  eps=0.05: cụm=15, nhiễu=296
  eps=0.10: cụm=2, nhiễu=32
  eps=0.15: cụm=2, nhiễu=25
  eps=0.30: cụm=1, nhiễu=22
  eps=0.60: cụm=1, nhiễu=12
Quá nhỏ (0,05) thì vỡ thành 15 cụm và 296 điểm nhiễu; quá lớn (0,30 trở lên) thì hai hình trăng dính vào nhau thành một cụm. Chỉ vùng hẹp 0,10 đến 0,15 cho đáp án đúng. Cách chọn có phương pháp là vẽ k-distance graph: với mỗi điểm, lấy khoảng cách tới láng giềng thứ k (k bằng min_samples), sắp xếp rồi tìm "khuỷu tay". Phân vị của k-distance trên dữ liệu này:
k-distance (k=8) các phân vị 50/90/95/98/99: [0.048 0.082 0.102 0.146 0.633]
Khoảng cách tăng chậm tới phân vị 98 (0,146) rồi nhảy vọt ở phân vị 99 (0,633): phần nhảy đó là các điểm ngoại lai, và eps hợp lý nằm ngay trước chỗ gãy, khoảng 0,15. Với min_samples, quy tắc thường dùng là ít nhất số chiều cộng một, tăng lên với dữ liệu nhiễu.
Phân cụm khách hàng bằng DBSCAN thật sự khó hơn
Áp DBSCAN để phân cụm ba chiều RFM đã chuẩn hoá cho thấy giới hạn của nó khi các cụm gối lên nhau và có mật độ khác nhau:
[DBSCAN trên khách hàng 3 chiều đã chuẩn hoá]
  k-distance (k=10) phân vị 50/90/95/99: [0.198 0.377 0.459 0.632]
  eps=0.2: cụm=12, nhiễu=949 (31.6%), ARI=0.135
  eps=0.3: cụm=7, nhiễu=252 (8.4%), ARI=0.536
  eps=0.4: cụm=4, nhiễu=67 (2.2%), ARI=0.480
  eps=0.6: cụm=2, nhiễu=9 (0.3%), ARI=0.072
Không có eps nào cho ARI gần mức 0,866 của K-Means. Ở eps=0.4 DBSCAN ra đúng 4 cụm nhưng ARI chỉ 0,480, vì khách VIP mật độ thấp bị coi là nhiễu và các nhóm kề nhau bị nối thành một. Dữ liệu hành vi khách hàng thường liên tục, không có "thung lũng" mật độ rõ, nên K-Means thường là lựa chọn đầu tiên. DBSCAN phù hợp hơn khi cụm có hình dạng lạ (toạ độ địa lý, quỹ đạo), khi cần loại nhiễu, hoặc để phát hiện điểm bất thường, chủ đề của bài sau.
So sánh hai cách phân cụm: K-Means và DBSCAN
| Tiêu chí | K-Means | DBSCAN |
|---|---|---|
| Cần chọn số cụm | Có (k) | Không, nhưng phải chọn eps và min_samples |
| Hình dạng cụm | Lồi, dạng cầu | Bất kỳ |
| Xử lý nhiễu | Không, mọi điểm đều vào một cụm | Có, nhãn -1 |
| Mật độ khác nhau | Chịu được nếu cụm vẫn lồi | Kém |
| Dự đoán điểm mới | Có, predict | Không có predict trong scikit-learn |
Khi nào không nên dùng phân cụm
- Đã có nhãn: nếu bạn có biến mục tiêu (rời bỏ, mua lại), hãy dùng học có giám sát; phân cụm chỉ là bước khám phá, không thay được.
- Chỉ số nội bộ không phải đáp án phân cụm: như bảng chọn k ở trên, silhouette và Davies-Bouldin có thể chọn k khác với cấu trúc nghiệp vụ.
- Kết quả phân cụm phụ thuộc đặc trưng và thang đo: đổi cách log hoặc chuẩn hoá là cụm đổi. Ghi lại phép biến đổi cùng mô hình.
- Phân cụm không ổn định theo thời gian: khách đổi hành vi, cần chạy lại định kỳ.
Lỗi thường gặp khi phân cụm
- Quên chuẩn hoá trước khi phân cụm, hoặc quên log cho biến tiền lệch phải: một cột lấn át, như ARI 0,481 ở trên.
- Phân cụm rồi dừng ở nhãn số, không kiểm tra hồ sơ cụm bằng đơn vị gốc.
- Để
n_initquá thấp vớiinit="random", nghiệm rơi vào cực tiểu địa phương (inertia 2231,7 so với 1842,0). - Để DBSCAN dùng
epsmặc định (0,5) trên dữ liệu khác thang đo: ra một cụm khổng lồ hoặc toàn nhiễu.
Checklist
- Chọn đặc trưng theo nghiệp vụ (RFM), log hoá biến lệch, chuẩn hoá bằng
StandardScaler. - Trước khi phân cụm lại, quét k, xem inertia, silhouette, Davies-Bouldin, rồi chốt bằng ý nghĩa kinh doanh.
- Dùng
k-means++hoặcn_initđủ lớn, đặtrandom_state. - Khi phân cụm theo mật độ với DBSCAN, vẽ k-distance trước khi chọn
eps, ghi lại tỉ lệ nhiễu. - Dùng PCA để trực quan hoá kết quả phân cụm, kèm
explained_variance_ratio_. - Sau mỗi lần phân cụm, luôn lập bảng hồ sơ cụm bằng đơn vị gốc và đặt tên cụm.
Mã nguồn đầy đủ trong code/s7-16 (cluster_demo.py, output.txt, requirements.txt), chạy bằng python cluster_demo.py. Mọi số liệu là output thật từ Apple M4, 16 GB, scikit-learn 1.9.1 với hạt giống cố định; dữ liệu giả lập, ARI chỉ tính được vì ta biết nhóm thật.
Bài tiếp theo
Phát hiện bất thường trong giao dịch: Isolation Forest và autoencoder. Nhãn nhiễu của DBSCAN là dạng đơn giản nhất của phát hiện bất thường; bài sau đi tiếp với Isolation Forest và autoencoder, kèm cách chấm điểm khi hầu như không có nhãn gian lận.