Trong 60.300 giao dịch của một cửa hàng trực tuyến, chỉ 300 giao dịch (0,5%) là bất thường: số tiền lớn lúc nửa đêm, đơn giao đến nơi rất xa địa chỉ quen, hàng chục lượt mua dồn dập trong 24 giờ. Không ai gắn nhãn sẵn cho chúng. Đó là bài toán phát hiện bất thường (anomaly detection) điển hình: tìm những quan sát khác biệt rõ rệt so với phần còn lại khi hầu như không có nhãn. Bài này so sánh ba hướng trong phát hiện bất thường là Isolation Forest, Local Outlier Factor (LOF) và autoencoder bằng PyTorch, trên dữ liệu giả lập, với output thật và cả những kết quả không như kỳ vọng.
Bài nối tiếp Phân cụm khách hàng: K-Means, DBSCAN và giảm chiều với PCA, nơi nhãn nhiễu của DBSCAN đã là một dạng phát hiện bất thường sơ khai, và dùng lại các chỉ số của Đánh giá mô hình phân loại: precision, recall, ROC và dữ liệu lệch. Môi trường chạy lại: máy Apple Silicon 16 GB, CPU, Python 3.11, scikit-learn 1.2.2, PyTorch 2.0.1, NumPy 1.24.3. Dữ liệu hoàn toàn giả lập, không phải giao dịch thật.
Bài toán phát hiện bất thường và vì sao khó
Theo tài liệu Novelty and Outlier Detection của scikit-learn, có hai tình huống cần phân biệt. Outlier detection (không giám sát): dữ liệu huấn luyện đã lẫn các điểm ngoại lai, mô hình cố khớp vùng mật độ cao và bỏ qua phần lệch. Novelty detection (bán giám sát): dữ liệu huấn luyện sạch, và mục tiêu là xét xem quan sát mới có lạ không. Khi phát hiện bất thường trong giao dịch thực tế, ta thường rơi vào trường hợp đầu: lịch sử đã lẫn gian lận mà chưa ai biết.
Phát hiện bất thường khó ở ba lớp. Thứ nhất, lớp bất thường rất hiếm nên accuracy vô nghĩa, phải dùng ROC AUC, average precision (AP) và precision tại top-K như bài đánh giá mô hình đã trình bày. Thứ hai, phát hiện bất thường phải đối mặt với nhiều dạng khác nhau, mỗi mô hình bắt dạng này và bỏ sót dạng khác. Thứ ba, không có nhãn thì không biết ngưỡng cảnh báo nên đặt ở đâu. Theo tổng quan của Chandola và cộng sự (2009), bài này chỉ xét bất thường dạng điểm trên dữ liệu bảng.
Dữ liệu giao dịch giả lập cho phát hiện bất thường
Mỗi giao dịch có năm đặc trưng: số tiền (amount_vnd, lognormal quanh 160 nghìn đồng), giờ trong ngày, số mặt hàng, khoảng cách tới địa chỉ quen và số giao dịch trong 24 giờ gần nhất. Để thử phát hiện bất thường, ta chèn 300 giao dịch bất thường chia đều bốn loại: tiền rất lớn lúc 0 đến 5 giờ sáng, khoảng cách 300 đến 900 km, dồn dập trên 8 giao dịch trong 24 giờ, và giỏ hàng 30 mặt hàng trở lên. Tập được chia 70% huấn luyện (không dùng nhãn, vẫn lẫn 211 giao dịch bất thường) và 30% để chấm điểm.
[Dữ liệu] n = 60300 | bất thường = 300 (0.50%)
      amount_vnd  hour  items  distance_km  tx_24h
mean    229556.9  13.9    3.0          6.7     1.2
50%     162098.1  13.9    3.0          5.1     1.0
max    8937694.1  24.0   36.0        892.4    23.0
train: 42210 (bất thường lẫn trong train: 211) | test: 18090 (bất thường: 89)

[Mức ngẫu nhiên] AP của đoán ngẫu nhiên = 0.0049
Một bộ chấm điểm ngẫu nhiên có AP bằng tỉ lệ dương, 0,0049; hãy đọc mọi AP so với mốc này.
Isolation Forest: phát hiện bất thường bằng cách cô lập
Ý tưởng phát hiện bất thường của Liu, Ting và Zhou (ICDM 2008) ngược với đa số phương pháp: thay vì mô hình hoá vùng bình thường, hãy xem cần bao nhiêu bước để cô lập từng điểm. Mỗi cây chọn ngẫu nhiên một đặc trưng, rồi một ngưỡng chia ngẫu nhiên giữa giá trị nhỏ nhất và lớn nhất, và lặp lại tới khi điểm đứng riêng một nút. Theo tài liệu scikit-learn, số lần chia đó chính là độ dài đường đi từ gốc, được lấy trung bình trên cả rừng, và phép chia ngẫu nhiên cho đường đi ngắn hơn rõ rệt với điểm bất thường. Mỗi cây xây từ một mẫu con (mặc định min(256, n_samples)) nên chi phí thấp.
iso = IsolationForest(n_estimators=200, contamination="auto",
                      random_state=0, n_jobs=-1).fit(X_tr)
score = -iso.score_samples(X_te)     # càng cao càng bất thường
Lưu ý quy ước dấu: score_samples trả về điểm thấp hơn là bất thường hơn, nên ta đổi dấu để dùng chung với ROC AUC và AP.
[Isolation Forest]
  thời gian fit+score: 1.67 giây | offset_ = -0.50
  Isolation Forest (thô)       ROC AUC=0.994 | AP=0.590 | precision@89=0.528
  predict: gắn nhãn -1 cho 2781 / 18090 mẫu | bắt được 89 / 89 bất thường
  contamination=0.005: báo 84, đúng 47 => precision=0.560 recall=0.528
Hai điều rút ra về phát hiện bất thường bằng Isolation Forest. Xếp hạng rất tốt: ROC AUC 0,994, AP 0,590 so với mức ngẫu nhiên 0,0049, và chỉ mất 1,67 giây. Nhưng với contamination="auto", ngưỡng cố định offset_ = -0.5 lấy từ bài báo gốc gắn nhãn -1 cho 2.781 trên 18.090 mẫu (15,4%): bắt đủ 89/89 bất thường nhưng kèm gần 2.700 cảnh báo giả. Đặt contamination=0.005 theo tỉ lệ ước tính thì báo 84, đúng 47: precision 0,560, recall 0,528. Ngưỡng là quyết định nghiệp vụ, không phải mặc định của thư viện.
Số cây và tiền xử lý trong phát hiện bất thường
  AP theo số cây: 10:0.351  50:0.429  200:0.590  500:0.594
  Isolation Forest (log amount, km) ROC AUC=0.980 | AP=0.496 | precision@89=0.472
Ít cây thì điểm số nhiễu: 10 cây cho AP 0,351, 200 cây cho 0,590, 500 cây gần như không hơn. Phép log lên số tiền và khoảng cách, vốn là thói quen tốt với dữ liệu lệch phải, lại làm giảm AP từ 0,590 xuống 0,496. Giải thích hợp lý: Isolation Forest lấy ngưỡng chia ngẫu nhiên đều giữa giá trị nhỏ nhất và lớn nhất của đặc trưng (Liu và cộng sự, 2008), nên khác cây có giám sát, nó không bất biến với phép biến đổi đơn điệu như log. Log kéo các điểm cực đoan lại gần vùng dữ liệu chính, các lần chia ngẫu nhiên khó cô lập chúng sớm hơn, nên điểm bất thường kém nổi bật. Ta chưa tách riêng tác động của từng cột, nên đây là giải thích chứ không phải kết luận đã kiểm chứng.
LOF: so sánh mật độ cục bộ khi phát hiện bất thường
LOF so mật độ cục bộ của từng điểm với mật độ của k láng giềng gần nhất; điểm có mật độ thấp hơn hẳn láng giềng bị coi là bất thường. Tài liệu scikit-learn nêu n_neighbors=20 thường hoạt động tốt, và cần tăng khi tỉ lệ ngoại lai vượt khoảng 10%. Để chấm điểm trên tập mới, phải đặt novelty=True. Ta chạy trên dữ liệu đã log và chuẩn hoá:
[LOF novelty=True, k=20] thời gian: 3.90 giây
  LOF (chuẩn hoá)              ROC AUC=0.466 | AP=0.020 | precision@89=0.034
ROC AUC 0,466 nghĩa là LOF tệ hơn đoán ngẫu nhiên. Nguyên nhân hợp lý nhất nằm ở dữ liệu huấn luyện: 211 giao dịch bất thường trong tập train chia cho bốn loại, mỗi loại khoảng 50 điểm, tạo thành các cụm nhỏ. Khi một cụm lớn hơn k = 20, các điểm trong cụm có láng giềng gần nhau, mật độ cục bộ cao và LOF coi chúng là bình thường, hiện tượng gọi là masking. Thí nghiệm dưới đây kiểm chứng giả thuyết này. Ta đổi k và đổi dữ liệu huấn luyện:
[LOF: ảnh hưởng của n_neighbors và của việc train có lẫn bất thường]
  k= 20 | train lẫn bất thường       ROC AUC=0.466 AP=0.020
  k= 20 | train chỉ gồm bình thường  ROC AUC=1.000 AP=0.997
  k=100 | train lẫn bất thường       ROC AUC=1.000 AP=0.941
  k=100 | train chỉ gồm bình thường  ROC AUC=1.000 AP=0.997
Kết quả đảo ngược hoàn toàn: với k = 100 hoặc train sạch, LOF đạt AUC 1,000 và AP tới 0,997, vượt xa Isolation Forest trên tập này. Bài học: n_neighbors phải lớn hơn cụm bất thường nhỏ nhất bạn muốn bắt, và nếu có thể, hãy lọc các ca bất thường đã biết khỏi tập huấn luyện. Lưu ý dữ liệu giả lập có các cụm bất thường rất tách biệt; trên dữ liệu thật, ranh giới mờ hơn nhiều.
Autoencoder: phát hiện bất thường qua lỗi tái tạo
Autoencoder là mạng nén dữ liệu qua một lớp thắt rồi giải nén lại; ý tưởng giảm chiều bằng mạng nơ-ron được Hinton và Salakhutdinov mô tả trong Science năm 2006. Huấn luyện chủ yếu trên dữ liệu bình thường làm mạng học cách tái tạo cái phổ biến; giao dịch lạ không nằm trong mẫu đã học nên sai số tái tạo lớn. Điểm phát hiện bất thường chính là sai số bình phương trung bình giữa đầu vào và đầu ra. Mạng 5-8-2-8-5 như sau, huấn luyện 60 epoch với Adam trên dữ liệu đã log và chuẩn hoá (không dùng nhãn):
class AE(nn.Module):
    def __init__(self, d=5, h=8, z=2):
        super().__init__()
        self.enc = nn.Sequential(nn.Linear(d, h), nn.ReLU(), nn.Linear(h, z))
        self.dec = nn.Sequential(nn.Linear(z, h), nn.ReLU(), nn.Linear(h, d))
    def forward(self, x):
        return self.dec(self.enc(x))

def ae_score(model, Z):
    with torch.no_grad():
        t = torch.tensor(Z, dtype=torch.float32)
        return ((model(t) - t) ** 2).mean(dim=1).numpy()
[Autoencoder 5-8-2-8-5, huấn luyện trên train không nhãn]
    epoch   1 | loss huấn luyện = 0.8148
    epoch  10 | loss huấn luyện = 0.4805
    epoch  30 | loss huấn luyện = 0.4009
    epoch  60 | loss huấn luyện = 0.3822
  thời gian huấn luyện: 7.5 giây (CPU)
  Autoencoder (lỗi tái tạo)    ROC AUC=0.948 | AP=0.536 | precision@89=0.494

  Lỗi tái tạo trung vị: bình thường = 0.243 | bất thường = 2.579
  Ngưỡng = phân vị 99,5 lỗi trên train (2.449): báo 109, đúng 46 => precision=0.422 recall=0.517
Với phát hiện bất thường, sai số tái tạo trung vị của giao dịch bất thường (2,579) gấp khoảng 11 lần giao dịch bình thường (0,243): tín hiệu rõ. Ngưỡng đặt ở phân vị 99,5 của lỗi trên tập huấn luyện cho 109 cảnh báo, đúng 46 (precision 0,422, recall 0,517). So với Isolation Forest ở contamination=0.005 (84 cảnh báo, đúng 47, recall 0,528), autoencoder bắt gần bằng nhưng báo thừa nhiều hơn.
Kích thước lớp thắt và độ ổn định
Lớp thắt quyết định mạng "quên" được bao nhiêu. Thử z = 1, 2, 4 trên cùng cấu hình:
  Ảnh hưởng của kích thước lớp thắt (z):
   z=1: ROC AUC=0.953 AP=0.668
   z=2: ROC AUC=0.948 AP=0.536
   z=4: ROC AUC=0.761 AP=0.019

[Độ biến thiên qua 5 hạt giống] AP trung bình ± độ lệch chuẩn
  Isolation Forest (thô)  : 0.604 ± 0.029  (các giá trị: [0.59  0.645 0.622 0.56  0.602])
  Isolation Forest (log)  : 0.499 ± 0.032
  Autoencoder z=1 (log)   : 0.565 ± 0.198  (các giá trị: [0.668 0.625 0.19  0.77  0.574])
Với z = 4, lớp thắt rộng gần bằng đầu vào (5 chiều) nên mạng gần như học phép đồng nhất và tái tạo tốt cả bất thường: AP rơi xuống 0,019, chỉ hơn mức ngẫu nhiên 0,0049 một chút. Lớp thắt phải đủ hẹp để buộc mạng nén. Nhưng mặt trái là độ ổn định: qua 5 hạt giống, autoencoder z = 1 có AP từ 0,190 đến 0,770 (độ lệch chuẩn 0,198), trong khi Isolation Forest chỉ dao động ±0,029 ở bản thô (0,604) và ±0,032 ở bản log, cùng đầu vào với autoencoder (0,499).
Mỗi mô hình phát hiện bất thường loại nào
Con số tổng hợp che mất bức tranh quan trọng nhất của phát hiện bất thường. Ta đếm trong top-K điểm cao nhất (K = 89 bất thường thật trong tập test) mỗi loại bắt được bao nhiêu:
[Theo loại bất thường]
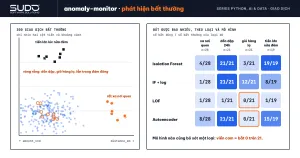
  Isolation Forest (thô)   {'rất xa nơi quen': '4/28', 'dồn dập 24h': '21/21', 'giỏ hàng lạ': '3/21', 'tiền lớn lúc nửa đêm': '19/19'}
  Isolation Forest (log)   {'rất xa nơi quen': '1/28', 'dồn dập 24h': '21/21', 'giỏ hàng lạ': '12/21', 'tiền lớn lúc nửa đêm': '8/19'}
  LOF                      {'rất xa nơi quen': '1/28', 'dồn dập 24h': '1/21', 'giỏ hàng lạ': '0/21', 'tiền lớn lúc nửa đêm': '1/19'}
  Autoencoder              {'rất xa nơi quen': '8/28', 'dồn dập 24h': '21/21', 'giỏ hàng lạ': '0/21', 'tiền lớn lúc nửa đêm': '15/19'}
Với train lẫn bất thường, mô hình nào cũng bỏ sót một loại. Isolation Forest bản thô bắt trọn giao dịch dồn dập và tiền lớn nửa đêm nhưng chỉ 3/21 giỏ hàng lạ; autoencoder bắt 0/21 giỏ hàng lạ (nguyên nhân xem bên dưới); bản log của Isolation Forest thì ngược lại, bắt 12/21 giỏ hàng lạ nhưng mất tiền lớn. Lớp "rất xa nơi quen" cũng không mô hình nào bắt tốt (tốt nhất là 8/28), dù chỉ cần nhìn một cột khoảng cách. Vì vậy kết hợp bằng trung bình hạng giữa Isolation Forest (log) và autoencoder cho ROC AUC 0,973 nhưng AP 0,488, không vượt mô hình đơn tốt nhất: trộn mô hình chỉ có lợi khi chúng sai ở những chỗ khác nhau và không kéo nhau xuống.
Autoencoder khi train chỉ gồm giao dịch bình thường
Autoencoder bỏ sót hoàn toàn giỏ hàng lạ có thể do chính tập huấn luyện lẫn bất thường: 211 ca kéo lệch cả StandardScaler lẫn hàm mất mát. Độ lệch chuẩn của items là 1,751 khi lẫn bất thường, 1,411 khi sạch. Ta chạy lại với scaler và mạng chỉ thấy dữ liệu bình thường:
[Autoencoder z=2: scaler và huấn luyện chỉ trên train bình thường]
  Autoencoder (train sạch)     ROC AUC=1.000 | AP=0.945 | precision@89=0.876
  Autoencoder (train sạch) {'rất xa nơi quen': '28/28', 'dồn dập 24h': '21/21', 'giỏ hàng lạ': '21/21', 'tiền lớn lúc nửa đêm': '8/19'}
AP tăng từ 0,536 lên 0,945 và giỏ hàng lạ được bắt 21/21, nhưng nhóm tiền lớn nửa đêm giảm còn 8/19. Điều này ủng hộ giả thuyết nhiễm bẩn, nhưng ta chưa tách riêng ảnh hưởng của scaler và của mạng.
So sánh ba cách phát hiện bất thường
| Tiêu chí | Isolation Forest | LOF | Autoencoder |
|---|---|---|---|
| Thời gian trong bài | 1,67 giây | 3,90 giây | 7,5 giây (CPU) |
| Cần chuẩn hoá/log | Không bắt buộc; log đổi kết quả (AP 0,590 xuống 0,496), vì ngưỡng chia ngẫu nhiên phụ thuộc thang đo | Có, dựa vào khoảng cách | Có, dựa vào gradient |
| Tham số nhạy | Số cây, contamination | n_neighbors lớn hơn cụm bất thường | Kích thước lớp thắt, hạt giống |
| Độ ổn định | Cao (±0,029 AP bản thô, ±0,032 bản log) | Phụ thuộc dữ liệu train sạch | Thấp (AP 0,190–0,770) |
| Giải thích kết quả | Khó, nhưng có thể dùng SHAP | Khó | Xem lỗi từng đặc trưng |
Lời khuyên cho phát hiện bất thường: bắt đầu với Isolation Forest vì nhanh, ổn định, ít tham số; coi LOF là đối chứng; dùng autoencoder khi dữ liệu nhiều chiều, có cấu trúc (chuỗi, ảnh, log). Hãy xem lỗi tái tạo từng đặc trưng để giải thích vì sao giao dịch bị gắn cờ, tương tự bài Giải thích mô hình với SHAP: biết vì sao mô hình quyết định.
Khi nào không nên dùng phát hiện bất thường không giám sát
- Đã có nhãn gian lận đủ nhiều: mô hình có giám sát như gradient boosting (xem Gradient boosting với XGBoost và LightGBM) thường vượt trội, và có thể dùng điểm bất thường làm một đặc trưng đầu vào.
- Phát hiện bất thường nhầm ca "hợp lệ": khách mua sỉ hoặc ngày khuyến mãi cũng khác thường nhưng không gian lận; cần phản hồi từ nghiệp vụ.
- Phân bố trôi theo thời gian: cần huấn luyện lại định kỳ và theo dõi tỉ lệ cảnh báo.
Lỗi thường gặp khi phát hiện bất thường
- Tin vào
contamination="auto": trong bài, nó gắn cờ 15,4% mẫu. Hãy chọn ngưỡng theo năng lực xử lý cảnh báo của đội vận hành. - Quên đổi dấu
score_samples: điểm thấp là bất thường, đưa thẳng vàoroc_auc_scorecho kết quả ngược. - Để LOF dùng k nhỏ khi train lẫn cụm bất thường: ROC AUC 0,466 so với 1,000 ở k = 100.
- Chấm phát hiện bất thường bằng accuracy: với tỉ lệ 0,5%, luôn đoán "bình thường" đã đúng 99,5%.
- Kết luận từ một hạt giống khi phát hiện bất thường bằng autoencoder: AP dao động từ 0,190 đến 0,770.
- Lớp thắt quá rộng: mạng học phép đồng nhất, AP 0,019 ở z = 4.
Checklist
- Với phát hiện bất thường, xác định rõ outlier detection (train lẫn nhiễu) hay novelty detection (train sạch).
- Báo cáo ROC AUC, AP, precision@K và so với mức ngẫu nhiên; không dùng accuracy.
- Isolation Forest phát hiện bất thường: đủ cây (200 trở lên), thử cả bản thô và bản log, đặt
contaminationtheo tỉ lệ ước tính. - LOF phát hiện bất thường:
novelty=Trueđể chấm tập mới, k lớn hơn cụm bất thường nhỏ nhất. - Autoencoder phát hiện bất thường: lớp thắt hẹp, nhiều hạt giống, chuẩn hoá đầu vào, xem lỗi theo từng đặc trưng.
- Kiểm tra phát hiện bất thường theo từng loại, và có vòng phản hồi từ nghiệp vụ để chọn ngưỡng.
Mã nguồn đầy đủ trong code/s7-17 (anomaly_demo.py, output.txt, requirements.txt), chạy bằng python anomaly_demo.py. Mọi số liệu là output thật từ máy Apple Silicon 16 GB, CPU, hạt giống cố định. Các loại bất thường do ta tự sinh, nên đây không phải bảng xếp hạng thuật toán. Tài liệu gốc: Isolation Forest (Liu, Ting, Zhou, ICDM 2008), Anomaly detection: a survey (Chandola và cộng sự, 2009) và Reducing the dimensionality of data with neural networks (Hinton, Salakhutdinov, 2006).
Bài tiếp theo
Dự báo chuỗi thời gian doanh số: baseline, ARIMA và gradient boosting. Khi dữ liệu có thứ tự theo thời gian, mọi giả định độc lập của bài này không còn đúng: bài sau xây baseline, ARIMA và gradient boosting với cách kiểm định theo thời gian.