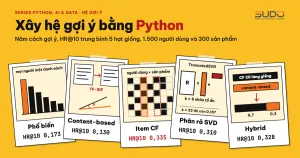
Trên một website bán hàng, mỗi sản phẩm hiển thị thêm "có thể bạn cũng thích" là một cơ hội tăng giá trị đơn hàng, nhưng chỉ khi gợi ý đủ sát. Một hệ gợi ý (recommender system) trả lời câu hỏi: với người dùng này, trong hàng nghìn sản phẩm, nên đưa ra 10 sản phẩm nào. Bài này xây hệ gợi ý từ đầu bằng Python: baseline phổ biến nhất, content-based với TF-IDF, item-based collaborative filtering, phân rã ma trận (TruncatedSVD và ALS tự cài đặt), rồi hybrid. Mọi số liệu là output thật trên dữ liệu giả lập 1.500 người dùng và 300 sản phẩm, đánh giá bằng leave-one-out.
Bài này nối tiếp Dự báo chuỗi thời gian doanh số: baseline, ARIMA và gradient boosting, nơi ta đã học nguyên tắc luôn so với baseline và không xáo trộn thứ tự thời gian. Phần nền về vector xem ở NumPy cho machine learning: vector hoá và broadcasting, cách chọn chỉ số ở Đánh giá mô hình phân loại: precision, recall, ROC và dữ liệu lệch. Môi trường: máy 16 GB RAM, chỉ chạy CPU, Python 3.10, NumPy 1.25.1, pandas 2.0.3, scikit-learn 1.3.0. Dữ liệu hoàn toàn giả lập, không phải dữ liệu khách hàng thật.
Hai họ hệ gợi ý: content-based và collaborative filtering
Mỗi hệ gợi ý thuộc một trong hai họ. Koren, Bell và Volinsky, trong bài Matrix Factorization Techniques for Recommender Systems (IEEE Computer, 2009), chia chiến lược xây hệ gợi ý thành hai nhóm lớn. Content filtering tạo hồ sơ cho từng sản phẩm hoặc người dùng (thể loại, thuộc tính, nhân khẩu học) rồi ghép người dùng với sản phẩm khớp hồ sơ; điểm yếu là phải thu thập thông tin ngoài, không phải lúc nào cũng có. Collaborative filtering (CF) chỉ dựa vào hành vi quá khứ như đơn hàng, lượt xem, đánh giá, không cần biết sản phẩm là gì.
| Họ | Cần dữ liệu gì | Điểm mạnh | Điểm yếu |
|---|---|---|---|
| Phổ biến nhất | Đếm lượt mua | Rất đơn giản, baseline bắt buộc | Mọi người nhận cùng một danh sách |
| Content-based | Mô tả, thuộc tính sản phẩm | Xử lý được sản phẩm mới (cold-start) | Gợi ý "na ná" cái đã xem, ít bất ngờ |
| Item-based CF | Ma trận người dùng x sản phẩm | Dễ giải thích, tính trước offline | Không gợi ý được sản phẩm chưa có tương tác |
| Phân rã ma trận | Như CF | Học nhân tố ẩn, gọn, hợp dữ liệu thưa | Cần chỉnh hạng, regularization |
Dữ liệu và cách đánh giá hệ gợi ý
Ta sinh 300 sản phẩm thuộc 6 danh mục (ốp lưng, tai nghe, sạc, chuột phím, gia dụng, sách) và 1.500 người dùng, mỗi người thích một hoặc hai danh mục, mua 8 đến 24 sản phẩm, với thiên lệch phổ biến theo phân phối Pareto. Đây là phản hồi ngầm (implicit feedback): chỉ biết người dùng đã mua hay chưa, không có điểm sao.
numpy 1.25.1 | pandas 2.0.3 | scikit-learn 1.3.0

[Danh mục] 300 sản phẩm, 6 danh mục
 item_id category                                                         text
       0  ốp lưng ốp lưng điện thoại silicon chính hãng nhỏ gọn tiết kiệm điện
       1 tai nghe       tai nghe bluetooth không dây chính hãng cao cấp giá rẻ
       2      sạc   sạc dự phòng 10000mAh tiết kiệm điện chính hãng thời trang

[Tương tác] 23655 dòng | người dùng: 1500 | sản phẩm có tương tác: 300
độ thưa của ma trận: 5.26% ô có giá trị
train: 22155 tương tác | test: 1500 người dùng (mỗi người 1 sản phẩm bị giấu)
Ma trận chỉ 5,26% ô có giá trị; hệ thống thật thường thưa hơn nhiều. Cách đánh giá hệ gợi ý là leave-one-out theo thời gian: tương tác cuối cùng của mỗi người bị giấu, mô hình chỉ thấy phần còn lại, rồi ta hỏi sản phẩm bị giấu có nằm trong 10 gợi ý đầu không. Chỉ số đầu tiên là Hit Rate@10 (HR@10), tỉ lệ người dùng có sản phẩm bị giấu nằm trong top 10. Chỉ số thứ hai là NDCG@10, thưởng nhiều hơn khi sản phẩm đúng nằm ở vị trí cao, với trọng số 1/log2(vị trí + 1). Sản phẩm đã mua luôn bị loại khỏi danh sách trước khi xếp hạng; hàm evaluate trong mã nguồn làm việc đó.
Đánh giá offline chỉ là xấp xỉ thô; chỉ A/B test trên người dùng thật mới cho biết hệ gợi ý có tăng doanh thu hay không.
Baseline cho hệ gợi ý: sản phẩm phổ biến nhất
Baseline đơn giản nhất là đếm số lần mỗi sản phẩm được mua và đưa cùng danh sách top cho mọi người. Nó đóng vai trò như DummyClassifier ở bài đánh giá mô hình: mọi hệ gợi ý nghiêm túc phải thắng nó.
[Đánh giá leave-one-out, k=10, 1500 người dùng, 300 sản phẩm]
  Phổ biến nhất (baseline)           HR@10 = 0.157   NDCG@10 = 0.088
Chỉ 15,7% người dùng có sản phẩm bị giấu nằm trong top 10 phổ biến, nhờ thiên lệch Pareto. Đây là mốc để so sánh mọi hệ gợi ý ở các phần sau.
Hệ gợi ý content-based: TF-IDF và độ giống cosine
Với hệ gợi ý content-based, ta biến mô tả sản phẩm thành vector TF-IDF (có cả bigram) rồi đo độ giống giữa các sản phẩm bằng cosine. Theo tài liệu Pairwise metrics của scikit-learn, cosine similarity là tích vô hướng của hai vector đã chuẩn hoá L2, nên bằng cosin của góc giữa chúng, và là lựa chọn phổ biến để so sánh tài liệu dạng TF-IDF. Cũng theo tài liệu, khi vector TF-IDF đã chuẩn hoá L2 thì linear_kernel cho kết quả giống nhưng nhanh hơn vì không chuẩn hoá lại.
tfidf = TfidfVectorizer(ngram_range=(1, 2), sublinear_tf=True)
X = tfidf.fit_transform(items.text)
sim_content = cosine_similarity(X)
np.fill_diagonal(sim_content, 0)
TF-IDF: (300, 361) (sản phẩm x từ/cụm từ)
3 sản phẩm giống sản phẩm 0 ('ốp lưng điện thoại silicon chính hãng nhỏ gọn tiết kiệm điện'):
0.699 ốp lưng điện thoại silicon chính hãng bảo hành 12 tháng bền bỉ
0.698 ốp lưng điện thoại silicon chính hãng giá rẻ bảo hành 12 tháng
0.643 ốp lưng điện thoại silicon nhỏ gọn cao cấp chính hãngBa láng giềng gần nhất đều là ốp lưng silicon, đúng kỳ vọng. Để gợi ý cho một người dùng, ta cộng độ giống của các sản phẩm họ đã mua: điểm sản phẩm j bằng tổng sim(j, i) trên mọi sản phẩm i đã mua. Với ma trận thưa R, đó là phép nhân R[u] @ sim_content.
Content-based (hồ sơ = tổng) HR@10 = 0.131 NDCG@10 = 0.059Kết quả thấp hơn cả baseline phổ biến (0,131 so với 0,157). Lý do: mô tả chứa nhiều tính từ chung ("chính hãng", "giá rẻ") làm các danh mục khác nhau vẫn có độ giống dương, và content-based không biết sản phẩm nào bán chạy. Giá trị của nó nằm ở phần cold-start.
Hệ gợi ý item-based collaborative filtering
Ý tưởng của item-based CF là coi mỗi sản phẩm như một vector theo cột của ma trận người dùng x sản phẩm: hai sản phẩm giống nhau nếu cùng những người mua chúng. Linden, Smith và York mô tả cách Amazon dùng ý tưởng này trong bài Amazon.com Recommendations: Item-to-Item Collaborative Filtering (IEEE Internet Computing, 2003). Theo bài, thuật toán tính bảng sản phẩm tương tự bằng cosine ở bước offline, nên phần tính toán lúc phục vụ chỉ còn tra bảng và co giãn tốt với hàng chục triệu khách hàng, trong khi các phương pháp CF theo người dùng không chịu nổi quy mô đó.
sim_item = cosine_similarity(R.T.tocsr())      # 300 x 300
np.fill_diagonal(sim_item, 0)

def knn_prune(S, k):                            # giữ k láng giềng mạnh nhất mỗi hàng
    S = S.copy()
    idx = np.argsort(-S, axis=1)[:, k:]
    np.put_along_axis(S, idx, 0, axis=1)
    return S

score = R[u] @ knn_prune(sim_item, 20)          # điểm cho người dùng u
Ma trận độ giống item-item: (300, 300) tính trong 0.002s
Item-based CF, 5 láng giềng HR@10 = 0.279 NDCG@10 = 0.161
Item-based CF, 20 láng giềng HR@10 = 0.335 NDCG@10 = 0.183
Item-based CF, 50 láng giềng HR@10 = 0.338 NDCG@10 = 0.179
Item-based CF, mọi láng giềng HR@10 = 0.339 NDCG@10 = 0.184Hệ gợi ý item-based CF gấp đôi baseline: 0,335 so với 0,157. Số láng giềng quan trọng ở khoảng thấp (5 láng giềng thiếu thông tin), rồi bão hoà từ khoảng 20. Catalog hàng triệu sản phẩm buộc phải cắt về top-k mỗi hàng để bảng độ giống vừa bộ nhớ. Khi có điểm sao, biến thể adjusted cosine trừ trung bình theo người dùng trước khi tính độ giống.
Hệ gợi ý phân rã ma trận: TruncatedSVD và ALS
Thay vì tính độ giống giữa từng cặp sản phẩm, hệ gợi ý phân rã ma trận học một vector nhân tố ẩn cho mỗi người dùng và mỗi sản phẩm sao cho tích vô hướng xấp xỉ mức độ quan tâm. Koren và cộng sự viết bài toán như tối thiểu hoá sai số bình phương có regularization trên các điểm đã biết, và nêu hai cách giải chính: stochastic gradient descent và alternating least squares (ALS). ALS cố định một bên, giải bên kia bằng bình phương tối thiểu, và theo bài, rất hợp với dữ liệu phản hồi ngầm vì tập huấn luyện không thể coi là thưa, nên lặp qua từng mẫu như gradient descent là không thực tế.
Cách nhanh nhất để thử ý tưởng này là TruncatedSVD. Theo tài liệu TruncatedSVD, khác với PCA, nó không căn giữa dữ liệu nên chạy hiệu quả trên ma trận thưa. Ta chiếu mỗi người dùng xuống không gian f chiều, rồi chiếu ngược để có điểm cho mọi sản phẩm.
svd = TruncatedSVD(n_components=8, random_state=0).fit(R)
P = svd.transform(R)                  # người dùng trong không gian nhân tố
score = P[u] @ svd.components_        # điểm xấp xỉ cho mọi sản phẩm
TruncatedSVD, 8 nhân tố HR@10 = 0.315 NDCG@10 = 0.172
TruncatedSVD, 16 nhân tố HR@10 = 0.275 NDCG@10 = 0.145
TruncatedSVD, 32 nhân tố HR@10 = 0.185 NDCG@10 = 0.094Điều đáng chú ý là càng nhiều nhân tố, kết quả càng tệ: 8 nhân tố cho 0,315, còn 32 nhân tố chỉ 0,185. Dữ liệu giả lập có đúng 6 danh mục nên 8 nhân tố là đủ nắm cấu trúc; nhiều nhân tố hơn dễ bám vào chi tiết riêng của từng người thay vì khái quát (đây là cách giải thích hợp lý, bài không kiểm chứng riêng). Số nhân tố là siêu tham số phải chọn bằng tập validation.
SVD cắt cụt coi ô trống là số 0 có trọng số như mọi ô khác. ALS cho phản hồi ngầm (Hu, Koren, Volinsky, 2008, được trích trong bài của Koren) xử lý khéo hơn: mỗi ô có một preference (1 nếu có tương tác) và một confidence c = 1 + alpha x r, nên ô có tương tác được tin hơn ô trống. Ta tự cài đặt phương pháp này.
Mã đầy đủ của hàm als_implicit nằm trong recsys_demo.py. Mẹo là tách YtY dùng chung, chỉ cộng phần hiệu chỉnh trên ô có tương tác, nên chi phí tỉ lệ với số tương tác. Mỗi vòng lặp giải riêng từng người dùng rồi từng sản phẩm bằng một hệ phương trình tuyến tính nhỏ np.linalg.solve(A, b) với A = YtY + Yi.T @ diag(c-1) @ Yi + reg*I.
ALS tự cài đặt: huấn luyện 2.68s
  ALS ngầm, 16 nhân tố               HR@10 = 0.267   NDCG@10 = 0.135
ALS 16 nhân tố đạt 0,267, không vượt item-based CF trên bộ dữ liệu nhỏ này, và chưa được tinh chỉnh (reg, alpha, số nhân tố giữ cố định). Koren và cộng sự báo cáo trên Netflix Prize (hơn 100 triệu đánh giá) rằng mô hình nhân tố vượt các kỹ thuật láng giềng, nhưng quy mô đó khác xa 22 nghìn tương tác ở đây.
Hệ gợi ý hybrid và bài toán cold-start
Khi một sản phẩm mới lên kệ, nó chưa có tương tác nào nên cột tương ứng trong ma trận toàn số 0. Đây là vấn đề cold-start. Ta mô phỏng: xoá toàn bộ tương tác của 30 sản phẩm cuối, rồi xem mô hình có đưa chúng vào top 10 của những người dùng thật sự sẽ mua chúng (177 người) không.
[Cold-start] 30 sản phẩm cuối bị xoá hết tương tác; người dùng có sản phẩm kiểm tra thuộc nhóm này: 177
  Item-based CF                      HR@10 (chỉ sp mới) = 0.000
  Content-based                      HR@10 (chỉ sp mới) = 0.096
Hệ gợi ý item-based CF cho đúng 0: nó không có cách nào biết sản phẩm mới giống ai. Content-based đạt 0,096, thấp nhưng khác không vì nó dựa vào mô tả. Đây là lý do thực tế để xây hệ gợi ý hybrid kết hợp hai họ: dùng CF khi sản phẩm đã có lịch sử, content-based cho sản phẩm mới. Cách đơn giản là trộn điểm sau khi chuẩn hoá z-score theo từng người dùng.
def zscore_rows(M):
    M = np.asarray(M, dtype=float)
    return (M - M.mean(axis=1, keepdims=True)) / (M.std(axis=1, keepdims=True) + 1e-9)

score = (1 - w) * zscore_rows(R[u] @ sk20) + w * zscore_rows(R[u] @ sim_content)
Hybrid CF20 + content, w=0.0 HR@10 = 0.335 NDCG@10 = 0.183
Hybrid CF20 + content, w=0.3 HR@10 = 0.323 NDCG@10 = 0.179
Hybrid CF20 + content, w=0.5 HR@10 = 0.309 NDCG@10 = 0.169Trên sản phẩm đã có lịch sử, thêm content làm giảm nhẹ chất lượng. Trọng số phải theo ngữ cảnh: w gần 0 cho sản phẩm nhiều tương tác (đã đo ở trên), còn tăng w cho sản phẩm mới là nhận định từ kết quả cold-start, bài chưa đo vì hybrid dùng một w chung.
Độ tin cậy khi so sánh hệ gợi ý: chạy nhiều hạt giống
Một lần chạy chưa đủ để kết luận. Ta chạy lại toàn bộ quy trình, sinh lại dữ liệu, với 5 hạt giống (SEED=42,1,2,3,4) và lấy trung bình cùng độ lệch chuẩn của HR@10.
| Mô hình | HR@10 trung bình | Độ lệch chuẩn |
|---|---|---|
| Phổ biến nhất | 0,173 | 0,018 |
| Content-based | 0,130 | 0,008 |
| Item-based CF, 5 láng giềng | 0,268 | 0,016 |
| Item-based CF, 20 láng giềng | 0,335 | 0,015 |
| TruncatedSVD, 8 nhân tố | 0,310 | 0,015 |
| TruncatedSVD, 32 nhân tố | 0,187 | 0,010 |
| ALS ngầm, 16 nhân tố | 0,263 | 0,016 |
| Hybrid CF20 + content, w=0,3 | 0,328 | 0,020 |
| Cold-start: content-based (sản phẩm mới) | 0,105 | 0,028 |
| Cold-start: item-based CF (sản phẩm mới) | 0,000 | 0,000 |
Thứ hạng của hệ gợi ý ổn định qua các hạt giống: item-based CF 20 láng giềng dẫn đầu (0,335), SVD 8 nhân tố sát sau (0,310), cách xa baseline. Khoảng cách giữa hệ gợi ý CF và hybrid (0,335 so với 0,328) nằm trong một độ lệch chuẩn, nên không phải khác biệt thật. Cold-start dao động mạnh (độ lệch chuẩn 0,028) vì số người dùng liên quan ít.
Khi nào không nên dùng hệ gợi ý và lỗi thường gặp
- Rò rỉ thời gian: chia ngẫu nhiên thay vì giấu tương tác cuối cùng khiến mô hình "nhìn thấy tương lai". Đây cũng là lỗi đã nêu ở bài dự báo chuỗi thời gian.
- Quên loại sản phẩm đã mua: gợi ý lại đúng thứ khách vừa mua làm trải nghiệm tệ (trừ hàng mua lặp, nên coi là bài toán riêng).
- Thiên lệch phổ biến: hệ gợi ý CF đẩy sản phẩm bán chạy lên, sản phẩm đuôi dài không bao giờ được thấy. Cần đo thêm độ phủ catalog (coverage) và độ đa dạng, không chỉ HR.
- Không đủ dữ liệu: dưới vài nghìn tương tác, quy tắc nghiệp vụ ("mua ốp lưng thì gợi ý cường lực") thường đánh bại mô hình học.
- Dữ liệu cá nhân: lịch sử mua hàng là dữ liệu cá nhân; ẩn danh định danh và nêu rõ mục đích trong chính sách quyền riêng tư.
Để thử trên dữ liệu thật, bộ MovieLens của GroupLens là chuẩn học thuật, có bản nhỏ khoảng 100 nghìn đánh giá. Trang này nói họ thường không cho phép phân phối lại và mỗi bộ có README về giấy phép, nên bài dùng dữ liệu giả lập tự sinh.
Đưa hệ gợi ý vào sản phẩm
Với catalog vừa phải, kiến trúc gọn nhất là tính offline hằng đêm bảng top-k láng giềng cho mỗi sản phẩm, lưu vào Redis hoặc bảng DB; website chỉ tra khoá theo sản phẩm đang xem. Khi sản phẩm mới xuất hiện, dùng content-based làm đường dự phòng cho đến khi có đủ tương tác.
Checklist hệ gợi ý
- Trước khi xây hệ gợi ý, xác định tín hiệu: phản hồi tường minh (điểm sao) hay ngầm (mua, xem).
- Luôn có baseline phổ biến nhất; hệ gợi ý phải thắng nó trên top-k.
- Tách train/test theo thời gian, loại sản phẩm đã mua khỏi danh sách.
- Hệ gợi ý item-based CF với top-k láng giềng là điểm khởi đầu mạnh và dễ giải thích.
- Hệ gợi ý phân rã ma trận cần chọn số nhân tố và regularization bằng validation.
- Dùng hệ gợi ý content-based hoặc hybrid cho sản phẩm mới; trọng số theo lượng lịch sử.
- Báo cáo hệ gợi ý theo trung bình ± độ lệch chuẩn qua nhiều hạt giống; đo thêm coverage và đa dạng.
Mã nguồn đầy đủ trong code/s7-19 (recsys_demo.py, output.txt, seeds_summary.txt, requirements.txt), chạy bằng python recsys_demo.py. Mọi số liệu về hệ gợi ý trong bài là output thật từ máy 16 GB RAM chạy CPU, scikit-learn 1.3.0; dữ liệu giả lập.
Bài tiếp theo
PyTorch cơ bản: tensor, autograd và vòng lặp huấn luyện. Phân rã ma trận ở bài này tự cài bằng NumPy; để xây các mô hình sâu hơn, ta cần một framework có tự động đạo hàm, và đó là nội dung của bài kế tiếp.