Polars là thư viện DataFrame viết bằng Rust, có API Python, thiết kế quanh một ý tưởng: bạn mô tả cả truy vấn trước, thư viện tối ưu kế hoạch, rồi mới đọc dữ liệu. Với bảng đơn hàng vài triệu dòng, cách làm này cho thấy khác biệt rất rõ so với đọc nguyên file vào bộ nhớ rồi xử lý từng bước như thói quen với pandas. Bài này chạy cùng một báo cáo doanh thu trên 5 triệu dòng đơn hàng mô phỏng bằng pandas 3.0 và Polars 1.42, đo thời gian và RAM đỉnh, đọc kế hoạch truy vấn (explain), rồi nói thẳng khi nào nên và không nên chuyển sang Polars.
Bài liên quan đến hai bài trước trong series về xử lý dữ liệu bảng: Làm sạch dữ liệu với pandas và NumPy và vector hoá. Môi trường: Apple M4, 16 GB RAM, Python 3.12, polars==1.42.1, pandas==3.0.3, pyarrow==25.0.0, numpy==2.5.1; mã nguồn ở code/s7-53. Dữ liệu là dữ liệu mô phỏng tự sinh, không phải dữ liệu khách hàng thật. Máy lúc đó còn chạy các tác vụ khác, nên mọi số đo thời gian là trung vị của 5 lần chạy và chỉ có giá trị so sánh tương đối.
Vấn đề: báo cáo chạy được trên laptop, đến lúc dữ liệu gấp mười thì hết RAM
Một kịch bản quen thuộc ở doanh nghiệp bán lẻ: file xuất đơn hàng hằng ngày được cộng dồn thành CSV vài trăm MB, rồi có người viết notebook pandas để ra báo cáo doanh thu theo thành phố và kênh bán. Notebook chạy tốt với dữ liệu một quý. Khi dữ liệu thành một năm, nó chậm hơn nhiều và RAM bắt đầu là vấn đề. Nguyên nhân thường không phải pandas "tệ", mà là mô hình thực thi: mỗi dòng code chạy ngay (eager), đọc tất cả cột, và tạo thêm bản trung gian.
Polars giải quyết bằng ba thứ có thể kiểm chứng: thực thi lazy có bộ tối ưu truy vấn, bộ máy thực thi song song theo biểu thức và (từ các bản gần đây) chạy theo lô (streaming). Theo tài liệu Polars về kiểu dữ liệu, Polars dùng định dạng cột Arrow cho bộ nhớ, nhưng tài liệu cũng nói hiệu năng chủ yếu đến từ bộ máy truy vấn, tối ưu kế hoạch và thực thi biểu thức song song, chứ không chỉ từ cách bố trí bộ nhớ.
Dữ liệu mô phỏng và truy vấn dùng để so sánh
Script gen_data.py sinh bảng đơn hàng gồm 9 cột: order_id, customer_id, order_date, city, channel, sku, qty, unit_price, status. Với 5 triệu dòng, file CSV nặng 280 MB, file Parquet nén chỉ 49,5 MB. Truy vấn đo là một báo cáo điển hình: lấy đơn đã thanh toán từ 01/04/2026, tính doanh thu, nhóm theo thành phố và kênh, lấy 5 nhóm doanh thu cao nhất.
import polars as pl
from datetime import date

def query(lf):
    return (lf.filter((pl.col("status") == "paid") & (pl.col("order_date") >= date(2026, 4, 1)))
              .with_columns(revenue=pl.col("qty") * pl.col("unit_price"))
              .group_by("city", "channel")
              .agg(orders=pl.len(), revenue=pl.col("revenue").sum(), avg_qty=pl.col("qty").mean())
              .sort("revenue", descending=True).head(5))

out = query(pl.scan_csv("orders.csv", try_parse_dates=True)).collect(engine="in-memory")
Phiên bản pandas làm cùng việc theo kiểu quen thuộc: read_csv, lọc bằng mặt nạ boolean, assign, groupby().agg(). Ở mọi cách chạy, hàng đầu tiên của kết quả giống hệt nhau (HCM, web, 275.043 đơn, doanh thu 196.076.218.000 VND), nên so sánh là công bằng về kết quả.
Lazy API: scan, kế hoạch truy vấn và collect
Khác biệt cốt lõi là read_csv và scan_csv. pl.read_csv đọc ngay và trả về DataFrame. pl.scan_csv chỉ trả về LazyFrame, một "lời hứa tính toán"; chưa dòng dữ liệu nào được đọc cho tới khi bạn gọi .collect(). Theo trang Execution của tài liệu Polars, mỗi dòng code được thêm vào đồ thị truy vấn nội bộ và đồ thị này được tối ưu trước khi chạy.
Ta có thể nhìn kế hoạch trước và sau tối ưu bằng explain. Output thật của demo_explain.py:
=== explain(optimized=False) ===
SLICE[offset: 0, len: 3]
  SORT BY [descending: [true]] [col("revenue")]
    AGGREGATE[maintain_order: false]
      [len().alias("orders"), col("revenue").sum()] BY [col("city"), col("channel")]
      FROM
       WITH_COLUMNS:
       [[(col("qty")) * (col("unit_price"))].alias("revenue")]
        FILTER [(col("order_date")) >= (2026-04-01)]
        FROM
          FILTER [(col("status")) == ("paid")]
          FROM
            Csv SCAN [orders.csv]
            PROJECT */9 COLUMNS
            ESTIMATED ROWS: 5609054
=== explain() (đã tối ưu) ===
SORT BY [slice: (0, 3, dynamic_pred: cbf69941-1418-49a9-bc0b-32fe3ee57421), descending: [true]] [col("revenue")]
  FILTER col("revenue").dynamic_predicate()
  FROM
    AGGREGATE[maintain_order: false]
      [len().alias("orders"), col("revenue").sum()] BY [col("city"), col("channel")]
      FROM
      simple π 3/3 ["city", "channel", "revenue"]
         WITH_COLUMNS:
         [[(col("qty")) * (col("unit_price"))].alias("revenue")]
          simple π 4/4 ["city", "channel", "qty", ... 1 other column]
            Csv SCAN [orders.csv]
            PROJECT 6/9 COLUMNS
            SELECTION: [([(col("order_date")) >= (2026-04-01)]) & ([(col("status")) == ("paid")])]
            ESTIMATED ROWS: 5609054
Ba thay đổi hiện rõ trong kế hoạch tối ưu. Thứ nhất, PROJECT 6/9 COLUMNS: chỉ 6 trong 9 cột được đọc từ file (projection pushdown), các cột order_id, customer_id, sku không bao giờ được nạp. Thứ hai, SELECTION ở ngay bước scan: hai bộ lọc được gộp thành một và áp dụng khi đọc (predicate pushdown), nên dòng không thoả điều kiện bị bỏ sớm. Thứ ba, SORT BY [slice: ...] kèm dynamic_predicate: vì chỉ cần top N, Polars gộp head vào bước sắp xếp thay vì sắp xếp toàn bộ rồi cắt. Danh sách đầy đủ các tối ưu hoá (predicate, projection, slice pushdown, loại bỏ truy vấn con trùng lặp, đơn giản hoá biểu thức, sắp thứ tự join, ép kiểu, ước lượng lực lượng) có ở trang Optimizations.
Một lợi ích ít được nhắc: schema được suy ra mà không đọc dữ liệu. lf.collect_schema() trả ngay Schema({'city': String, 'channel': String, 'orders': UInt32, 'revenue': Int64}). Lỗi tên cột sai hoặc kiểu không khớp được phát hiện trước khi tốn thời gian đọc file lớn.
Chọn engine: in-memory và streaming
Theo tài liệu LazyFrame.collect, tham số engine nhận "auto", "in-memory", "streaming" hoặc "gpu". Chế độ "auto" dùng engine đặt qua Config.set_engine_affinity hoặc biến môi trường POLARS_ENGINE_AFFINITY, và với Polars 1.42 (bản dùng trong bài) rơi về "in-memory" nếu không đặt gì; docstring của bản này ghi streaming "sẽ sớm trở thành mặc định".
Tài liệu stable trên trang chủ luôn theo bản Polars mới nhất nên có thể mô tả mặc định khác với bản bạn cài; hãy đối chiếu docstring của bản đang dùng (help(pl.LazyFrame.collect)). Streaming xử lý truy vấn theo từng lô thay vì "một khối" như engine in-memory, nhờ đó giảm áp lực bộ nhớ; nếu engine được chọn không chạy được một truy vấn, Polars tự rơi về in-memory. Chế độ GPU được tài liệu ghi là chưa ổn định (unstable) và cần card Nvidia cùng cudf-polars; máy trong bài không có GPU nên phần đó cần GPU, chưa chạy trong bài.
Trong bài tôi truyền engine tường minh để kết quả không phụ thuộc cấu hình môi trường. Với dữ liệu lớn hơn RAM, tài liệu Execution khuyên dùng engine="streaming", đồng thời nói rõ Polars "có thể" xử lý theo lô chứ không cam kết mọi truy vấn đều chạy được theo kiểu này; vì vậy hãy thử trên truy vấn thật của bạn thay vì giả định.
Kết quả đo: 5 triệu dòng, một máy 16 GB
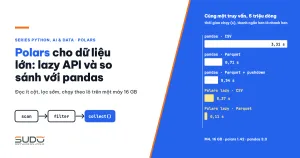
Mỗi cách chạy là một tiến trình Python riêng (bench.py <chế độ>) để RAM đỉnh (ru_maxrss) không bị lẫn. Bảng dưới là trung vị thời gian của 5 lần chạy và RAM đỉnh; thời gian gồm cả đọc file lẫn tính toán.
| Cách chạy | Nguồn | Thời gian (s) | RAM đỉnh (MB) |
|---|---|---|---|
| pandas, đọc toàn bộ | CSV 280 MB | 3,31 | 1.397 |
| pandas, đọc toàn bộ | Parquet 49,5 MB | 0,71 | 1.315 |
pandas, read_parquet(columns=, filters=) | Parquet | 0,54 | 665 |
Polars read_csv rồi tính, tắt tối ưu | CSV | 0,41 | 880 |
Polars lazy, engine="in-memory" | CSV | 0,37 | 628 |
Polars lazy, engine="streaming" | CSV | 0,32 | 550 |
Polars lazy, engine="in-memory" | Parquet | 0,11 | 281 |
Polars lazy, engine="streaming" | Parquet | 0,09 | 205 |
Về độ nhiễu: máy đo là máy dùng chung, load average thường trên 20 với 10 nhân. Ở một lần đo trước, lần chạy đầu của pandas đọc Parquet mất khoảng 7,8 giây, và lúc máy bận hơn nữa có lần pandas mất 38 giây. Tôi đã kiểm tra nghi vấn do chuyển cột order_date từ object sang datetime64: bước to_datetime chỉ mất 0,56 giây nên không phải nguyên nhân; nhiều khả năng là tranh chấp CPU và bộ nhớ, và pandas dùng nhiều RAM hơn nên chịu ảnh hưởng nặng hơn. Bảng dưới đo lại 5 lần liên tiếp lúc load average khoảng 8,7; bench_output.txt giữ từng lần. Hãy xem chúng là thứ tự độ lớn, không phải số tuyệt đối.
Cách đọc kết quả, cẩn thận để không kết luận quá đà:
- Cùng truy vấn, khác biệt về thời gian là lớn: với CSV, pandas mất 3,31 giây, Polars lazy khoảng 0,37 giây, nhanh cỡ 9 lần. Phần lớn chênh lệch đến từ đọc và phân tích CSV đa luồng và từ nhóm theo song song.
- Lazy không phải lúc nào cũng nhanh hơn eager về thời gian: dòng "tắt tối ưu" (0,41 giây) và dòng lazy in-memory (0,37 giây) chênh nhau trong biên nhiễu của máy đang chạy tác vụ khác. Lợi ích rõ của lazy nằm ở RAM đỉnh: 628 MB so với 880 MB, vì 3 cột không dùng không được đọc.
- Định dạng file quan trọng ngang engine: chuyển từ CSV sang Parquet làm RAM đỉnh của Polars giảm từ 628 xuống 281 MB và thời gian giảm khoảng 3 lần, vì Parquet là định dạng cột, đọc được từng cột và có thể bỏ qua cả nhóm dòng dựa vào thống kê.
- pandas cũng đẩy cột và bộ lọc xuống bước đọc: khi gọi
read_parquetvớicolumnsvàfilters(qua PyArrow), pandas giảm từ 1.315 MB xuống 665 MB và thời gian từ 0,71 xuống 0,54 giây. Khoảng cách với Polars thu hẹp, nhưng vẫn còn: 0,54 giây so với 0,11 giây và 665 MB so với 281 MB. - Streaming có ích rõ rệt hơn khi dữ liệu lớn: với 5 triệu dòng, streaming chỉ tiết kiệm thêm khoảng 12 đến 27% RAM (628 xuống 550 MB với CSV, 281 xuống 205 MB với Parquet) so với in-memory. Lợi thế thật là chạy được truy vấn mà bộ nhớ không chứa nổi, điều không thể minh hoạ trên máy dùng chung.
Khi giới hạn số luồng bằng biến môi trường POLARS_MAX_THREADS=2 (mô phỏng một container nhỏ), truy vấn Polars lazy trên CSV mất 0,55 giây và dùng 515 MB; trên Parquet mất 0,13 giây và dùng 237 MB, vẫn nhanh hơn pandas ở cấu hình đủ nhân (đây là một lần chạy, không phải trung vị; hai dòng cuối của bench_output.txt). Điều này đáng nhớ khi chạy trong container có giới hạn CPU.
Biểu thức, cửa sổ và join trong một đồ thị lazy
Sức mạnh thật của Polars là biểu thức (pl.col(...)) kết hợp được với nhau và chạy song song. Ví dụ dưới đây làm ba việc trong một đồ thị: ghép bảng vùng miền, xếp hạng SKU theo doanh thu trong từng vùng bằng hàm cửa sổ .over("region"), và gom doanh thu theo tháng bằng group_by_dynamic. Hai kết quả dùng chung nhánh đọc và lọc, nên gọi pl.collect_all để nhánh chung chỉ tính một lần (đúng khuyến nghị trong tài liệu Execution cho các truy vấn rẽ nhánh).
orders = pl.scan_parquet("orders_sink.parquet")
regions = pl.LazyFrame({"city": ["HCM", "HN", "DN", "CT", "HP", "Khac"],
                        "region": ["Nam", "Bắc", "Trung", "Nam", "Bắc", "Khác"]})
paid = (orders.filter(pl.col("status") == "paid")
        .with_columns(revenue=pl.col("qty") * pl.col("unit_price"))
        .join(regions, on="city", how="left"))

top_sku = (paid.group_by("region", "sku").agg(revenue=pl.col("revenue").sum())
           .with_columns(rank=pl.col("revenue").rank("dense", descending=True).over("region"))
           .filter(pl.col("rank") <= 2).sort("region", "rank"))
monthly = (paid.sort("order_date").group_by_dynamic("order_date", every="1mo", group_by="region")
           .agg(orders=pl.len(), revenue=pl.col("revenue").sum())
           .filter(pl.col("region") == "Nam").sort("order_date"))
a, b = pl.collect_all([top_sku, monthly])
File orders_sink.parquet được tạo từ CSV bằng pl.scan_csv(...).sink_parquet(...), thao tác chuyển đổi chạy theo lô và không nạp cả file CSV vào một DataFrame. Output thật của demo_pipeline.py (rút gọn):
sink_parquet: 0.69 s, RAM đỉnh 545 MB
collect_all: 0.37 s
┌────────┬─────────┬───────────┬──────┐
│ region ┆ sku     ┆ revenue   ┆ rank │
╞════════╪═════════╪═══════════╪══════╡
│ Bắc    ┆ SKU1408 ┆ 530026000 ┆ 1    │
│ Bắc    ┆ SKU1582 ┆ 519179000 ┆ 2    │
│ Nam    ┆ SKU1295 ┆ 680433000 ┆ 1    │
│ Nam    ┆ SKU0619 ┆ 677310000 ┆ 2    │
└────────┴─────────┴───────────┴──────┘
RAM đỉnh 545 MB của sink_parquet cho thấy "streaming" không có nghĩa là "gần như không tốn RAM": đó là mức bộ nhớ thực tế khi xử lý 280 MB CSV có cột chuỗi, và nó vẫn thấp hơn nhiều so với nạp toàn bộ vào pandas. Hãy đo trên dữ liệu của bạn.
Khác biệt ngữ nghĩa với pandas 3.0
Chuyển từ pandas sang Polars không chỉ là đổi cú pháp. Một số khác biệt ngữ nghĩa dễ gây lỗi âm thầm, nên demo_semantics.py kiểm chứng từng điểm trên dữ liệu 4 dòng. Output thật:
pandas dtypes : {'city': 'str', 'amount': 'float64'}
polars schema : {'city': String, 'amount': Float64}
pandas  amount.isna().sum() = 2 | mean = 200.0
polars  null_count = 1 | nan_count = 1 | mean = nan
polars  sau fill_nan(None): null_count = 2 | mean = 200.0
pandas CoW: view[0] vẫn = 100.0 (không bị đổi theo)
chained assignment: df.amount[1] = nan (không ghi được vào df)
- Thiếu dữ liệu:
nullkhácNaN. pandas coi cả hai là "thiếu" (isna()đếm 2,mean()bỏ qua nên ra 200,0). Polars phân biệt:nulllà giá trị thiếu, cònNaNlà một số thực đặc biệt, nên cột có 1 null và 1 NaN chomean = nan. Tài liệu Polars nhấn mạnh không được nhầm hai khái niệm này. Dữ liệu đến từ pandas thường cầnfill_nan(None)trước khi tính trung bình. - pandas 3.0 đã đổi nhiều thứ. Theo What's new in 3.0.0 (ngày 21/01/2026), kiểu chuỗi riêng
strđược bật mặc định (dùng PyArrow nếu đã cài), và Copy-on-Write là hành vi mặc định: kết quả của mọi phép lập chỉ mục luôn "hành xử như một bản sao", nên chained assignment ngừng hoạt động. Output ở trên khớp:pdf["amount"][1] = 5.0không ghi được vàopdf(pandas còn phát cảnh báoChainedAssignmentError), vàview[0]không đổi khi sửapdf. - Không có chỉ mục (index). Polars không có
indexhàng; việc nối, nhóm đều theo cột. Code pandas dựa vào.loc[label]hoặc căn chỉnh theo index phải viết lại bằngjoinhoặcover. - Thứ tự nhóm không cố định.
group_bycủa Polars mặc định không giữ thứ tự xuất hiện (maintain_order: falsetrong kế hoạch ở trên); cần thứ tự thì thêmmaintain_order=Truehoặcsortrõ ràng.
Về pandas, số đo ở bài này dùng pandas 3.0.3 đã có kiểu str mặc định, nên phép so sánh trong bài không bị thiệt cho pandas vì cột chuỗi dạng object như ở các bản cũ.
Khi nào không nên chuyển sang Polars
- Dữ liệu nhỏ. Dưới vài chục MB, hai thư viện đều tính trong chớp mắt; chi phí chuyển đổi (viết lại code, đào tạo nhóm) lớn hơn lợi ích.
- Hệ sinh thái pandas. Nhiều thư viện nhận trực tiếp DataFrame của pandas hoặc mảng NumPy (feature engineering, scikit-learn, nhiều thư viện vẽ biểu đồ). Polars có
to_pandas()vàto_numpy()để nối sang, nhưng mỗi lần chuyển là một lần sao chép bộ nhớ; hãy chuyển ở rìa pipeline chứ không lặp đi lặp lại. - Truy vấn không hợp với lazy. Phân tích khám phá từng ô lệnh trong notebook, nơi bạn muốn xem kết quả trung gian sau mỗi bước, thì eager (
read_csv) của Polars hoặc pandas tiện hơn. Lazy phát huy nhất ở pipeline lặp lại. - Dữ liệu thật sự lớn hơn một máy. Polars giúp một máy xử lý được nhiều hơn, nhưng cần dữ liệu phân tán hàng trăm GB đến TB thì phải cân nhắc Spark, DuckDB hoặc kho dữ liệu; bài này không đo các hệ đó nên không so sánh.
- API còn phát triển nhanh. Polars đã ở phiên bản 1.x, nhưng tham số như
enginecủacollectvà các cờ tối ưu mới xuất hiện qua các bản; ghim phiên bản trongrequirements.txtvà đọc ghi chú phát hành khi nâng cấp.
Lỗi thường gặp
- So sánh ngày với chuỗi. Khi tôi viết bản pandas đọc từ Parquet, cột
order_datecó kiểudatevà phép lọc>= "2026-04-01"báoTypeError: '>=' not supported between instances of 'datetime.date' and 'str'. Phải éppd.to_datetimetrước. Trong Polars, dùngdatetime.date(2026, 4, 1)hoặcpl.date(2026, 4, 1). - Dùng
head()để phát triển rồi tin kết quả. Tài liệu Execution cảnh báo kết quả trên mẫu nhỏ "có thể không đại diện" cho toàn bộ dữ liệu. Kiểm tra kế hoạch bằngexplainvà chạy trên mẫu ngẫu nhiên có kiểm soát. - Gọi
collect()nhiều lần trên cùng mộtLazyFrame. Mỗi lần gọi tính lại từ đầu vìLazyFramekhông bảo đảm lưu đệm kết quả trung gian; dùngpl.collect_allcho các truy vấn chia sẻ nhánh chung. - Biến lazy thành eager quá sớm. Gọi
.to_pandas()hoặc.collect()giữa pipeline làm mất tối ưu pushdown phía trước. Giữ lazy đến bước cuối. - Đếm bằng cách cũ. Dùng
pl.len()để đếm số dòng trongagg; kết quả có kiểuUInt32(xem schema ở trên), cần ép sangInt64nếu so sánh hoặc xuất ra hệ thống đòi kiểu có dấu.
Checklist
- Lưu dữ liệu phân tích dưới dạng Parquet; dùng
scan_parquetvà giữ truy vấn ở dạng lazy đến bước cuối. - Đọc
explain()để xác nhận cột thừa không bị đọc (PROJECT 6/9 COLUMNS) và bộ lọc nằm ở bước scan (SELECTION). - Đặt
enginetường minh khi cần kết quả tái lập; thửengine="streaming"trên truy vấn thật khi dữ liệu gần chạm RAM. - Giới hạn luồng bằng
POLARS_MAX_THREADSkhi chạy trong container có giới hạn CPU. - Phân biệt
nullvàNaN, ghim phiên bản trongrequirements.txt, chuyển sang pandas hoặc NumPy ở rìa pipeline.
Cài đặt: python3.12 -m venv .venv && .venv/bin/pip install -r requirements.txt, chạy python gen_data.py 5000000 để sinh dữ liệu, rồi bench.py <chế độ>, demo_explain.py, demo_semantics.py và demo_pipeline.py trong code/s7-53; các file *_output.txt là output đã dán. Phần bench dùng tối đa khoảng 1,6 GB RAM (chủ yếu là pandas đọc CSV); requirements.txt ghim cả gói gián tiếp (python-dateutil, tzdata) ở bản ra trước ngày đăng bài; file dữ liệu và .venv đã được xoá sau khi lấy số liệu.
Bài tiếp theo
Pipeline dữ liệu end-to-end: crawl giá sản phẩm, phân tích và dashboard Streamlit. Bài kế tiếp ghép các mảnh của series: crawl dữ liệu, làm sạch, phân tích và dựng dashboard, nơi một bước xử lý dữ liệu nhanh và tiết kiệm RAM như Polars giúp pipeline chạy đều đặn.