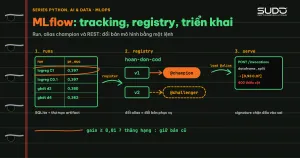
MLflow là nền tảng mã nguồn mở để quản lý vòng đời học máy: ghi lại từng lần huấn luyện, lưu mô hình cùng chữ ký đầu vào, đặt tên và đánh phiên bản trong một registry, rồi phục vụ mô hình qua REST. Bài này dựng đúng quy trình đó cho một bài toán gần doanh nghiệp bán hàng Việt Nam, dự đoán đơn thu hộ (COD) có bị hoàn hay không, trên một máy duy nhất, chỉ với SQLite và thư mục cục bộ. Mọi số trong bài là output thật của mã trong code/s7-50.
Bài nối tiếp Phục vụ LLM tự host với vLLM và Phục vụ mô hình AI bằng FastAPI: hai bài đó nói về chạy mô hình cho nhanh, còn bài này nói về việc đứng trước đó, tức biết mô hình đang chạy là bản nào, huấn luyện ra sao và quay lại bản cũ thế nào. Môi trường: Apple M4, 16 GB, Python 3.12, mlflow==3.10.1 (phát hành 05/03/2026), scikit-learn==1.8.0, numpy==2.4.4.
Vấn đề MLOps giải quyết: mô hình không phải là một file
Một nhóm dữ liệu nhỏ thường bắt đầu bằng notebook và một file model.pkl gửi qua chat. Vài tuần sau xuất hiện các câu hỏi không ai trả lời được: file này huấn luyện với tham số nào, trên dữ liệu ngày nào, chỉ số trên tập kiểm thử bao nhiêu; dịch vụ production đang dùng bản nào; hôm qua đổi bản thì ai đổi, đổi lúc nào; khách hàng khiếu nại một quyết định thì tái hiện thế nào. Đó là bốn nhu cầu khác nhau:
- Truy vết thí nghiệm: mỗi lần chạy ghi tham số, chỉ số, mã nguồn, file đầu ra.
- Đóng gói mô hình: mô hình đi kèm môi trường và giao diện đầu vào, đầu ra, không chỉ trọng số.
- Quản lý phiên bản và vòng đời: tên ổn định, số phiên bản tăng dần, nhãn trạng thái.
- Triển khai: một cách chuẩn để nạp và phục vụ mô hình mà không phụ thuộc vào cách huấn luyện.
MLflow chia đúng bốn phần này thành Tracking, Models, Model Registry và công cụ triển khai. Điểm mạnh là chúng ghép lỏng với nhau: bạn có thể chỉ dùng Tracking, hoặc chỉ dùng định dạng Model, và thêm phần còn lại khi cần.
Kiến trúc: backend store và artifact store
Theo tài liệu Tracking, một run là một lần thực thi mã huấn luyện, một experiment là nhóm các run cho cùng một bài toán. Dữ liệu của run nằm ở hai nơi riêng biệt:
| Thành phần | Lưu gì | Trong bài này | Production thường dùng |
|---|---|---|---|
| Backend store | Metadata: run, tham số, chỉ số, tag, bảng registry | SQLite mlflow.db | PostgreSQL hoặc MySQL |
| Artifact store | File lớn: mô hình, ảnh, bảng dữ liệu | Thư mục mlartifacts/ | Object storage (S3 và tương đương) |
| Tracking server | REST API và giao diện web | Không dùng (ghi thẳng vào SQLite) | Một tiến trình mlflow server cho cả nhóm |
Tài liệu kiến trúc tự host nêu rằng backend hỗ trợ postgresql, mysql, sqlite và mssql qua SQLAlchemy, và backend cơ sở dữ liệu cho hiệu năng, độ tin cậy tốt hơn backend tệp mặc định. Registry cần backend dạng cơ sở dữ liệu, nên ta dùng SQLite ngay từ đầu thay vì thư mục mlruns. Với một nhóm từ hai người trở lên, hãy chạy tracking server dùng chung: tài liệu viết rằng server là thành phần thiết yếu cho phát triển theo nhóm và cung cấp các tính năng như kiểm soát truy cập.
Bài toán và dữ liệu mẫu
Dữ liệu là 4.000 đơn COD sinh giả lập bằng NumPy với hạt giống cố định: giá trị đơn (VND), số đơn trước đó, tỉ lệ hoàn cũ của khách, giờ đặt, khách mới hay cũ. Tỉ lệ hoàn khoảng 21%. Dữ liệu giả lập có chủ đích để không đụng thông tin khách thật, và để bài chạy được trong vài giây. Tách 75/25 có phân tầng. Phần cấu hình dùng chung trong common.py:
MODEL_NAME = "hoan-don-cod"
TRACKING_URI = f"sqlite:///{HERE}/mlflow.db"   # backend store: SQLite
ARTIFACT_ROOT = f"{HERE}/mlartifacts"           # artifact store: thư mục cục bộ
FEATURES = ["gia_tri_don", "so_don_truoc", "ti_le_hoan_cu", "gio_dat", "la_khach_moi"]
Lưu ý kiểu dữ liệu: các cột nguyên được ép sang float64 ngay từ đầu, vì chữ ký ghi kiểu từng cột và dữ liệu thật có thể có ô trống làm cột nguyên thành số thực lúc chạy.
Bước 1: theo dõi thí nghiệm bằng run
Mỗi cấu hình là một run. Trong with mlflow.start_run() ta ghi tham số bằng log_param, chỉ số bằng log_metric, file tuỳ ý bằng log_dict hoặc log_artifact, và lưu chính mô hình bằng mlflow.sklearn.log_model. Ta chạy bốn cấu hình: hồi quy logistic với hai giá trị C, và gradient boosting với độ sâu 2 và 4. Phần cốt lõi của vòng lặp trong step1_track.py:
mlflow.set_tracking_uri(TRACKING_URI)
if mlflow.get_experiment_by_name(EXPERIMENT) is None:
    mlflow.create_experiment(EXPERIMENT, artifact_location=ARTIFACT_ROOT)
mlflow.set_experiment(EXPERIMENT)

with mlflow.start_run(run_name=run_name) as run:
    mlflow.set_tag("nguoi_chay", "nhom-du-lieu")
    mlflow.log_param("model", kind)
    mlflow.log_params(p)
    model.fit(X_tr, y_tr)
    proba = model.predict_proba(X_te)[:, 1]
    mlflow.log_metric("auc", roc_auc_score(y_te, proba))
    mlflow.log_metric("pr_auc", average_precision_score(y_te, proba))
    mlflow.log_dict({"features": FEATURES, "thr": 0.3}, "config/serving.json")
    sig = infer_signature(X_te, model.predict_proba(X_te))
    mlflow.sklearn.log_model(model, name=model, signature=sig,
                             pyfunc_predict_fn="predict_proba",
                             input_example=X_te.head(2))
Có ba chi tiết đáng nói. Thứ nhất, ta dùng PR-AUC bên cạnh AUC vì lớp "hoàn đơn" chỉ chiếm khoảng một phần năm (lý do đã bàn ở Đánh giá mô hình phân loại). Thứ hai, pyfunc_predict_fn="predict_proba" làm cho giao diện chung predict() của mô hình đã nạp trả về xác suất thay vì nhãn cứng, nên dịch vụ phía sau tự chọn ngưỡng. Thứ ba, input_example khiến MLflow lưu mẫu đầu vào và kiểm tra ngay lúc log rằng mô hình chạy được với mẫu đó. Chạy step1_track.py cho kết quả sau (bốn run, dữ liệu nhỏ nên chạy trong vài giây trên máy cá nhân):
train (3000, 5) test (1000, 5) ti le hoan 0.209
logreg_C0.1  run_id=0a7cfe8d auc=0.7134 pr_auc=0.3967
logreg_C1    run_id=8bf8506f auc=0.7134 pr_auc=0.3968
gbdt_d2      run_id=d358d415 auc=0.7022 pr_auc=0.3799
gbdt_d4      run_id=b7b47694 auc=0.6756 pr_auc=0.3620
Kết quả hơi bất ngờ nhưng thực tế: mô hình tuyến tính thắng cây tăng cường. Dữ liệu sinh từ một hàm logit, tập huấn luyện chỉ 3.000 dòng, nên mô hình sâu hơn (max_depth=4) học cả nhiễu và AUC giảm còn 0,6756. Giá trị của Tracking nằm đúng chỗ này: bạn có bốn dòng so sánh được, thay vì nhớ "hình như bản gradient boosting tốt hơn". Mở giao diện bằng mlflow ui --backend-store-uri sqlite:///mlflow.db sẽ thấy cùng bảng đó, kèm biểu đồ so sánh (giao diện web không chạy trong bài).
Nên ghi cả phiên bản dữ liệu, seed và commit git của mã huấn luyện dưới dạng tag: khi tái hiện, ba thứ này quan trọng không kém siêu tham số. Lệnh mlflow.autolog() tự ghi tham số, chỉ số và mô hình cho scikit-learn, XGBoost, PyTorch; tiện cho thăm dò, nhưng ở pipeline chính thức nên ghi tường minh.
Bước 2: Model Registry với alias
Mô hình được log trong run mới chỉ là một artifact. Registry thêm ba thứ: một tên ổn định (hoan-don-cod), số phiên bản tăng dần mỗi lần đăng ký, và các nhãn có thể di chuyển. Theo tài liệu Model Registry, alias là tên thay đổi được trỏ tới một phiên bản, ví dụ models:/MyModel@champion, còn tag là cặp khoá, giá trị gắn lên mô hình hoặc phiên bản, chẳng hạn trạng thái kiểm tra. Trang quy trình Model Registry cũng ghi rõ từ MLflow 2.9.0 các Model Stages (Staging, Production) đã bị đánh dấu deprecated và sẽ bị loại bỏ ở một bản chính trong tương lai, alias là cơ chế thay thế. Vì vậy bài này dùng alias, không dùng stage.
Script step2_registry.py sắp xếp các run theo PR-AUC, đăng ký run tốt nhất thành phiên bản 1 và gán alias champion, đăng ký gbdt_d2 thành phiên bản 2 với alias challenger, rồi nạp mô hình theo alias:
mv1 = mlflow.register_model(f"models:/{logged.model_id}", MODEL_NAME)
client.set_registered_model_alias(MODEL_NAME, "champion", mv1.version)
client.set_model_version_tag(MODEL_NAME, mv1.version, "kiem_tra", "da_duyet")
...
champ = mlflow.pyfunc.load_model(f"models:/{MODEL_NAME}@champion")
champ.predict(X_te.head(3))
Output thật:
tags.mlflow.runName params.model  metrics.auc  metrics.pr_auc
          logreg_C1       logreg       0.7134          0.3968
        logreg_C0.1       logreg       0.7134          0.3967
            gbdt_d2         gbdt       0.7022          0.3799
            gbdt_d4         gbdt       0.6756          0.3620

run tốt nhất: logreg_C1 8bf8506f
đăng ký: hoan-don-cod version 1
đăng ký: hoan-don-cod version 2
version 1: aliases=['champion'] tags={'kiem_tra': 'da_duyet'} run=8bf8506f
version 2: aliases=['challenger'] tags={} run=d358d415

signature đầu vào: [('gia_tri_don', 'DataType.double'), ('so_don_truoc', 'DataType.double'), ('ti_le_hoan_cu', 'DataType.double')] ...
champion, xác suất [không hoàn, hoàn] của 3 dòng: [[0.871, 0.129], [0.803, 0.197], [0.387, 0.613]]
sau khi trỏ champion -> v2: [[0.829, 0.171], [0.815, 0.185], [0.355, 0.645]]
hoàn tác champion -> 1
Hai điểm cần chú ý. Một: với MLflow 3, mô hình là thực thể riêng có model_id (dạng m-...), nên ta đăng ký từ models:/<model_id> lấy qua search_logged_models; cách cũ runs:/<run_id>/model vẫn dùng được, nhưng truy theo model_id rõ ràng hơn. Hai: khi trỏ lại alias champion sang phiên bản 2, cùng một dòng nạp mô hình cho ra xác suất khác (dòng đầu từ 0,129 lên 0,171) mà mã phục vụ không đổi một ký tự. Đó chính là lợi ích của alias: triển khai bản mới hay quay lại bản cũ chỉ là một lệnh đổi con trỏ, cùng tinh thần với rollback trong Pipeline deploy, đổi domain, chuyển VPS có rollback.
Bước 3: phục vụ mô hình qua REST
Định dạng MLflow Model là một thư mục tự mô tả. Tệp MLmodel liệt kê các flavor (cách nạp mô hình: sklearn gốc và python_function chung), tham chiếu tới conda.yaml, python_env.yaml, requirements.txt để dựng lại môi trường, cùng chữ ký. Thư mục của champion trong bài (in bởi step4_promote.py):
thư mục model: ['MLmodel', 'conda.yaml', 'input_example.json', 'model.pkl', 'python_env.yaml', 'registered_model_meta', 'requirements.txt', 'serving_input_example.json']Trích từ tệp MLmodel, phần chữ ký quan trọng nhất cho vận hành:
signature:
  inputs: '[{"type": "double", "name": "gia_tri_don", "required": true}, ...
            {"type": "double", "name": "la_khach_moi", "required": true}]'
  outputs: '[{"type": "tensor", "tensor-spec": {"dtype": "float64", "shape": [-1, 2]}}]'
Theo tài liệu signature, chữ ký là hợp đồng giao diện của mô hình và được kiểm tra khi nạp qua PyFunc, khi dùng công cụ triển khai và khi phục vụ REST: cột bắt buộc phải có, cột thừa bị bỏ, chỉ chuyển kiểu an toàn (ví dụ int sang double), chuyển kiểu không an toàn (ví dụ chuỗi sang số) bị từ chối. Ta kiểm chứng đúng điều đó bằng cách chạy server thật. Lệnh phục vụ theo alias:
export MLFLOW_TRACKING_URI="sqlite:///$PWD/mlflow.db"
mlflow models serve -m "models:/hoan-don-cod@champion" -p 5055 --env-manager local
Lệnh mlflow models serve theo hướng dẫn phục vụ cục bộ mở các đường /ping (cũng là /health), /version và /invocations. Tuỳ chọn --env-manager local dùng luôn môi trường Python hiện tại thay vì dựng venv hay conda mới; ở CI nên bỏ tuỳ chọn này để MLflow dựng môi trường sạch từ python_env.yaml, kiểm chứng đúng điều "môi trường đi kèm mô hình". Script step3_serve.sh khởi động server, gọi bốn yêu cầu rồi tắt. Output thật:
== GET /ping
HTTP/1.1 200 OK
== GET /version
3.10.1
== POST /invocations (dataframe_split)
{"predictions": [[0.9332335490800622, 0.06676645091993784], [0.3337304891698575, 0.6662695108301425]]}
== POST /invocations thiếu cột la_khach_moi
{"error_code": "INVALID_PARAMETER_VALUE", "message": "Failed to predict data '   gia_tri_don  so_don_truoc  ti_le_hoan_cu  gio_dat\n0     450000.0           5.0           0.02     14.0'. \nError: Failed to enforce schema of data '   gia_tri_don  so_don_truoc  ti_le_hoan_cu  gio_dat\n0     450000.0           5.0           0.02     14.0' with schema '['gia_tri_don': double (required), 'so_don_truoc': double (required), 'ti_le_hoan_cu': double (required), 'gio_dat': double (required), 'la_khach_moi': double (required)]'. Error: Model is missing inputs ['la_khach_moi']."}
HTTP 400
== POST /invocations kiểu sai (chuỗi)
{"error_code": "BAD_REQUEST", "message": "Invalid input. Data is not compatible with model signature. Failed to convert column gia_tri_don to type 'float64'. Error: 'ValueError(\"could not convert string to float: 'rat lon'\")'"}
HTTP 400
Ba kết quả đáng đọc kỹ. Đơn 450.000 đồng của khách đã mua 5 lần, tỉ lệ hoàn cũ 2%, có xác suất hoàn 6,7%; đơn 2,5 triệu của khách mới đặt lúc 2 giờ sáng, tỉ lệ hoàn cũ 30%, có xác suất 66,6%. Hai yêu cầu sai cho HTTP 400 kèm thông báo nêu đúng cột thiếu (la_khach_moi) hoặc cột sai kiểu (gia_tri_don). Nghĩa là lớp bảo vệ đầu vào có sẵn nhờ chữ ký, bạn không phải tự viết kiểm tra thủ công; tuy vậy thông báo lỗi trả về chứa cả dữ liệu đầu vào, nên nếu đặt server sau cổng công khai hãy lọc thông báo để không lộ dữ liệu khách hàng.
Về định dạng đầu vào, /invocations nhận dataframe_split như trên, hoặc inputs, instances cho dữ liệu dạng tensor. Server này đủ cho thử nghiệm nội bộ và dịch vụ nhỏ. Với tải lớn, bạn có hai hướng. Hướng một là đóng gói thành container bằng mlflow models build-docker (tài liệu triển khai nêu cả lệnh CLI lẫn API Python mlflow.models.build_docker); bước này cần Docker và dựng image nên chưa chạy trong bài. Hướng hai là nạp mô hình bằng mlflow.pyfunc.load_model vào dịch vụ riêng như dịch vụ FastAPI có batching và timeout để tự kiểm soát hàng đợi, giám sát và xác thực.
Bước 4: cổng thăng hạng tự động
Registry chỉ có giá trị khi việc đổi alias có điều kiện. Thay vì để một người bấm nút, ta viết step4_promote.py: nạp cả champion và challenger theo alias, chấm trên cùng tập kiểm thử, và chỉ chuyển champion khi ứng viên hơn ít nhất 0,01 PR-AUC. Ngưỡng này nên đến từ độ dao động giữa các lần chạy chứ không phải con số đẹp; ở bài thật hãy đo bằng bootstrap hoặc cross-validation như trong Pipeline và cross-validation với scikit-learn.
gain = pr_h - pr_c
if gain >= MIN_GAIN:
    client.set_registered_model_alias(MODEL_NAME, "champion", v_h)
    decision = f"THĂNG HẠNG v{v_h}"
else:
    client.set_model_version_tag(MODEL_NAME, v_h, "ket_qua_cong", "khong_dat")
    decision = f"GIỮ champion v{v_c}"
champion v1: pr_auc=0.3968 auc=0.7134
challenger v2: pr_auc=0.3799 auc=0.7022
chênh lệch pr_auc = -0.0169 (ngưỡng 0.01) -> GIỮ champion v1
alias champion hiện trỏ: 1Ứng viên v2 thua 0,0169 nên bị giữ lại và được gắn tag ket_qua_cong=khong_dat; alias vẫn trỏ phiên bản 1. Ghi lại quyết định không thăng hạng cũng quan trọng như quyết định thăng hạng, vì nó cho bạn lịch sử để trả lời "vì sao bản này không được lên". Trong thực tế bạn sẽ chạy script này trong pipeline CI (Jenkins, GitLab) sau bước huấn luyện, tương tự cách Jenkins làm control plane cho hàng trăm website, chỉ khác đối tượng được triển khai là mô hình.
Khi nào không cần MLflow, và đánh đổi
- Một mô hình, một người, không bao giờ đổi: một file có hash và README là đủ; MLflow thêm phần vận hành (cơ sở dữ liệu, server) không cần thiết.
- Định dạng pickle: log sklearn mặc định dùng cloudpickle, và nạp pickle có thể thực thi mã tuỳ ý, điều tài liệu MLflow cũng lưu ý. Chỉ nạp mô hình từ registry mà bạn kiểm soát quyền ghi; nếu cần định dạng an toàn hơn, hãy xem tuỳ chọn skops trong tài liệu MLflow.
- Chi phí vận hành: SQLite chỉ hợp cho một người dùng; nhóm cần PostgreSQL hoặc MySQL, sao lưu cơ sở dữ liệu và kho artifact, và kiểm soát truy cập. Việc sao lưu có thể dùng chung quy trình với backup database hằng đêm bằng mysqldump và rclone.
Lỗi thường gặp
- Server báo
'FastAPI' object has no attribute 'route': tôi gặp lỗi này khipipkéo FastAPI và Starlette 1.x về cùngmlflow 3.10.1; mã phục vụ của MLflow dùng decorator@app.route. Tôi khắc phục bằng cách ghim lại nhóm phụ thuộc (fastapi==0.135.2,starlette==0.52.1,uvicorn==0.43.0,SQLAlchemy==2.0.49,alembic==1.18.4,pydantic<2.13), ghi trongrequirements.txt; tôi không tách riêng từng gói để xác định gói nào là nguyên nhân. Quy tắc chung: ghim cả cây phụ thuộc của dịch vụ phục vụ. - Lỗi
uvicorn: command not found(mã thoát 127) khi chạymlflow models serve --env-manager localmà không kích hoạt venv: MLflow gọiuvicornqua PATH. Thêm.venv/binvào PATH như trongstep3_serve.sh.
Checklist
- Backend store là cơ sở dữ liệu (SQLite cho thử nghiệm, PostgreSQL hoặc MySQL cho nhóm), artifact store là kho chung.
- Mỗi run ghi tham số, chỉ số, seed, phiên bản dữ liệu, commit mã nguồn; chọn chỉ số theo bài toán (PR-AUC cho dữ liệu lệch).
- Mô hình log kèm
signaturevàinput_example; kiểu dữ liệu đã thống nhất. - Đăng ký vào registry, dùng alias (
champion,challenger) và tag trạng thái, không dùng stage. - Dịch vụ nạp theo
models:/ten@alias; đổi bản bằng đổi alias, hoàn tác bằng đổi lại. - Có cổng thăng hạng với ngưỡng rõ ràng và ghi lại cả kết quả không đạt.
Cài đặt: python3.12 -m venv .venv && .venv/bin/pip install -r requirements.txt, rồi chạy lần lượt step1_track.py, step2_registry.py, step3_serve.sh và step4_promote.py trong code/s7-50; các tệp step*_output.txt là output đã dán. Tài liệu gốc: Tracking, Model Registry và alias, Model Signature.
Bài tiếp theo
Giám sát mô hình sau triển khai: data drift, concept drift và cảnh báo. Mô hình đã vào registry và đang phục vụ không có nghĩa là đúng mãi: dữ liệu thật trôi dần so với dữ liệu huấn luyện, và bài sau cho thấy cách phát hiện sớm để biết khi nào cần huấn luyện lại.