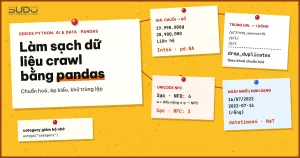
Crawler chạy xong không có nghĩa là dữ liệu dùng được, và pandas là công cụ đầu tiên để sửa. Cùng một sản phẩm có thể xuất hiện ba lần với ba URL khác nhau, giá lúc là 19.990.000₫, lúc là 19.990.000 đ, lúc là Liên hệ; ngày cập nhật khi thì 16/07/2022, khi thì 2022-07-16; tên có khoảng trắng thừa hoặc dấu tiếng Việt ở dạng phân rã mà mắt thường không phân biệt được. Bài này dùng pandas 1.4.3 trên Python 3.10 để biến một tệp CSV crawl bẩn thành bảng sạch: chuẩn hoá văn bản, ép kiểu đúng, khử trùng lặp theo khoá hợp lý và giảm bộ nhớ bằng kiểu category. Mọi đoạn code đều đã chạy thật, output dán nguyên văn.
Bài nối tiếp phần thu thập dữ liệu: Crawl data bằng Python: requests, BeautifulSoup và robots.txt, Crawler lịch sự và hợp lệ: rate limit, cache, ETag và sitemap, và Scrapy từ A tới Z: spider, item pipeline và middleware, nơi sinh ra loại tệp thô mà pandas xử lý ở bài này.
Vì sao dữ liệu crawl luôn bẩn trước khi vào pandas
Trang web được viết cho mắt người, không cho máy phân tích. Mỗi cửa hàng định dạng giá, ngày, tồn kho theo thói quen riêng, và ngay trong một cửa hàng, nhiều mẫu giao diện cũ mới cùng tồn tại. Những lỗi lặp lại ở hầu hết dự án crawl thương mại điện tử:
| Triệu chứng | Nguyên nhân thường gặp | Hậu quả nếu bỏ qua |
|---|---|---|
| Cùng sản phẩm xuất hiện nhiều dòng | URL khác tham số theo dõi (utm_source), có hoặc không dấu / cuối, crawl lại nhiều lần | Thống kê số sản phẩm, giá trung bình bị lệch |
| Giá là chuỗi | Có ký hiệu ₫, đ, dấu chấm hoặc phẩy ngăn cách nghìn, chữ Liên hệ | Không sắp xếp, không tính toán được |
| Ngày nhiều định dạng | Nhiều nguồn, nhiều locale | Đảo nhầm ngày và tháng, im lặng |
| Hai tên giống nhau nhưng không bằng nhau | Hoa thường khác nhau, khoảng trắng kép, Unicode NFC và NFD | Khử trùng lặp bỏ sót, groupby tách nhóm |
| Cột số bị float | Một ô thiếu trong pandas biến cả cột thành float64 với NaN | Mất độ chính xác với số nguyên lớn |
Quy trình đúng đi theo thứ tự: đọc nguyên văn dưới dạng chuỗi, chuẩn hoá từng cột, ép kiểu, tạo khoá, rồi mới khử trùng lặp. Khử trùng lặp trên dữ liệu chưa chuẩn hoá luôn bỏ sót.
Chuẩn bị môi trường pandas và dữ liệu mẫu
Tạo venv riêng cho bài và ghim phiên bản để kết quả tái lập được. Cách làm đã bàn ở Môi trường Python cho dự án dữ liệu và AI: venv, Poetry và quản lý phiên bản.
python3.10 -m venv .venv
.venv/bin/pip install pandas==1.4.3 numpy==1.23.1
Tệp crawl_raw.csv để thử pandas mô phỏng một lần crawl cửa hàng điện tử giả định (domain shop.example, không phải site thật): 9 dòng, có sẵn các lỗi ở bảng trên, gồm một dòng tên ở dạng NFD. Tạo tệp này (kể cả dòng đầu là tiêu đề) để chạy lại mọi ví dụ trong bài. Tên sản phẩm ở dòng dữ liệu thứ bảy (Sạc nhanh 20W) được lưu ở dạng NFD, nên nếu bạn gõ lại bằng tay hãy sao chép nguyên văn:
url,ten,gia,ton_kho,ngay_cap_nhat,danh_muc,danh_gia
https://shop.example/p/ip-13,  Điện thoại iPhone 13 128GB ,"19.990.000₫",Còn 25,16/07/2022,Điện thoại,4.5
https://shop.example/p/ip-13?utm_source=fb,Điện thoại iPhone 13 128GB,"19.990.000 đ",25,2022-07-16,điện thoại,4.5
https://shop.example/p/ss-a53,Samsung  Galaxy A53,"8.490.000đ",Hết hàng,15/07/2022,Điện thoại,4.2
https://shop.example/p/lg-ult,Laptop LG Gram 14,"28.900.000 ₫",3,14/07/2022,Laptop,
https://shop.example/p/lg-ult/,LAPTOP LG GRAM 14,"28,900,000",3,14/07/2022,LAPTOP,N/A
https://shop.example/p/tai-nghe-1,Tai nghe Bluetooth,Liên hệ,120,13/07/2022,Phụ kiện,3.9
https://shop.example/p/sac-20w,Sạc nhanh 20W,"350.000₫",Còn 0,,Phụ kiện,4.0
https://shop.example/p/ip-13,Điện thoại iPhone 13 128GB,"19.990.000₫",25,16/07/2022,Điện thoại,4.5
https://shop.example/p/op-lung,Ốp lưng silicon,"90.000đ",1.200,12/07/2022,Phụ kiện,"4,1"
Bước đầu tiên là đọc mọi cột bằng dtype=str và keep_default_na=False. Nếu để read_csv của pandas tự suy kiểu, chữ N/A sẽ lặng lẽ thành NaN. Đọc thô giúp mọi quyết định chuyển kiểu nằm trong code của bạn, nhìn thấy và kiểm thử được.
import re
from urllib.parse import urlsplit

import pandas as pd

pd.set_option("display.width", 140)
pd.set_option("display.max_columns", 20)

raw = pd.read_csv("crawl_raw.csv", dtype=str, keep_default_na=False)
print("=== 1. Dữ liệu thô ===")
print(raw.drop(columns="url"))
print(raw.dtypes.to_string())

df = raw.copy()
Bảng thô (bỏ cột url cho gọn):
=== 1. Dữ liệu thô ===
                             ten           gia   ton_kho ngay_cap_nhat    danh_muc danh_gia
0    Điện thoại iPhone 13 128GB    19.990.000₫    Còn 25    16/07/2022  Điện thoại      4.5
1     Điện thoại iPhone 13 128GB  19.990.000 đ        25    2022-07-16  điện thoại      4.5
2            Samsung  Galaxy A53    8.490.000đ  Hết hàng    15/07/2022  Điện thoại      4.2
3              Laptop LG Gram 14  28.900.000 ₫         3    14/07/2022      Laptop
4              LAPTOP LG GRAM 14    28,900,000         3    14/07/2022      LAPTOP      N/A
5             Tai nghe Bluetooth       Liên hệ       120    13/07/2022    Phụ kiện      3.9
6                 Sạc nhanh 20W      350.000₫     Còn 0                  Phụ kiện      4.0
7     Điện thoại iPhone 13 128GB   19.990.000₫        25    16/07/2022  Điện thoại      4.5
8                Ốp lưng silicon       90.000đ     1.200    12/07/2022    Phụ kiện      4,1
url              object
ten              object
gia              object
ton_kho          object
ngay_cap_nhat    object
danh_muc         object
danh_gia         object
Trong pandas, mọi cột đều là object. Từ đây ta biến đổi từng cột bằng các hàm của pandas.
Chuẩn hoá văn bản: Unicode NFC, khoảng trắng và chữ hoa
Tiếng Việt có hai cách mã hoá cùng một chữ: dạng dựng sẵn (NFC), ví dụ ạ là một ký tự, và dạng phân rã (NFD), a cộng dấu nặng là hai ký tự. Chuẩn Unicode gọi hai dạng này là tương đương chính tắc: hiển thị giống hệt nhau nhưng so sánh chuỗi thì khác. Tài liệu Unicode Standard Annex #15 mô tả các dạng chuẩn hoá này và nêu rằng W3C khuyến nghị NFC cho nội dung web. Dữ liệu crawl từ nhiều nguồn thường lẫn cả hai.
Pandas có sẵn Series.str.normalize(form) để chuẩn hoá cả cột trong một lệnh; bên dưới nó gọi hàm gốc unicodedata.normalize của thư viện chuẩn Python, hàm bạn dùng khi xử lý một chuỗi riêng lẻ. Ta gói NFC và gộp khoảng trắng vào một hàm vector hoá, rồi áp dụng cho các cột văn bản:
# --- 2. Chuẩn hoá văn bản ---
def norm_text(s: pd.Series) -> pd.Series:
    return (
        s.str.normalize("NFC")                         # gộp dấu tiếng Việt về một dạng
         .str.replace(r"\s+", " ", regex=True)         # gộp khoảng trắng
         .str.strip()
    )

nfd_rows = (raw["ten"] != raw["ten"].str.normalize("NFC")).sum()
print("\nSố tên không ở dạng NFC:", int(nfd_rows))
df["ten"] = norm_text(df["ten"])
df["danh_muc"] = norm_text(df["danh_muc"]).str.lower().str.capitalize()
Chạy bước này trên mẫu, phép so sánh phát hiện đúng một tên đang ở dạng phân rã:
Số tên không ở dạng NFC: 1Chữ hoa chữ thường chỉ chuẩn hoá ở cột danh mục, vì danh mục là nhãn phân loại. Với tên sản phẩm ta giữ nguyên cách viết hoa để hiển thị, và chỉ dùng casefold() khi tạo khoá so sánh. Nguyên tắc: cột để hiển thị giữ nguyên dạng đẹp, cột để so khớp chuyển về dạng chuẩn.
Ép kiểu số với Int64 và pd.NA
Giá là bài toán chính. Ba định dạng xuất hiện trong mẫu: 19.990.000₫, 28,900,000 và Liên hệ. Cách đơn giản và bền là bỏ mọi ký tự không phải chữ số, rồi chuyển số nguyên; ô không còn chữ số nào (như Liên hệ) trở thành giá trị thiếu. Tiền đồng không có phần thập phân nên cách này đúng; với tiền tệ có phần lẻ thì không được dùng \D máy móc.
# --- 3. Giá: chuỗi -> số nguyên có thể thiếu (Int64) ---
def parse_price(s: str):
    digits = re.sub(r"\D", "", s)              # bỏ ., ₫, đ, khoảng trắng
    return int(digits) if digits else pd.NA

df["gia"] = pd.array([parse_price(x) for x in df["gia"]], dtype="Int64")
Điểm đáng chú ý là kiểu Int64 (chữ I viết hoa), kiểu số nguyên cho phép thiếu giá trị. Theo tài liệu nullable integer của pandas, NaN là số thực nên cột nguyên có ô thiếu thường bị đẩy sang float64; kiểu Int64 dùng pd.NA làm dấu thiếu và giữ nguyên là số nguyên. Float64 chỉ biểu diễn chính xác số nguyên tới 253, ví dụ ở phần lỗi thường gặp bên dưới.
Cột tồn kho có ba dạng chữ (Còn 25, Hết hàng, 1.200 với dấu chấm ngăn nghìn kiểu Việt Nam), còn cột đánh giá có dấu phẩy thập phân (4,1), ô trống và N/A. Hàm pd.to_numeric(..., errors="coerce") của pandas biến mọi thứ không phân tích được thành thiếu, thay vì làm sập cả pipeline:
# --- 4. Tồn kho, đánh giá ---
df["ton_kho"] = (
    df["ton_kho"].str.replace("Còn", "", regex=False).str.replace(".", "", regex=False)
    .str.strip().replace({"Hết hàng": "0"})
)
df["ton_kho"] = pd.to_numeric(df["ton_kho"], errors="coerce").astype("Int64")
df["danh_gia"] = pd.to_numeric(
    df["danh_gia"].str.replace(",", ".", regex=False), errors="coerce"
)
Cẩn thận với errors="coerce": nó che lỗi, nên sau khi chuyển hãy đếm số ô thiếu mới phát sinh.
Chuẩn hoá ngày tháng nhiều định dạng
Cột ngày chứa hai định dạng: 16/07/2022 và 2022-07-16. Đừng gọi pd.to_datetime không tham số trên cả cột. Khi chuỗi mơ hồ như 03/04/2022, pandas mặc định hiểu là tháng trước ngày sau (kiểu Mỹ). Cách an toàn là khai báo format tường minh cho từng định dạng đã biết, đặt errors="coerce" để dòng không khớp thành NaT, rồi ghép kết quả bằng fillna:
# --- 5. Ngày: hai định dạng trong cùng một cột ---
d1 = pd.to_datetime(df["ngay_cap_nhat"], format="%d/%m/%Y", errors="coerce")
d2 = pd.to_datetime(df["ngay_cap_nhat"], format="%Y-%m-%d", errors="coerce")
df["ngay_cap_nhat"] = d1.fillna(d2)
Dòng Sạc nhanh 20W có ô ngày trống nên không khớp định dạng nào và ra NaT; đó là dữ liệu thiếu thật chứ không phải lỗi phân tích. Kết quả kiểm tra được in ở cuối bài: thiếu ngày: 1, và dòng Dòng NaT: ['Sạc nhanh 20W'].
Khử trùng lặp theo khoá chuẩn hoá
Hàm DataFrame.drop_duplicates nhận hai tham số quan trọng: subset (so sánh trên những cột nào) và keep ('first', 'last' hoặc False). Gọi pandas trên toàn bộ cột gần như vô dụng với dữ liệu crawl, vì hai bản ghi của cùng một sản phẩm hiếm khi giống nhau từng ô: thời điểm crawl, URL có tham số theo dõi hay trạng thái tồn kho đều khác. Ta cần một khoá định danh do mình tính ra.
Với sản phẩm, khoá tự nhiên là URL đã chuẩn hoá: viết thường tên miền, bỏ chuỗi truy vấn (?utm_source=fb) và dấu / cuối. Hàm urlsplit trong thư viện chuẩn tách URL đúng chuẩn, an toàn hơn cắt chuỗi bằng tay. Lưu ý: bỏ toàn bộ query chỉ hợp lệ khi tham số không quyết định nội dung trang; với trang phân trang kiểu ?page=2 bạn phải giữ lại các tham số đó.
Khi có nhiều bản ghi trùng, giữ bản nào cũng là quyết định nghiệp vụ. Ở đây ta giữ bản có ngay_cap_nhat mới nhất: sắp xếp giảm dần theo ngày, drop_duplicates(..., keep="first"), rồi trả về thứ tự ban đầu bằng sort_index. Tham số kind="stable" bảo đảm khi hai bản cùng ngày, bản xuất hiện trước được giữ, kết quả tái lập giữa các lần chạy.
# --- 6. Khoá khử trùng lặp: URL chuẩn hoá ---
def canon_url(u: str) -> str:
    p = urlsplit(u)
    return f"{p.scheme}://{p.netloc.lower()}{p.path.rstrip('/')}"   # bỏ query, dấu / cuối

df["url_chuan"] = df["url"].map(canon_url)
print("\n=== 2. Số bản ghi trùng theo URL chuẩn ===")
print(df.duplicated("url_chuan", keep=False).sum(), "dòng thuộc nhóm trùng")

before = len(df)
df = (
    df.sort_values("ngay_cap_nhat", ascending=False, kind="stable")
      .drop_duplicates("url_chuan", keep="first")
      .sort_index()
      .reset_index(drop=True)
)
print(f"{before} -> {len(df)} dòng sau khi khử trùng lặp")
print("Còn trùng theo tên (không phân biệt hoa thường):", int(df["ten"].str.casefold().duplicated().sum()))
Kết quả khử trùng lặp:
=== 2. Số bản ghi trùng theo URL chuẩn ===
5 dòng thuộc nhóm trùng
9 -> 6 dòng sau khi khử trùng lặp
Còn trùng theo tên (không phân biệt hoa thường): 0
Chín dòng còn sáu: năm dòng thuộc nhóm trùng (ba bản của iPhone 13, hai bản của Laptop LG Gram 14) gộp về hai. Dòng cuối kiểm tra chéo bằng khoá thứ hai là tên: bằng 0 nghĩa là khoá URL không bỏ sót trường hợp nào.
Kiểu category và đo bộ nhớ
Cột có ít giá trị khác nhau lặp lại nhiều lần, như danh mục hay thương hiệu, nên chuyển sang kiểu categorical của pandas. Thay vì lưu từng chuỗi, pandas lưu một bảng các giá trị duy nhất cộng mảng mã số nguyên nhỏ. Bẫy của pandas cần nhớ là phải chuẩn hoá chữ hoa thường trước khi chuyển kiểu, nếu không Điện thoại và điện thoại thành hai nhóm riêng.
# --- 7. Kiểu dữ liệu cuối ---
df["danh_muc"] = df["danh_muc"].astype("category")
df = df.drop(columns="url").rename(columns={"url_chuan": "url"})
print("\n=== 3. Sau khi làm sạch ===")
print(df)
print(df.dtypes.to_string())
print("\nThiếu giá:", int(df["gia"].isna().sum()), "| thiếu ngày:", int(df["ngay_cap_nhat"].isna().sum()))
print("Dòng NaT:", df.loc[df["ngay_cap_nhat"].isna(), "ten"].tolist())
print("\nDoanh mục:", df["danh_muc"].cat.categories.tolist())
print("\nGiá trung bình theo danh mục:")
print(df.groupby("danh_muc", observed=True)["gia"].mean().round(0).to_string())

# --- 8. Bộ nhớ: object vs category/Int64 ---
big_raw = pd.concat([raw] * 20000, ignore_index=True)
big = pd.DataFrame({
    "danh_muc": norm_text(big_raw["danh_muc"]).str.lower(),
    "gia": pd.array([parse_price(x) for x in big_raw["gia"]], dtype="Int64"),
})
m_obj = big.memory_usage(deep=True).sum()
big["danh_muc"] = big["danh_muc"].astype("category")
m_cat = big.memory_usage(deep=True).sum()
print(f"\nBộ nhớ {len(big):,} dòng: object {m_obj/1e6:.1f} MB -> category {m_cat/1e6:.1f} MB")
Toàn bộ output phần bảng sạch:
=== 3. Sau khi làm sạch ===
                          ten       gia  ton_kho ngay_cap_nhat    danh_muc  danh_gia                                url
0  Điện thoại iPhone 13 128GB  19990000       25    2022-07-16  Điện thoại       4.5       https://shop.example/p/ip-13
1          Samsung Galaxy A53   8490000        0    2022-07-15  Điện thoại       4.2      https://shop.example/p/ss-a53
2           Laptop LG Gram 14  28900000        3    2022-07-14      Laptop       NaN      https://shop.example/p/lg-ult
3          Tai nghe Bluetooth      <NA>      120    2022-07-13    Phụ kiện       3.9  https://shop.example/p/tai-nghe-1
4               Sạc nhanh 20W    350000        0           NaT    Phụ kiện       4.0     https://shop.example/p/sac-20w
5             Ốp lưng silicon     90000     1200    2022-07-12    Phụ kiện       4.1     https://shop.example/p/op-lung
ten                      object
gia                       Int64
ton_kho                   Int64
ngay_cap_nhat    datetime64[ns]
danh_muc               category
danh_gia                float64
url                      object

Thiếu giá: 1 | thiếu ngày: 1
Dòng NaT: ['Sạc nhanh 20W']

Doanh mục: ['Laptop', 'Phụ kiện', 'Điện thoại']

Giá trung bình theo danh mục:
danh_muc
Điện thoại    14240000.0
Laptop        28900000.0
Phụ kiện        220000.0

Bộ nhớ 180,000 dòng: object 18.2 MB -> category 1.8 MB
Cột gia là Int64, ngay_cap_nhat là datetime64[ns], danh_muc là category. Sản phẩm Tai nghe Bluetooth có giá <NA> và Sạc nhanh có ngày NaT, cả hai là dữ liệu thiếu thật chứ không phải lỗi phân tích. Đo trên Apple M4 (16 GB), lặp mẫu 20.000 lần thành 180.000 dòng, bộ nhớ giảm từ 18,2 MB còn 1,8 MB khi chuyển cột danh mục từ object sang category. Con số phụ thuộc số giá trị khác nhau: cột gần như duy nhất mỗi dòng như tên sản phẩm sẽ không được lợi gì.
Khi nào không nên làm sạch bằng pandas
- Dữ liệu vượt RAM: pandas nạp toàn bộ bảng vào bộ nhớ, nên pandas không hợp với tập quá lớn. Với vài chục triệu dòng, hãy đọc theo
chunksize, hoặc làm sạch ngay trong database và pipeline của Scrapy. - Làm sạch theo từng bản ghi khi crawl: pandas xử lý theo lô, nên nếu mỗi item chỉ cần ép kiểu và kiểm tra trường bắt buộc, item pipeline hoặc Pydantic gọn hơn, và bản ghi sai bị chặn sớm.
- Cần truy vết: giữ bản thô bất biến, làm sạch ra bản mới. Đừng ghi đè tệp gốc, để khi quy tắc thay đổi bạn chạy lại từ đầu được.
Lỗi thường gặp khi làm sạch dữ liệu bằng pandas
Sáu bẫy dưới đây là lý do bảng sạch ở trên được làm theo đúng thứ tự đó. Mỗi bẫy là một khối code độc lập kèm output thật (Python 3.10.22, pandas 1.4.3); bạn chỉ cần import pandas as pd và import unicodedata ở đầu tệp.
Bẫy 1: khử trùng lặp trước khi chuẩn hoá
raw = pd.DataFrame({"ten": ["Laptop LG Gram 14", "LAPTOP LG GRAM  14", " laptop lg gram 14"]})
print("drop_duplicates trên dữ liệu thô giữ lại:", len(raw.drop_duplicates()), "dòng")
key = raw["ten"].str.casefold().str.split().str.join(" ")
print("Sau khi chuẩn hoá khoá:", len(raw.drop_duplicates().loc[~key.duplicated()]), "dòng")
drop_duplicates trên dữ liệu thô giữ lại: 3 dòng
Sau khi chuẩn hoá khoá: 1 dòngBa tên chỉ khác nhau ở hoa thường và khoảng trắng nên drop_duplicates của pandas coi là ba bản ghi riêng; sau khi chuẩn hoá khoá chỉ còn một.
Bẫy 2: NFC khác NFD
a = "Sạc"                                   # NFC
b = unicodedata.normalize("NFD", a)         # NFD
print(a == b, len(a), len(b), a == unicodedata.normalize("NFC", b))
False 3 4 True"Sạc" dạng dựng sẵn có 3 ký tự, dạng phân rã có 4 nên == trả về False; đưa về NFC thì bằng nhau.
Bẫy 3: cột số bị float
print(pd.Series([19990000, None]).dtype, pd.Series([19990000, None], dtype="Int64").dtype)
big = 9007199254740993                      # 2**53 + 1
print(int(pd.Series([big, None])[0]), int(pd.Series([big, None], dtype="Int64")[0]))
float64 Int64
9007199254740992 9007199254740993Một ô thiếu đẩy cả cột sang float64, và pandas làm tròn số nguyên 9007199254740993 (253 + 1) thành ...992, còn Int64 giữ nguyên. Mã sản phẩm hay số điện thoại lưu dạng số rất dễ dính lỗi này.
Bẫy 4: ngày mơ hồ
s = pd.Series(["03/04/2022"])
print(pd.to_datetime(s).iloc[0].date(), pd.to_datetime(s, dayfirst=True).iloc[0].date())
print(pd.to_datetime(pd.Series(["16/07/2022"]), errors="coerce").iloc[0])
print(pd.to_datetime(pd.Series(["16/07/2022"]), format="%d/%m/%Y").iloc[0].date())
UserWarning: Parsing '16/07/2022' in DD/MM/YYYY format. Provide format or specify infer_datetime_format=True for consistent parsing.
2022-03-04 2022-04-03
2022-07-16 00:00:00
2022-07-16Pandas hiểu 03/04/2022 là ngày 4 tháng 3 nếu để mặc định, và ngày 3 tháng 4 nếu có dayfirst=True. Chuỗi 16/07/2022 ra đúng nhờ pandas tự đoán và phát cảnh báo UserWarning như trên (dòng cảnh báo được in ra stderr trước các dòng kết quả); đừng dựa vào phỏng đoán đó, khi định dạng đã biết hãy luôn khai báo format.
Bẫy 5: to_numeric ném lỗi hoặc im lặng ra NaN
try:
    pd.to_numeric(pd.Series(["25", "Liên hệ"]))
except ValueError as e:
    print("ValueError:", e)
print(pd.to_numeric(pd.Series(["25", "Liên hệ"]), errors="coerce").tolist())
ValueError: Unable to parse string "Liên hệ" at position 1
[25.0, nan]Không có errors, gặp Liên hệ là ném ValueError ngay; với errors="coerce" ra NaN nhưng bạn phải tự đếm lại số ô thiếu mới.
Bẫy 6: chuyển category quá sớm
c = pd.Series(["Điện thoại", "điện thoại", "ĐIỆN THOẠI"]).astype("category")
print(len(c.cat.categories), "nhóm khác nhau do chưa chuẩn hoá")
3 nhóm khác nhau do chưa chuẩn hoáBa cách viết một danh mục thành ba nhóm; hãy chuẩn hoá chữ hoa thường trước khi gọi astype("category").
Checklist làm sạch dữ liệu crawl
- Đọc thô bằng pandas với
dtype=strvàkeep_default_na=False, giữ bản gốc bất biến. - Chuẩn hoá văn bản: NFC, gộp khoảng trắng, chuẩn hoá hoa thường cho cột nhãn.
- Trong pandas, dùng
Int64cho số nguyên có thể thiếu;to_numeric(errors="coerce")kèm đếm số ô thiếu mới. - Ngày: khai báo
formattường minh cho từng định dạng đã biết. - Khử trùng lặp bằng khoá do bạn tính (URL chuẩn hoá), chọn bản giữ lại theo quy tắc rõ ràng.
- Chuyển cột nhãn ít giá trị sang
categorycủa pandas sau khi đã chuẩn hoá. - In kiểu dữ liệu, số dòng trước sau và số ô thiếu như một kiểm tra tối thiểu; chuyển chúng thành test khi pipeline chạy định kỳ.
Tóm lại, làm sạch dữ liệu bằng pandas không phải là chuỗi lệnh rời rạc mà là một quy trình có thứ tự, mỗi bước có một kiểm tra đi kèm. Cũng nhắc lại: chỉ crawl nơi được phép và tránh lưu dữ liệu cá nhân không cần thiết, như đã nhấn mạnh ở bài về crawler hợp lệ.
Bài tiếp theo
Bảng pandas đã sạch và đã có kiểu số đúng, bước tiếp theo là tính toán trên hàng triệu giá trị mà không viết vòng lặp Python. Mời bạn đọc tiếp NumPy cho machine learning: vector hoá và broadcasting.