Chỉ cần một dòng targetCPUUtilizationPercentage: 90 trong values.yaml, website Laravel đã có HPA (HorizontalPodAutoscaler) và tự thêm pod khi tải tăng. Nhưng khi bạn bật HPA rồi chạy thử tải, những câu hỏi thật mới xuất hiện: 90% của cái gì, bao lâu thì thêm pod, bao lâu thì bớt pod, và vì sao web vẫn chết trước khi pod mới kịp lên. Bài này đi vào cơ chế: HPA lấy số liệu từ đâu, công thức tính số pod, vì sao ngưỡng tính trên request, cách chỉnh behavior và cách cài metrics-server cho đúng.
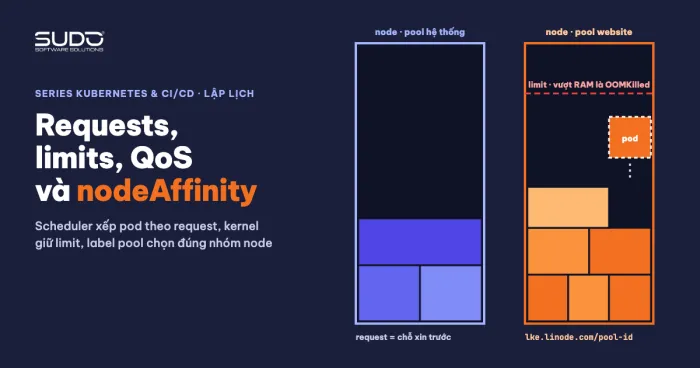
Cách khai báo HPA bằng một dòng values đã nói ở bài Helm chart là gì: đóng gói website Laravel để deploy lặp lại. Việc đặt request, limit cho đúng nằm ở bài Requests và limits, QoS và nodeAffinity, còn pm.max_children ở bài pm.max_children cho pod PHP-FPM.
HPA lấy số liệu từ đâu: metrics-server
HPA không tự đo CPU. Nó hỏi Metrics API (metrics.k8s.io), và API này do metrics-server cung cấp bằng cách gom số liệu từ kubelet của từng node. Nếu chưa có metrics-server, cả kubectl top lẫn HPA đều không có dữ liệu. Triệu chứng điển hình:
kubectl top pods -n site-a
error: Metrics API not available

kubectl get hpa -n site-a
NAME     REFERENCE         TARGETS         MINPODS   MAXPODS
site-a   Deployment/web    <unknown>/90%   1         3
Cột TARGETS hiện <unknown> nghĩa là HPA chưa đọc được số liệu. Trước khi cài thêm, hãy kiểm tra cluster đã có sẵn chưa, vì một số nhà cung cấp cài sẵn metrics-server, một số thì không:
kubectl get deployment metrics-server -n kube-system
kubectl get apiservice v1beta1.metrics.k8s.io
kubectl get --raw /apis/metrics.k8s.io/v1beta1/nodes
Nếu cần cài, hãy ghim một phiên bản cụ thể của components.yaml thay vì latest, để lần cài sau cho kết quả giống lần này (thay <phien-ban> bằng phiên bản bạn đã kiểm tra tương thích với cluster):
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/download/<phien-ban>/components.yaml
kubectl rollout status deployment/metrics-server -n kube-system
Trường hợp pod metrics-server chạy nhưng API vẫn báo không sẵn sàng, một cách xử lý hay gặp là thêm cờ --kubelet-insecure-tls vào args của container. Cờ này bỏ qua việc kiểm tra chứng chỉ của kubelet, nên chỉ dùng để thử nghiệm. Nguyên nhân thật (thường là chứng chỉ kubelet không khớp địa chỉ mà metrics-server kết nối) cần xác nhận bằng kubectl logs -n kube-system deploy/metrics-server.
Công thức tính số pod của HPA
Mỗi chu kỳ (mặc định 15 giây), HPA tính:
desiredReplicas = ceil[ currentReplicas * ( currentMetricValue / desiredMetricValue ) ]Ví dụ có 3 pod, ngưỡng đặt là 50%, mức dùng trung bình hiện tại là 170%. Tỉ lệ là 3,4, nên 3 × 3,4 = 10,2, làm tròn lên thành 11 pod. Hai chi tiết cần nhớ. Thứ nhất, nếu tỉ lệ nằm trong dung sai (mặc định 0,1, tức khoảng 10%) thì HPA không làm gì. Thứ hai, kết quả luôn bị chặn bởi minReplicas, maxReplicas và các policy trong behavior. Chu kỳ 15 giây, dung sai và thời gian ổn định mặc định là cờ của kube-controller-manager; trên cluster managed bạn thường không chỉnh được chúng, cách thực tế là dùng spec.behavior ở các phần sau.
Ngưỡng Utilization tính trên request, không phải limit
Với metric kiểu Utilization, HPA lấy mức dùng của pod chia cho resources.requests của pod đó rồi lấy trung bình. Không phải limit, cũng không phải dung lượng node. Hệ quả:
- Mọi container trong pod phải khai request CPU. Thiếu request thì HPA không tính được phần trăm.
- Request càng nhỏ, phần trăm càng dễ vượt ngưỡng. Pod có request
200mvà ngưỡng 90% sẽ bị coi là quá tải khi dùng khoảng180m, dù limit là cả 1 core. Đây là suy luận từ công thức, không phải số đo. - Khi nghe "CPU lên 100%", hãy hỏi 100% của đại lượng nào: của request, của limit hay của cả node. Ba con số này khác nhau rất xa.
Request đặt quá thấp còn làm node dễ đầy ngoài ý muốn, như bài Node đầy RAM: web chậm dù CPU thấp, overcommit limit và node NotReady đã phân tích.
Có một chi tiết nữa về pod mới khởi động: khi tính trung bình, HPA bỏ qua pod chưa Ready và pod vừa khởi động trong khoảng --horizontal-pod-autoscaler-cpu-initialization-period (mặc định 5 phút, cờ của kube-controller-manager), để số đo CPU tăng vọt lúc khởi động không làm HPA tính sai. Đây là lý do readiness probe ảnh hưởng tới HPA. Chi tiết nằm trong tài liệu chính thức ở cuối bài.
Behavior: scale-up nhanh, scale-down chậm
Trường spec.behavior điều khiển tốc độ thay đổi. Giá trị mặc định tương đương:
behavior:
  scaleDown:
    stabilizationWindowSeconds: 300
    policies:
    - type: Percent
      value: 100
      periodSeconds: 15
  scaleUp:
    stabilizationWindowSeconds: 0
    policies:
    - type: Percent
      value: 100
      periodSeconds: 15
    - type: Pods
      value: 4
      periodSeconds: 15
    selectPolicy: Max
stabilizationWindowSeconds không phải đồng hồ đếm lùi. HPA lưu các khuyến nghị trong cửa sổ đó rồi chọn khuyến nghị cao nhất khi scale-down (hoặc thấp nhất khi scale-up), nên khi tải vừa giảm, số pod chỉ hạ sau khi mọi khuyến nghị trong cửa sổ đều thấp. Bạn có thể tự kiểm chứng: đặt scaleDown.stabilizationWindowSeconds là 300 rồi hạ tải, số pod chỉ giảm sau khoảng 5 phút. Với scaleUp.stabilizationWindowSeconds là 60, pod mới chỉ tăng sau khoảng 60 giây kể từ lúc vượt ngưỡng. Bài này chưa so sánh scale-up 0 giây với 60 giây trên cùng một kịch bản, nên hãy tự đo trước khi chọn giá trị.
Lỗi hiểu sai hay gặp là "số pod nhân đôi liên tục, 3 lên 6 rồi 12". Thực tế mỗi chu kỳ bị chặn bởi policy và maxReplicas. Với 3 pod, policy Percent 100 cho phép thêm 3 (thành 6), policy Pods 4 cho phép thêm 4 (thành 7); selectPolicy: Max chọn policy cho kết quả lớn hơn, tức 7.
Với site chỉ có một node 1 core, đặt cửa sổ scale-up dài là không hợp lý: đã chờ HPA, lại còn chờ pod khởi động và có thể chờ node mới. Nên để scale-up mặc định (0 giây) và chỉ kéo dài scale-down.
Vì sao thao tác nặng một lần làm web chết trước khi scale
Giả sử một thao tác như kích hoạt theme hoặc sinh nội dung hàng loạt đẩy CPU lên kịch trần ngay lập tức. Chuỗi phản ứng của HPA có độ trễ ở mọi bước: metrics-server lấy mẫu theo chu kỳ, HPA đồng bộ mỗi 15 giây, rồi pod mới phải kéo image, khởi động PHP-FPM và qua readiness probe; nếu node đầy, còn phải chờ Cluster Autoscaler thêm node mới (chủ đề của bài tiếp theo). Trong thời gian đó, pod hiện có vẫn nhận request, bị throttle CPU, phản hồi chậm hoặc timeout, và có thể bị restart nếu liveness probe thất bại trước khi pod mới sẵn sàng. HPA là vòng phản hồi, không phải lớp chống tải đột ngột. Cách giảm rủi ro: đặt minReplicas từ 2 trở lên cho site quan trọng, đẩy việc nặng sang queue, và đừng đặt ngưỡng sát 100%.
Metric tuyệt đối thay vì phần trăm
Nếu phần trăm trên request làm HPA quá nhạy, bạn có thể đặt ngưỡng theo giá trị tuyệt đối. Với CPU và memory, dùng AverageValue; cách này không cần adapter nào:
metrics:
- type: Resource
  resource:
    name: cpu
    target:
      type: AverageValue
      averageValue: 400m
Với metric ngoài CPU và memory (ví dụ CPU theo rate của Prometheus, số request mỗi giây), cần một adapter như Prometheus Adapter để đưa metric vào custom.metrics.k8s.io, rồi khai báo type: Pods. Kiểm tra bằng kubectl get --raw /apis/custom.metrics.k8s.io/v1beta1. Theo kinh nghiệm, memory là metric kém cho PHP-FPM vì worker giữ bộ nhớ sau khi xử lý xong, nên số pod khó giảm lại; đây là khuyến nghị kinh nghiệm chứ không phải quy tắc cứng.
YAML mẫu và checklist chẩn đoán
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: site-a
  namespace: site-a
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: web
  minReplicas: 2
  maxReplicas: 5
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
      - type: Pods
        value: 1
        periodSeconds: 60
Lưu ý: targetCPUUtilizationPercentage là tên trường của autoscaling/v1 và cũng là tên values mà chart thường dùng; trong manifest autoscaling/v2 trường tương ứng là metrics[].resource.target.averageUtilization như trên. Đừng chép values vào manifest như thể chúng giống nhau.
kubectl top podscó chạy không? Nếu không, kiểm tra metrics-server và APIService.kubectl get hpa: cộtTARGETScó phải<unknown>không? Nếu là<unknown>, kiểm tra theo thứ tự: metrics-server và APIService, rồi container thiếuresources.requests.cpu, rồi lỗi trongEventscủakubectl describe hpa.kubectl describe hpa: đọcConditionsvàEvents, xem có dòng nói số pod mong muốn vượtmaxReplicaskhông.- So phần trăm với request thật của pod, không so với limit.
- Kiểm tra
behaviorcó đang chặn bước scale không. - HPA đã chạm trần hoặc pod mới ở trạng thái Pending: chuyển sang chẩn đoán tầng node.
Tài liệu gốc: Horizontal Pod Autoscaling của Kubernetes.
Các cờ như chu kỳ đồng bộ hay dung sai thuộc control plane; bài này chưa đo thời gian một pod mới đạt trạng thái Ready hay một node mới sẵn sàng, nên hãy tự đo trên cluster của bạn trước khi đặt maxReplicas.
Bài tiếp theo
Cluster Autoscaler trên LKE: Pod Pending, NotTriggerScaleUp và HPA chạm maxReplicas. HPA đổi số pod; khi pod mới Pending vì hết chỗ, việc thêm node thuộc về một thành phần khác.