Một pod Laravel chạy nginx, PHP-FPM, cron và queue worker trong cùng một container. Ngay cả khi không có ai truy cập, kubectl top pod vẫn cho thấy RAM và CPU nền đáng kể. Đến lúc kiểm thử tải thì kết quả lại phụ thuộc vào việc bạn đo trong bao lâu: một bài test ngắn dễ cho cảm giác ổn, còn bài chạy một giờ ở mức cao thì xuất hiện lỗi 503. Bài này mô tả một phương pháp đo từng biến cho pm.max_children và các tham số pm.* trong pod: đo pod rảnh, chỉnh cấu hình, đổi lưu lượng thật ra request mỗi phút, rồi mới chọn request và limit.
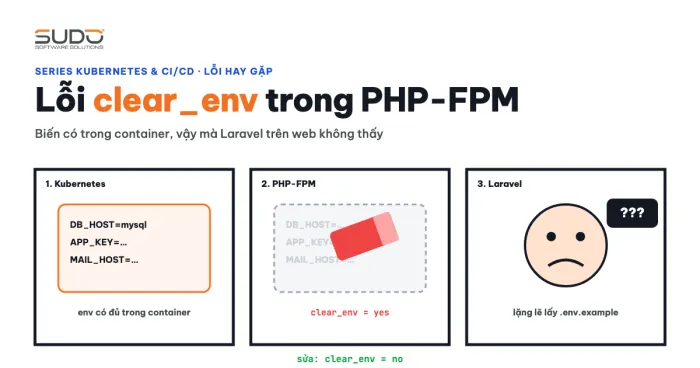
Bài này không bàn công thức tính tĩnh limit từ cấu hình PHP; nó tập trung vào quy trình đo và các chỗ dễ kết luận sai. Về cách PHP-FPM nạp biến môi trường và www.conf, xem lỗi clear_env của PHP-FPM.
Triệu chứng: pod rảnh vẫn tốn tài nguyên vì pm.max_children và start_servers
Dấu hiệu thường gặp là pod chưa nhận request nào nhưng kubectl top pod vẫn hiển thị RAM hàng trăm MiB và CPU nền khác không. Vào trong container xem danh sách tiến trình, bạn thấy nhiều tiến trình php-fpm: pool www cùng lúc. Con số đó đến từ cấu hình, không phải từ PHP, và pm.max_children chỉ là trần chứ không phải số worker đang chạy: image thường dựng sẵn file www.conf (nhiều image đặt pm = dynamic) cùng các giá trị pm.start_servers, pm.min_spare_servers do người làm image chọn. Đừng khẳng định "PHP-FPM mặc định mở nhiều worker"; hãy kiểm tra cấu hình thực sự có hiệu lực.
PHP-FPM trong container all-in-one và cách đọc bộ nhớ
Trong image all-in-one, supervisord khởi động nginx, một master php-fpm và nhiều worker, cộng với queue:work và cron. Khi chạy top bằng busybox (image Alpine), cột bộ nhớ là VSZ, tức bộ nhớ ảo đã cấp, không phải bộ nhớ thật. Một worker ghi 238m ở VSZ vẫn có thể chỉ dùng vài chục MiB thật. Con số nên so với limit là working set của cgroup, cũng chính là số kubectl top pod hiển thị. Để xem từng tiến trình, đọc VmRSS:
kubectl -n site-a exec deploy/app -- sh -c \
  'for p in $(pgrep php-fpm); do grep -H VmRSS /proc/$p/status; done'

kubectl -n site-a top pod --containers
Lưu ý các worker chia sẻ trang bộ nhớ (opcache, thư viện), nên cộng RSS của mọi worker sẽ lớn hơn thực tế. Dùng tổng của cgroup làm chuẩn, và RSS từng worker chỉ để ước lượng mức dùng mỗi worker.
Chỉnh pm.max_children và kiểm tra cấu hình hiệu lực
Với site lưu lượng vừa, hạ pm.max_children và số worker dựng sẵn là cách đầu tiên để giảm mức dùng khi rảnh. Ví dụ cấu hình thử:
pm = dynamic
pm.max_children = 20
pm.start_servers = 2
pm.min_spare_servers = 1
pm.max_spare_servers = 3
Ý nghĩa: pm.max_children bằng 20 là tối đa 20 worker, lúc khởi động có 2, luôn giữ từ 1 đến 3 worker nhàn rỗi. Tên binary phụ thuộc phiên bản (ví dụ php-fpm82 trên Alpine). Kiểm tra cấu hình thực sự được nạp, tức đã gộp mọi file include, bằng -tt:
kubectl -n site-a exec deploy/app -- php-fpm82 -tt 2>&1 | grep -E "pm(\.[a-z_]+)? *="Mỗi dòng đầu ra có tiền tố thời gian và NOTICE:, nên mẫu grep không neo ở đầu dòng.
Lệnh -tt in ra cấu hình sau khi xử lý và thoát, nên không ảnh hưởng tiến trình đang chạy.
Có hai lưu ý với pm.max_children nói riêng và pm.* nói chung. Thứ nhất, sửa www.conf bằng kubectl exec chỉ tồn tại tới lần restart kế tiếp: hãy đưa file vào image hoặc mount từ ConfigMap. Thứ hai, so sánh trước và sau phải cùng điều kiện: chỉ so pod rảnh với pod rảnh, và ghi giá trị làm tròn. Trong một lần thử nghiệm điển hình, RAM và CPU nền khi rảnh giảm rõ rệt sau khi hạ số worker, nhưng đừng đem con số đó so với pod đang chịu tải.
Đổi lưu lượng thật ra request mỗi phút
Muốn chọn pm.max_children hợp lý thì phải biết tải thật, vì giá trị này chỉ có nghĩa khi gắn với mức request đồng thời. Yêu cầu thường được phát biểu theo lượt truy cập mỗi phút, còn công cụ như JMeter, Locust hay k6 cần số request mỗi phút. Một lượt xem trang kéo theo nhiều request (HTML, API, ảnh), nhưng riêng PHP-FPM chỉ xử lý request động. Hãy đếm từ log nginx, nhóm theo phút, loại file tĩnh, rồi lấy mức bình thường và mức đỉnh. Quy trình nên là: chọn vài mức (nhẹ, vừa, nặng) và chọn trang đại diện (trang chủ, danh mục, chi tiết). Chạy từng mức riêng, ghi tỉ lệ lỗi theo phần trăm cùng CPU và RAM cao nhất.
Vì sao stress test ngắn dễ bỏ sót vấn đề
Một lần chạy vài phút trên mỗi trang đủ để dò sơ mức tài nguyên và giá trị pm.max_children ban đầu. Nó có thể kém tin cậy vì ba lý do, và cả ba chưa được kiểm chứng trong ví dụ này: cache còn ấm nên truy vấn lặp lại rất rẻ; số worker dynamic chưa kịp "tăng rồi giảm" nhiều chu kỳ; các tác vụ nền như queue, cron chưa kịp chồng lên. Trong một lần thử nghiệm điển hình, cùng một cấu hình hạ request thấp:
- Mức cao trong một giờ: xuất hiện lỗi 503, thời gian tải trang rất chậm, log có cảnh báo của PHP-FPM.
- Mức vừa trong một giờ: không có lỗi.
- Cùng mức vừa trong 24 giờ: tỉ lệ lỗi rất thấp nhưng không phải bằng không.
Đây là một điều đáng nói về phương pháp: mức tải cao chạy đủ lâu mới lộ lỗi. Dữ liệu này không chứng minh test ngắn cho kết luận sai, cũng không chứng minh 24 giờ lộ thêm điều gì so với một giờ. Hãy cứ nhìn nó như hướng dẫn: kết luận chỉ đáng tin ở độ dài bằng mức dùng thật của site.
Đọc log và số đo để tìm nguyên nhân
Khi test lỗi, thu thập đủ ba nguồn: log PHP-FPM, mức dùng pod, và throttling CPU.
# 1. Cảnh báo của PHP-FPM
kubectl -n site-a logs deploy/app | grep "seems busy"
# WARNING: [pool www] seems busy (you may need to increase
# pm.start_servers, or pm.min/max_spare_servers), spawning 16 children,
# there are 0 idle, and 18 total children

# 2. Mức dùng thực
kubectl -n site-a top pod --containers

# 3. Throttling CPU (Prometheus)
# rate(container_cpu_cfs_throttled_periods_total[5m])
#   / rate(container_cpu_cfs_periods_total[5m])
Thông báo "seems busy" cho biết tại thời điểm đó không còn worker rảnh và PHP-FPM đang sinh thêm. Nhưng trong ví dụ trên chỉ có 18 worker, chưa chạm trần pm.max_children = 20. Vì vậy chưa thể kết luận 503 do pm.max_children hay các tham số pm.* khác. Có ít nhất ba giả thuyết: pm.max_children hoặc nhóm spare quá nhỏ cho mức tải, CPU bị throttle do limit thấp nên mỗi request chậm đi, hoặc chính code PHP chậm. Ví dụ này chưa có số đo throttling, nên cả ba còn mở. Hãy kiểm chứng bằng cách đổi từng biến một và chạy lại cùng mức tải.
Cũng cần phân biệt 503 với các mã khác. Khi FPM không còn worker, nginx trong pod thường trả 502 hoặc 504. 503 từ ingress xuất hiện khi Service không còn endpoint sẵn sàng, ví dụ readiness probe gọi vào cùng pool đang kẹt nên thất bại. Hãy tách đường dẫn probe nhẹ như trong bài Health endpoint cho Laravel trên Kubernetes: kiểm tra gì và chọn probe.
Request và limit: đừng đặt request thấp hơn mức dùng thật
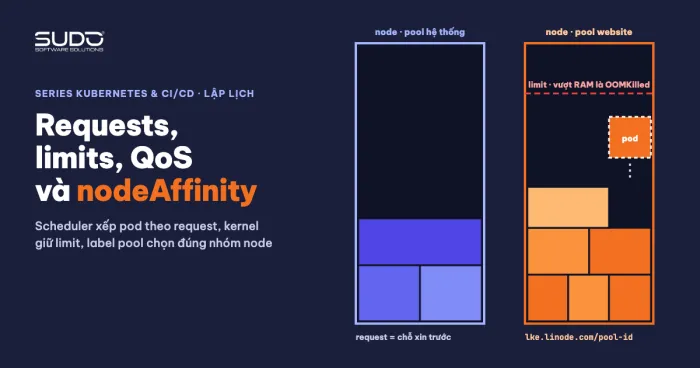
Nguyên tắc chung của request là phần tài nguyên scheduler đảm bảo, limit là trần. Cơ chế được giải thích trong Requests và limits, QoS và nodeAffinity: xếp pod lên đúng node. Bẫy cần tránh là hạ request sát mức rảnh (ví dụ 100m CPU) trong khi mức dùng thường ngày cao hơn nhiều. Với HPA theo averageUtilization của CPU, phần trăm được tính theo request, nên pod gần như luôn vượt ngưỡng và HPA tăng replica liên tục. Hãy chọn request gần mức dùng ở tải bình thường (không phải lúc rảnh), và limit đủ cho đỉnh.
Cũng đừng suy pm.max_children chỉ từ CPU: mỗi worker cần RAM, nên tích số worker và RSS phải nằm trong limit bộ nhớ. Limit quá thấp, cả CPU lẫn bộ nhớ, từng làm site dễ treo khi traffic cao: CPU thấp gây throttling làm request chậm, bộ nhớ thấp khiến tiến trình bị OOM kill. Kiểm tra bằng kubectl describe pod (Last State: OOMKilled) và metric throttling.
resources:
  requests:
    cpu: 300m        # mức dùng ở tải thường, không phải lúc rảnh
    memory: 400Mi
  limits:
    cpu: "1"
    memory: 1Gi
Các số trên chỉ là ví dụ minh hoạ, không phải giá trị khuyến nghị cho mọi site. Với giả định mỗi worker dùng khoảng 40 đến 60MiB RSS, 20 worker tối đa tốn khoảng 0,8 đến 1,2GiB, nên limit 1Gi là sát; hãy đo RSS thật rồi chọn.
Giới hạn của phương pháp chọn pm.max_children
- Đo từng biến một: đổi
pm.max_childrenthì giữ nguyênlimit, và ngược lại. - Mỗi lần đổi
pm.max_children, đo lại RSS của worker để tích số vẫn nằm trong limit bộ nhớ. - Ghi tỉ lệ lỗi theo phần trăm cho mỗi lần chạy, kèm độ dài lần chạy.
- RAM nền của pod gồm cả FPM lẫn queue worker; phần của từng thành phần cần được tách riêng khi đo.
- Cấu hình cuối (
pm.max_children,request,limit) cần được chốt sau khi đo, và mức truy cập chuẩn phải xác định trước.
Tham số pm.* được mô tả đầy đủ trong tài liệu cấu hình PHP-FPM. Về cách đặt tài nguyên cho container, xem tài liệu quản lý tài nguyên của Kubernetes. Cách đóng gói Laravel vào một image dùng chung có trong Docker hoá Laravel: một image all-in-one cho Website AI.
Checklist
- Đo pod rảnh trước, bằng working set và
VmRSS, không dùng VSZ. - Kiểm tra
pm.max_childrenhiệu lực bằngphp-fpm -tt; đưawww.confvào image hoặc ConfigMap. - Đổi lưu lượng thật ra request mỗi phút từ log nginx.
- Chạy ít nhất một mức tải trong thời gian dài; ghi tỉ lệ lỗi theo phần trăm.
- Đọc log "seems busy",
kubectl topvà throttling trước khi đổ lỗi chopm.max_children. - Ghi lại giá trị
pm.max_childrenhiệu lực cùng mức tải và độ dài của mỗi lần chạy. requesttheo mức tải thường, đặc biệt khi HPA tính theo CPU.
Bài tiếp theo
Lỗi 503 khi Service không có Endpoints: checklist chẩn đoán trên Kubernetes. Khi 503 xuất hiện, bài sau đi theo từng lớp Ingress, Service, Endpoints, pod và node để tìm ra nguyên nhân.