Trang web trả 503 từ ingress-nginx, nhưng kubectl get pod vẫn hiện Running, CPU và RAM trên Grafana đều thấp. Phản xạ thường gặp là nghi pod hết bộ nhớ và bị kill. Thực ra nguyên nhân phổ biến nhất của 503 do ingress-nginx tự sinh là Service không có Endpoints sẵn sàng để nhận request. Nguyên nhân có thể ở bất kỳ lớp nào từ Service, pod đến node, và OOM chỉ là một trong số đó. Bài này là checklist chẩn đoán theo lớp: Ingress, Service, Endpoints, pod, node, kèm lệnh kiểm tra và những tình huống dễ nhầm với 503.
Các bài trước trong series đã đi sâu từng nhánh: Health endpoint cho Laravel trên Kubernetes: kiểm tra gì và chọn probe, Pod Pending vì Insufficient cpu: tính chỗ trống thật từ kubectl describe node và Node đầy RAM: web chậm dù CPU thấp, overcommit limit và node NotReady. Bài này nối chúng lại thành một quy trình, nên không lặp lại chi tiết.
503 của ingress-nginx thường nghĩa là Service không có Endpoints
Request đi theo chuỗi: client, ingress-nginx, Service, Endpoints, pod. Với mỗi Service có selector, Kubernetes duy trì một đối tượng Endpoints (hiện nay là EndpointSlice) liệt kê địa chỉ của các pod khớp selector và đang Ready. ingress-nginx đọc danh sách đó. Danh sách rỗng thì ingress-nginx không có chỗ để chuyển request và trả 503 Service Temporarily Unavailable. Vì vậy câu hỏi đầu tiên không phải "pod có chạy không" mà là "Service có Endpoints không":
kubectl -n site-a get svc
kubectl -n site-a get endpointslices
# ENDPOINTS là <none> hoặc trống: Service không có địa chỉ Ready,
# ingress-nginx trả 503
Nếu Endpoints có địa chỉ mà vẫn 503, hãy nghi ba hướng khác. Một là chính ứng dụng trả 503, ví dụ Laravel đang ở chế độ bảo trì (php artisan down): gọi thẳng vào pod bằng kubectl exec hoặc port-forward để xem. Hai là giới hạn tốc độ của ingress-nginx (annotation limit-req, mặc định trả 503). Ba là trang lỗi tuỳ biến. Trang do ingress-nginx tự sinh có thân "503 Service Temporarily Unavailable", khác trang do ứng dụng trả; log của controller ingress-nginx cho biết upstream nào đã trả mã nào. Với timeout, 502 và 504, đọc Lỗi 413 và 504 trên Kubernetes: giới hạn body, timeout và header ở nhiều lớp.
Lớp Ingress và Service: sai tên, sai port, selector lệch nên Endpoints rỗng
Trước hết xem kubectl describe ingress: backend phải trỏ đúng tên Service và port đang tồn tại, và ingressClassName phải khớp controller. Backend không tồn tại thì ingress-nginx không có upstream nào và trả 503 (hoặc 404 khi không có Ingress nào khớp host).
Selector lệch là nguyên nhân thuần tuý nhất khiến Endpoints rỗng trong khi pod hoàn toàn khoẻ. Service chỉ chọn pod có đủ mọi nhãn trong spec.selector. Một chart Helm hay thêm nhãn vào selector của Service, ví dụ app: site-a-deployment, nhưng template của pod lại không có nhãn đó. Kết quả: Service không chọn được pod nào.
kubectl -n site-a describe svc site-a-svc | grep -E "Selector|Endpoints"
# Selector:   app.kubernetes.io/instance=site-a,app.kubernetes.io/name=web,app=site-a-deployment
# Endpoints:  <none>

kubectl -n site-a get pod --show-labels
# chỉ thấy app.kubernetes.io/instance=site-a,app.kubernetes.io/name=web
Cách sửa phụ thuộc vào đối tượng nào cần thay đổi. Nếu muốn giữ nhãn thừa, thêm nó vào spec.template.metadata.labels của Deployment, và nhớ rằng spec.selector.matchLabels của Deployment phải khớp với nhãn của template. spec.selector của Deployment là bất biến sau khi tạo (apps/v1), nên nếu cần đổi selector của Deployment thì phải xoá và tạo lại. Cách còn lại, thường đơn giản hơn, là bỏ nhãn thừa khỏi selector của Service. Sau khi sửa, Endpoints sẽ có địa chỉ gần như ngay lập tức.
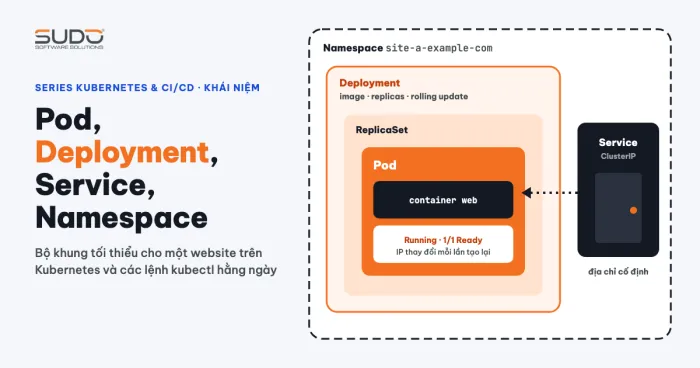
Nguyên tắc chung: selector của Service là tập con của nhãn pod, không phải ngược lại. Về quan hệ Service, Deployment và pod, xem Pod, Deployment, Service và Namespace: dùng Kubernetes thế nào.
Lớp pod: Running nhưng không Ready
Pod Running chưa chắc đã vào Endpoints. Chỉ khi pod Ready (readiness probe thành công) thì địa chỉ mới được thêm vào. Nếu probe thất bại liên tục, pod bị gỡ khỏi Endpoints và người dùng thấy 503, dù container vẫn sống.
kubectl -n site-a get pod
# NAME        READY   STATUS
# app-xxxxx   0/1     Running

kubectl -n site-a describe pod app-xxxxx | grep -A3 "Readiness"
# Warning  Unhealthy  Readiness probe failed: Get "http://10.0.0.5:80/":
#   context deadline exceeded (Client.Timeout exceeded while awaiting headers)
Nguyên nhân thường gặp là timeoutSeconds quá ngắn (mặc định 1 giây) trong khi probe gọi vào trang chủ đầy đủ. Tăng timeout chỉ là nửa giải pháp. Đúng hơn là trỏ probe vào một đường dẫn nhẹ, riêng, trả lời nhanh nhưng vẫn phản ánh khả năng nhận request:
readinessProbe:
  httpGet:
    path: /healthz   # ví dụ; Laravel 11+ có sẵn /up
    port: 80
  initialDelaySeconds: 10
  periodSeconds: 5
  timeoutSeconds: 3
  failureThreshold: 5
Đường dẫn probe cần được gõ chính xác trong cả route lẫn manifest, vì một lỗi chính tả ở một bên sẽ khiến mọi lần probe nhận 404 và pod không bao giờ Ready. Nên kiểm tra gì trong đường dẫn này được nói chi tiết ở bài health endpoint.
Lớp pod: Pending khiến Endpoints trống gián tiếp
Pod Pending không bao giờ vào Endpoints, nên với site một replica thì 503 xuất hiện ngay. Pending không tự gây 503, nó chỉ làm Endpoints trống. Đọc phần Events của describe pod để biết lý do:
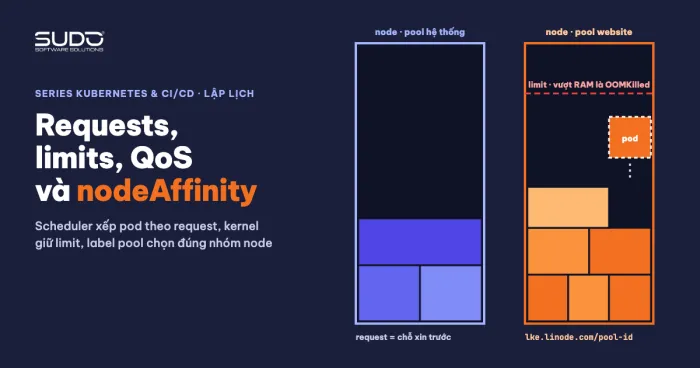
FailedSchedulingvớiInsufficient cpuhoặcInsufficient memory: không node nào đủ chỗ theorequest. Cách tính chỗ trống nằm trong bài Pending ở trên; xem thêm Requests và limits, QoS và nodeAffinity: xếp pod lên đúng node.FailedAttachVolumehoặcMulti-Attach error: volumeReadWriteOnceđang gắn vào node khác. Xem Pod kẹt ContainerCreating trên LKE: Multi-Attach và Unable to find device path.NotTriggerScaleUptừ cluster-autoscaler: autoscaler xét và quyết định thêm node cũng không giúp được pod này.
Cũng có trường hợp pod đã Scheduled nhưng không có thêm event nào từ kubelet trong một thời gian dài. Pha này gồm cả việc kéo image và chuẩn bị volume. Danh sách dưới đây chỉ là checklist chẩn đoán, không phải nguyên nhân đã xác nhận: kéo image có chậm không (kubectl describe node cho thấy trạng thái node), registry có giới hạn kéo không, và kubelet trên node có phản hồi không. Nếu mọi thứ bình thường, chờ rồi thử lại.
Lớp node: Running nhưng node NotReady
Một dạng khó hiểu là pod vẫn báo Running, Grafana vẫn xanh, nhưng describe pod có event NodeNotReady từ node-controller. Khi node mất kết nối với control plane, node-controller đánh dấu các pod trên node không còn Ready và gỡ chúng khỏi Endpoints. Với site một replica, đó là 503. Node thường NotReady khi quá tải bộ nhớ hoặc đang trong lúc cluster thêm bớt node. Với trường hợp đang scale node, đây mới là suy đoán; hãy kiểm tra bằng kubectl get nodes và kubectl describe node (Conditions, Events) thay vì kết luận từ một event duy nhất. Chi tiết về node đầy RAM nằm trong bài node ở trên.
Ba tình huống dễ nhầm với 503
Pod kẹt Terminating
Pod ở trạng thái Terminating lâu bất thường không gây 503 vì pod đang tắt đã bị gỡ khỏi Endpoints. Nó chỉ là rác chưa dọn. Trước khi xoá cưỡng bức, kiểm tra finalizers của pod, trạng thái node chứa pod và kubelet. Lệnh kubectl delete pod --grace-period=0 --force chỉ xoá object khỏi API server, không bảo đảm container đã dừng. Kubectl cảnh báo rõ rằng tài nguyên có thể tiếp tục chạy vô thời hạn. Hậu quả có thể là hai pod cùng danh tính cùng ghi vào một volume ReadWriteOnce hay NFS. Đừng nhầm trường hợp này với PVC kẹt Terminating, vốn là cơ chế finalizer khác, đã nói trong PVC trên node Kubernetes: tìm mount CSI, đo dung lượng và gỡ PVC kẹt Terminating.
Admission webhook từ chối Ingress
Khi kubectl apply một Ingress mà host và path đã được dùng ở Ingress khác (kể cả namespace khác), webhook của ingress-nginx từ chối:
Error from server (BadRequest): error when creating "ingress.yaml":
admission webhook "validate.nginx.ingress.kubernetes.io"
denied the request: host "app.example.com" and path "/" is already defined in ingress other-ns/other-ingress
Đây là lỗi lúc apply, không phải 503 lúc chạy. Cách xử lý là tìm Ingress đang giữ cặp host và path đó (kubectl get ingress -A), rồi đổi host hoặc path, hoặc gộp về một Ingress. Không nên tắt webhook cho tiện. Lưu ý thêm: nếu apply cả thư mục, các object trước hoặc sau đó có thể vẫn được tạo (ví dụ một Secret), vì kubectl xử lý từng object.
Pod Scheduled mà không có event
Như ở phần Pending, pod đã gán node nhưng chưa có gì từ kubelet. Hãy coi đây là tín hiệu chờ và kiểm tra node, chứ chưa vội xoá pod.
Bảng lệnh theo thứ tự
| Bước | Lệnh | Nếu bất thường |
|---|---|---|
| 1 | kubectl describe ingress | Backend sai tên Service hoặc port, sai ingressClassName: sửa Ingress |
| 2 | kubectl get svc,endpointslices -n NS | Endpoints rỗng: sang bước 3 |
| 3 | kubectl describe svc và get pod --show-labels | Selector lệch nhãn: sửa Service hoặc template |
| 4 | kubectl get pod cột READY | 0/1 Running: xem readiness probe |
| 5 | kubectl describe pod phần Events | Pending: xem FailedScheduling, volume |
| 6 | kubectl get nodes, describe node | NotReady: xem bài node |
Ngoài bảng: khi kubectl apply bị webhook từ chối vì trùng host và path, dùng kubectl get ingress -A để tìm Ingress đang giữ cặp đó. Lệnh kubectl get endpoints bị đánh dấu deprecated từ Kubernetes 1.33, nên bài ưu tiên endpointslices.
Giảm rủi ro trước khi có sự cố
- Chạy từ hai replica trở lên cho site quan trọng để một pod lỗi không làm Endpoints trống.
- Dùng readiness probe với đường dẫn nhẹ, riêng; đặt
timeoutSecondshợp lý. - Thêm
PodDisruptionBudgetđể thao tác drain node không rút hết pod một lúc. PDB chỉ áp dụng với disruption tự nguyện; để chịu được node NotReady cần trải replica trên nhiều node bằngtopologySpreadConstraintshoặcpodAntiAffinity. - Kiểm tra Endpoints ngay sau mỗi lần Helm upgrade, nhất là khi sửa nhãn hoặc selector.
Để hiểu sâu hơn về Endpoints và EndpointSlice, đọc tài liệu Service của Kubernetes. Cấu hình probe được mô tả ở trang cấu hình liveness, readiness và startup probe. Phần còn chưa chốt: nguyên nhân pod kẹt Terminating và pod Scheduled không event chưa được xác nhận, nên cả hai nên được coi là giả thuyết cho tới khi bạn tự kiểm chứng trên cluster của mình.
Bài tiếp theo
Grafana Alerting cho pod: dashboard RAM, cảnh báo và ServiceMonitor ingress-nginx. Sau khi biết 503 đến từ đâu, bài sau chỉ cách dựng dashboard và cảnh báo để phát hiện sớm hơn.