Nếu cluster có Prometheus và Grafana nhưng chưa có quy tắc cảnh báo theo pod, bạn thường chỉ biết pod sắp hết RAM khi site đã trả 503. Tài liệu này đi qua ba bước để đóng khoảng trống đó: viết PromQL đọc đúng metric của pod, dựng dashboard đặt mức dùng cạnh requests và limits, rồi biến phép tính "RAM theo phần trăm limit" thành quy tắc cảnh báo của Grafana Alerting, tính năng cảnh báo có sẵn trong Grafana. Cuối bài là một lỗi hay gặp khi theo dõi ingress-nginx: Prometheus không nhặt ServiceMonitor dù đã bật metrics.
Bài này giả định stack đã cài sẵn; Grafana Alerting được bật mặc định ở các bản Grafana hiện nay. Nếu chưa, xem Giám sát Kubernetes với kube-prometheus và Grafana trước.
Vì sao dashboard cần đặt usage cạnh requests và limits
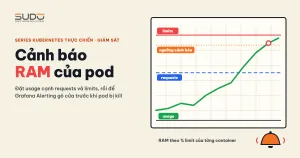
Một con số RAM đứng riêng không nói được gì. Pod dùng 600Mi là rộng rãi hay sắp chết? Câu trả lời nằm ở hai giá trị khai trong manifest: requests (mức scheduler dùng để xếp pod) và limits (với RAM là trần, vượt thì container bị OOM-kill; với CPU, vượt thì bị throttle chứ không bị kill). Vì vậy một panel RAM hữu ích có ba đường: usage thật, requests và limits; khoảng cách giữa usage và limits là biên an toàn. Cách chọn hai giá trị này nằm ở bài Requests và limits, QoS và nodeAffinity.
PromQL đọc metric pod và bẫy range vector
Bốn dạng truy vấn đủ dùng cho phần lớn dashboard:
- Lọc theo nhãn:
kube_pod_info{namespace="site-a"} - Gộp:
sum(metric), vàsum by (pod) (metric)để chia theo pod - Lấy một khoảng thời gian:
metric[5m], gọi là range vector - Tốc độ tăng của counter:
rate(metric[5m])hoặcirate(metric[5m])
Bẫy nằm ở dạng thứ ba. metric[5m] trả về một dải mẫu, và các hàm gộp như sum chỉ nhận instant vector, nên sum(metric[5m]) báo lỗi kiểu. Một cách "chữa" hay gặp là thêm offset 5m, nhưng offset không đổi kiểu dữ liệu: metric[5m] offset 5m vẫn là range vector nên sum vẫn lỗi; còn metric offset 5m là instant vector nhưng chỉ là giá trị của 5 phút trước, không phải thống kê trên cả khoảng. Muốn gộp theo thời gian, dùng hàm *_over_time:
sum by (pod) (
  avg_over_time(container_memory_working_set_bytes{container!="", image!=""}[5m])
)

# đỉnh trong 5 phút
sum by (pod) (
  max_over_time(container_memory_working_set_bytes{container!="", image!=""}[5m])
)
Về irate và rate: irate bám sát từng nhịp, hợp để vẽ đồ thị; rate mượt hơn, hợp cho Grafana Alerting vì không báo nhầm vì một cú giật ngắn.
Nguồn metric đúng cho pod
Node exporter đo máy chủ (node), không có metric theo pod hay container. Với pod, bạn cần hai nguồn:
- cAdvisor (qua kubelet, đường dẫn
/metrics/cadvisor): usage thật nhưcontainer_memory_working_set_bytesvàcontainer_cpu_usage_seconds_total. - kube-state-metrics: giá trị khai trong spec, như
kube_pod_container_resource_requestsvàkube_pod_container_resource_limits, kèm nhãnresource="memory"hoặc"cpu".
Với RAM trong dashboard và Grafana Alerting, chọn working_set thay vì usage_bytes: working set là usage trừ phần inactive file cache; đây là con số kubelet dùng khi eviction và là chỉ báo sát nhất cho nguy cơ OOM-kill. Điều kiện container!="" loại series tổng hợp của cả pod.
Dựng dashboard cho một pod
Trong Grafana, tạo dashboard mới với hai thành phần.
Biến chọn pod
Vào Dashboard settings, Variables, thêm biến pod kiểu Query, nguồn Prometheus, câu truy vấn label_values(kube_pod_info{namespace="site-a"}, pod). Mọi panel sau đó dùng $pod, đổi pod chỉ cần chọn lại ở hộp thả xuống.
Panel RAM ba query và gauge CPU
Panel Time series với ba query, đặt legend là usage, requests, limits:
sum(container_memory_working_set_bytes{pod="$pod", container!="", image!=""})
sum(kube_pod_container_resource_requests{pod="$pod", resource="memory"})
sum(kube_pod_container_resource_limits{pod="$pod", resource="memory"})
Gauge CPU tính phần trăm usage so với limit. Kube-prometheus-stack có sẵn recording rule cho phần usage, nhưng tên rule thay đổi theo phiên bản chart (có bản kết thúc bằng sum_irate, bản khác sum_rate), nên hãy tra trong Explore trước khi chép:
100 *
sum(node_namespace_pod_container:container_cpu_usage_seconds_total:sum_irate{namespace="site-a", pod="$pod"})
/
sum(kube_pod_container_resource_limits{namespace="site-a", pod="$pod", resource="cpu"})
Từ panel sang alert rule trong Grafana Alerting
Dashboard chỉ có ích khi có người nhìn, còn Grafana Alerting thì tự gõ cửa. Công thức RAM theo phần trăm limit nên ghép theo từng container:
100 *
sum by (namespace, pod, container) (
  container_memory_working_set_bytes{container!="", image!=""}
)
/
sum by (namespace, pod, container) (
  kube_pod_container_resource_limits{resource="memory"}
)
Cách ghép by (namespace, pod, container) quan trọng. Một công thức hay thấy là lấy tổng working set rồi chia cho max của limit: nó chỉ đúng khi deployment có đúng một replica. Với nhiều replica, tử số cộng mọi pod còn mẫu số chỉ là limit của một pod, nên kết quả vọt lên và báo nhầm. Ghép theo nhãn thì mỗi pod được so với đúng limit của nó và mỗi pod là một alert instance riêng.
Khi tạo rule trong Grafana Alerting (menu Alerting, Alert rules, New alert rule):
- Query A là công thức trên. Thêm expression Reduce (Last) nếu query trả về chuỗi thời gian, rồi expression Threshold, ví dụ "IS ABOVE 85", và đặt Threshold làm điều kiện cảnh báo.
- Chọn folder và evaluation group (chu kỳ đánh giá).
- Pending period: thời gian điều kiện phải đúng liên tục trước khi rule chuyển sang cảnh báo, ví dụ 5 phút. Không đặt thì chỉ cần một lần đánh giá chạm ngưỡng là báo ngay.
- Gắn nhãn để định tuyến, ví dụ
severity=warning.
Mỗi alert instance của Grafana Alerting đi qua các trạng thái Normal, Pending, Alerting (thường gọi là firing), cộng hai trạng thái do hệ thống đo: NoData khi query không trả về series nào, và Error khi query lỗi. Cần lưu ý trường hợp thiếu limit: container không khai limits.memory thì không có series ở mẫu số, nên bị loại khỏi kết quả phép chia mà không báo gì. NoData chỉ xảy ra khi cả truy vấn rỗng, tức là không container nào trong phạm vi lọc có limit. Vì vậy container thiếu limit sẽ im lặng thoát khỏi rule: không có alert instance, cũng không có NoData. Hãy thêm một rule Grafana Alerting hoặc panel riêng để đếm chúng:
count by (namespace, pod, container) (
  container_memory_working_set_bytes{container!="", image!=""}
)
unless on (namespace, pod, container)
kube_pod_container_resource_limits{resource="memory"}
Kết quả khác rỗng nghĩa là còn container chưa khai limit.
Contact point và notification policy của Grafana Alerting
Rule chỉ quyết định khi nào cảnh báo. Trong Grafana Alerting, nơi gửi do hai thứ khác quyết định:
- Contact point: đích nhận, ví dụ webhook tới một công cụ chat. Dùng nút Test để gửi thử một thông báo mẫu.
- Notification policy: cây định tuyến theo nhãn. Thêm một nested policy với matcher
severity = warningvà nhớ chọn contact point trong chính policy đó. Bỏ sót bước này, cảnh báo rơi về policy gốc và có thể không tới đúng kênh.
Để thử, hạ ngưỡng thấp (ví dụ 20) tới khi tin nhắn tới nơi, rồi đặt lại ngưỡng thật. Cảnh báo tạo bằng Grafana Alerting là cảnh báo do Grafana quản lý (Grafana-managed alert), theo mặc định không đi qua Alertmanager của kube-prometheus-stack (trừ khi bạn cấu hình Grafana chuyển tiếp sang Alertmanager ngoài). Hai hệ thống có cây định tuyến riêng, đừng cấu hình nhầm bên này mà chờ kết quả bên kia. Tài liệu chính thức: tài liệu Grafana Alerting.
ServiceMonitor của ingress-nginx
Muốn có dashboard và Grafana Alerting cho ingress-nginx, bật metrics trong values của chart:
controller:
  metrics:
    enabled: true
    serviceMonitor:
      enabled: true
      additionalLabels:
        release: kube-prometheus-stack
Sau khi thêm repo bằng helm repo add ingress-nginx <url-repo-chinh-thuc> (URL nằm trong tài liệu ingress-nginx), cài bằng helm upgrade --install ingress-nginx ingress-nginx/ingress-nginx -n ingress-nginx --create-namespace -f values.yaml.
Sau đó mở Prometheus, mục Status, Targets, và tìm target của ingress-nginx. Nếu không thấy, cơ chế như sau. Prometheus Operator chỉ nhặt ServiceMonitor khớp serviceMonitorSelector. Với kube-prometheus-stack mặc định, selector là nhãn release trùng tên release của stack. Vùng tìm namespace thì để trống, nghĩa là Prometheus nhìn mọi namespace, nên việc ingress-nginx nằm ở namespace khác không phải là điều chặn. Điều chặn là nhãn.
Metrics của ingress-nginx cũng là nguồn cho Grafana Alerting, ví dụ cảnh báo tỉ lệ 5xx. Có hai cách xử lý khi target không xuất hiện:
- Gắn nhãn khớp như ví dụ trên (đặt
additionalLabels.releaseđúng tên release). Chặt chẽ, nhưng phải nhớ cho từng ServiceMonitor. - Đặt hai cờ
prometheus.prometheusSpec.serviceMonitorSelectorNilUsesHelmValues=falsevàprometheus.prometheusSpec.podMonitorSelectorNilUsesHelmValues=false. Prometheus khi đó nhặt mọi ServiceMonitor và PodMonitor trong cluster. Tiện, nhưng mất ranh giới: ai tạo được ServiceMonitor cũng đưa được target vào Prometheus.
Hai cờ này thuộc values của chart stack và cần helm upgrade với values đầy đủ. Sau khi target lên UP, có thể nhập dashboard cộng đồng từ grafana.com bằng ID; nếu panel trống, kiểm tra tên metric thật trong Explore. Đừng sửa Service do Helm quản lý bằng kubectl apply: lần helm upgrade kế tiếp sẽ ghi đè.
Lỗi hay gặp
- Nhiều replica báo sai: tử số cộng nhiều pod, mẫu số một limit. Ghép theo
(namespace, pod, container). - Container thiếu limit bị rule bỏ qua im lặng: dùng truy vấn
unless onở trên để liệt kê rồi khai limit; NoData chỉ báo khi cả truy vấn rỗng. - Tên pod đổi sau mỗi lần rollout: panel hoặc rule Grafana Alerting cố định tên pod sẽ trống. Dùng biến, hoặc lọc theo
namespacevàcontainer. - Mất dashboard sau
helm upgradechart giám sát: có trường hợp Grafana khởi động lại với một PVC mới và dashboard cũ biến mất. Nguyên nhân chưa được xác nhận. Giả thuyết cần kiểm: values không bật persistence, hoặc không dùng--reuse-valuesnên cấu hình về mặc định. Cách kiểm:kubectl get pvc -n monitoringvàkubectl describe podcủa Grafana, xem volume nào đang được mount. Cách phòng chắc chắn là xuất dashboard ra JSON và lưu trong Git, hoặc nạp dashboard bằng provisioning.
Checklist cho Grafana Alerting trên pod
- Dashboard một pod có biến
podvà ba đường usage, requests, limits. - Rule Grafana Alerting cho RAM ghép theo
(namespace, pod, container), có pending period. - Contact point của Grafana Alerting đã Test; policy có chọn contact point và khớp nhãn.
- Thử Grafana Alerting bằng ngưỡng thấp, rồi đặt lại ngưỡng thật.
- Mọi container đều khai
limits, nếu không container đó bị rule bỏ qua mà không báo; có truy vấnunless onđể phát hiện. - ServiceMonitor ingress-nginx hiện trong Targets; dashboard được sao lưu ra JSON.
Bài tiếp theo
Bảng tạm MySQL ăn hết đĩa: lỗi 1114 và innodb_temp trong pod Kubernetes. Khi cảnh báo dung lượng volume reo, câu hỏi tiếp theo là cái gì đang ăn đĩa trong pod MySQL.