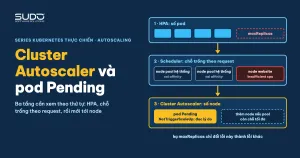
Pipeline CI/CD báo xanh, nhưng website vẫn chạy code cũ. Một lúc khác, web treo hẳn trong khi MySQL và Redis hoàn toàn khoẻ. Hai triệu chứng này nhìn rất khác nhau, nhưng trên một cluster LKE có bật autoscaling, chúng có thể có chung một gốc: không còn chỗ cho pod mới. Bài này đưa ra thứ tự chẩn đoán ba tầng: HPA đã chạm trần chưa, node pool còn chỗ theo request không, và Cluster Autoscaler vì sao không thêm node, kèm cách đọc sự kiện NotTriggerScaleUp cho đúng.
Công thức và behavior của HPA đã có ở bài HPA cho Laravel: ngưỡng theo request, behavior scale và metrics-server; cách tính chỗ trống thật của node có ở bài Pod Pending vì Insufficient cpu. Bài này nối hai việc đó lại.
Hai triệu chứng đánh lừa
- Pipeline xanh nhưng code cũ. Image mới đã được build và đẩy lên registry, nhưng trong namespace của site có một pod mới ở trạng thái
Pendingnhiều phút, trong khi các pod cũ vẫnRunningvà phục vụ code cũ. Nếu pipeline chỉ chạyhelm upgrademà không dùng--waithoặckubectl rollout status, lệnh trả về ngay khi manifest được áp dụng, nên pipeline vẫn xanh dù pod mới chưa lên. - Web treo nhưng database khoẻ. Dashboard MySQL và Redis bình thường, không đầy đĩa, không chạm trần kết nối. Nếu HPA đã chạm
maxReplicasmà tải vẫn cao, các pod hiện có quá tải và web treo. Dấu hiệu này chỉ nên coi là gợi ý cần kiểm tra, không phải kết luận.
Quy tắc rút ra: đừng nghi database hay Redis trước khi chạy kubectl get hpa.
HPA và Cluster Autoscaler: ai đổi số pod, ai đổi số node
Cluster Autoscaler và HPA hay bị nhầm vì cùng gọi là autoscaling:
| Tiêu chí | HPA | Cluster Autoscaler |
|---|---|---|
| Đổi cái gì | Số pod (replicas) | Số node trong pool |
| Dựa vào | Mức dùng so với request (hoặc metric khác) | Pod Pending không xếp được, và node dư |
| Cấu hình ở đâu | Đối tượng HPA, spec.behavior | Cấu hình pool của nhà cung cấp (min, max node) |
Chuỗi bình thường: tải tăng, HPA tăng số pod, scheduler không tìm được node đủ request, pod Pending, rồi Cluster Autoscaler thấy pod Pending và thêm node, pod được xếp lên. Chỉ cần đứt một mắt xích, pod mới nằm chờ mãi. HPA tính theo request chứ không theo limit, nên cả hai tầng đều phụ thuộc vào request bạn khai báo.
Đọc pod Pending: FailedScheduling và NotTriggerScaleUp
Lệnh đầu tiên là describe pod đang Pending và đọc phần Events:
kubectl describe pod web-7d9c-xxxxx -n site-a
Events:
  Warning  FailedScheduling   default-scheduler   0/3 nodes are available:
    1 Insufficient cpu, 2 node(s) didn't match Pod's node affinity/selector.
  Normal   NotTriggerScaleUp  cluster-autoscaler  pod didn't trigger scale-up: ...
Cách đọc dòng FailedScheduling: trong ba node, hai node bị loại vì nodeAffinity không khớp (ví dụ chúng thuộc pool hệ thống, còn pod yêu cầu pool website), và node còn lại không đủ CPU request. Tức là pod chỉ có đúng một node hợp lệ, và node đó đã đầy theo request.
Một bối cảnh khiến lỗi này xuất hiện bất ngờ là rolling update. Với maxSurge mặc định, Deployment cần tạo pod mới trước khi xoá pod cũ, nên lúc cập nhật cần dư chỗ cho thêm pod. Khi các node hợp lệ chỉ còn dư ít hơn request của một pod, pod surge sẽ Pending dù HPA chưa chạm trần: maxSurge của Deployment không bị giới hạn bởi maxReplicas của HPA, chỉ bị giới hạn bởi chỗ trống theo request.
Dòng NotTriggerScaleUp thường bị cắt mất phần lý do sau dấu hai chấm khi sao chép. Đừng đoán: lấy đủ lý do bằng:
kubectl describe pod web-7d9c-xxxxx -n site-a | sed -n '/Events/,$p'
kubectl get events -n site-a --field-selector reason=NotTriggerScaleUp -o yaml
Vì sao Cluster Autoscaler không scale-up
Trong một ca thực tế, sự kiện NotTriggerScaleUp bị cắt mất phần lý do, nên các điểm dưới đây là giả thuyết cần kiểm chứng, không phải nguyên nhân đã xác nhận. Theo tài liệu upstream, Cluster Autoscaler chỉ thêm node khi có pod chưa xếp được và việc thêm một node từ pool đã biết sẽ giúp pod đó chạy được. Các lý do thường gặp khiến nó từ chối:
- Pool phù hợp với
nodeAffinityhoặcnodeSelectorcủa pod đã đạt số node tối đa. - Pod có
nodeAffinitytrỏ vào pool mà Cluster Autoscaler không được bật cho pool đó, nên thêm node ở pool khác cũng không giúp. - Request của pod lớn hơn dung lượng cấp phát được (allocatable) của loại node trong pool: thêm node mới vẫn không đủ.
- Pod bị ràng buộc theo volume, zone hoặc taint mà node mới không thoả.
- Cluster Autoscaler đang ở chế độ chờ sau một lần scale-up hoặc lỗi trước đó.
Cách kiểm chứng: đọc đủ lý do trong sự kiện, đối chiếu cấu hình pool (min, max, loại máy) và so request của pod với allocatable của một node. Nếu muốn chỉnh tham số của Cluster Autoscaler, nhà cung cấp quản lý chúng ở phía họ; đừng giả định bạn tự đổi được, hãy hỏi hoặc đọc tài liệu của nhà cung cấp. Cũng đừng gọi pool là "cố định": khi Cluster Autoscaler bật, số node vẫn thêm và bớt.
Khi HPA chạm maxReplicas
Trường hợp thứ hai không liên quan Pending. Web treo, các pod hiện có đều quá tải, và HPA không thể thêm pod vì đã chạm trần:
kubectl get hpa -n site-a
NAME     REFERENCE       TARGETS    MINPODS   MAXPODS   REPLICAS
site-a   Deployment/web  130%/80%   1         2         2

kubectl top pod -n site-a
kubectl describe hpa site-a -n site-a   # tìm dòng ScalingLimited / TooManyReplicas
Cluster Autoscaler không giúp được gì ở tình huống này, vì không có pod Pending nào để kích hoạt nó. Nếu REPLICAS bằng MAXPODS mà TARGETS vẫn cao hơn ngưỡng, web chậm là do thiếu dư địa chứ chưa chắc do database. Trong một ca thực tế, web treo trong khi MySQL và Redis bình thường, và web hoạt động lại sau khi nâng maxReplicas lên cao hơn. Ca đó không có số đo CPU đi kèm, nên hãy coi đây là dấu hiệu cần kiểm tra trên cluster của bạn chứ chưa phải kết luận.
Có một bẫy: hạ maxReplicas để pod Pending biến mất chỉ đổi lỗi này lấy lỗi khác. Hạ maxReplicas làm HPA thu bớt pod đang chạy, nên request được trả lại cho node và pod Pending xếp được; đây là cách giải thích hợp lý nhưng chưa được xác nhận trong ca gốc. Cái giá là site mất khả năng chịu tải, và sau đó web có thể treo vì chạm trần. Chuỗi "hạ maxReplicas rồi web treo" là suy luận theo thứ tự thời gian, chưa được chứng minh nhân quả, nhưng đủ để rút ra bài học: đừng dùng maxReplicas như nút chữa Pending.
Scale-down node và vì sao node chưa bị xoá
Khi pod giảm, node dư không bị xoá ngay. Cluster Autoscaler đánh dấu node bằng taint DeletionCandidateOfClusterAutoscaler với effect PreferNoSchedule, rồi chờ hết thời gian "unneeded" trước khi xoá. Mặc định upstream là 10 phút cho scale-down-unneeded-time, nên với cấu hình mặc định, node dư thường được xoá sau khoảng 10 phút kể từ khi không còn cần. Bạn có thể tự quan sát bằng cách theo dõi taint trên node sau khi hạ tải; giá trị thực tế còn tuỳ cấu hình của nhà cung cấp.
Nếu node vẫn còn sau thời gian đó, các điều kiện chặn xoá thật theo tài liệu upstream gồm:
- Pod không do controller quản lý (pod trần).
- PodDisruptionBudget không cho phép đuổi pod.
- Pod dùng local storage hoặc có annotation
cluster-autoscaler.kubernetes.io/safe-to-evict: "false". - Mức dùng của node vẫn cao hơn ngưỡng (mặc định upstream là 50% request) hoặc chưa đủ thời gian sau lần scale-up gần nhất.
Với Cluster Autoscaler, đừng đổ cho DaemonSet: pod của DaemonSet không chặn việc xoá node. Các giá trị mặc định ở trên là của upstream, chưa kiểm trên LKE.
Checklist và cấu hình khuyến nghị
kubectl get pods -n site-a: có pod Pending không? Nếu có,describevà đọc đủFailedSchedulinglẫnNotTriggerScaleUp.kubectl get hpa(tầng HPA, trước khi nghi Cluster Autoscaler):REPLICASđã bằngMAXPODSchưa,TARGETScó vượt ngưỡng không?kubectl describe node: cộng request đã cấp so với allocatable.- Kiểm tra affinity khớp bao nhiêu node và pool tương ứng còn dư địa tối đa cho Cluster Autoscaler không.
- Đặt
maxReplicascó dư địa so với tải đỉnh, và đảm bảo pool đủ node tối đa để chứa số pod đó cộng pod surge khi rolling update. - Thêm
kubectl rollout status deployment/web -n site-a --timeout=300svào pipeline để pipeline đỏ khi pod mới không lên, thay vì xanh giả. Với Helm có thể dùnghelm upgrade --atomic --wait --timeout 5m.
Khi viết cấu hình HPA, hãy phân biệt values của chart với manifest. Values của chart (như targetCPUUtilizationPercentage) chỉ là cách chart sinh ra manifest; manifest autoscaling/v2 trông như sau:
spec:
  minReplicas: 2
  maxReplicas: 5
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80
Kiến thức nền về request và affinity xem ở bài Requests và limits, QoS và nodeAffinity. Tài liệu gốc: FAQ của Cluster Autoscaler và gán pod vào node trên kubernetes.io.
Những điểm cần tự kiểm chứng
- Lý do Cluster Autoscaler không scale-up. Đừng đoán từ dòng sự kiện bị cắt: lấy đủ lý do bằng
kubectl get events --field-selector reason=NotTriggerScaleUp -o yamlrồi đối chiếu cấu hình pool. - Pod cũ vẫn Running dù chỉ có một node hợp lệ. Một giả thuyết hợp lý là các pod cũ đang chiếm request trên node hợp lệ duy nhất, nên node không còn chỗ cho pod thứ N+1. Kiểm bằng
kubectl describe node, mụcAllocated resources. - Quan hệ giữa một lần Pending và một lần web treo sau đó. Thứ tự thời gian chưa chứng minh nhân quả; hãy đối chiếu thời điểm xảy ra bằng
kubectl get eventsvà biểu đồ CPU theo request. - Giá trị
maxReplicasphù hợp. Chọn theo đo đạc tải của chính site, cộng thêm chỗ cho pod surge khi rolling update.
Bài tiếp theo
Webroot trên NFS bị treo: đo fio, ioping, iperf3 cho site PHP và khi nào nên bỏ NFS. Khi pod, database và autoscaling đều ổn mà web vẫn treo, lớp lưu trữ dùng chung là nghi phạm tiếp theo.