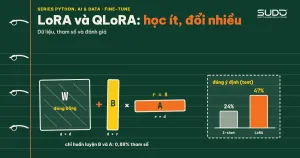
LoRA (Low-Rank Adaptation) là kỹ thuật fine-tune mô hình ngôn ngữ lớn mà không cập nhật trọng số gốc: bạn đóng băng ma trận W, chỉ học thêm hai ma trận hạng thấp B và A, và đầu ra của lớp trở thành Wx + (alpha/r)·BAx. Bài báo gốc của Hu và cộng sự (2021) báo cáo giảm khoảng 10.000 lần số tham số cần huấn luyện so với fine-tune toàn bộ GPT-3 175B, mà không thêm độ trễ suy luận.
Bài này không dừng ở lý thuyết. Chúng tôi huấn luyện thật một adapter LoRA cho mô hình Qwen/Qwen2-0.5B trên CPU Apple M4 (16 GB), với bài toán sát doanh nghiệp: biến tin nhắn khách hàng thành JSON {"intent", "order_id"}. Có baseline, ba mức rank, đo độ “quên” và gộp adapter, và mọi con số đều là output thật (mã ở code/s7-44; môi trường Python 3.12, torch==2.8.0, transformers==4.56.0, peft==0.17.0). Phần QLoRA cần GPU NVIDIA nên chúng tôi ghi rõ phần nào chưa chạy trong bài. Bài nối tiếp Fine-tune PhoBERT với Hugging Face (fine-tune toàn bộ mô hình nhỏ) và Chạy LLM local với Ollama.
Khi nào nên fine-tune LoRA
Thử các cách rẻ hơn trước: prompt có ví dụ mẫu, structured output, rồi RAG nếu thiếu kiến thức. Fine-tune hợp khi cần mô hình hành xử nhất quán (định dạng, giọng điệu, nhãn nội bộ) hoặc muốn mô hình nhỏ thay mô hình lớn. Không dùng nó để nạp kiến thức đổi hằng ngày như giá hay tồn kho.
LoRA hoạt động thế nào
Một lớp tuyến tính của Transformer có ma trận trọng số W kích thước d_out × d_in. Fine-tune toàn bộ học ΔW cùng cỡ với W. Giả thuyết của bài báo LoRA là mức thay đổi cần thiết khi thích nghi với một tác vụ có “hạng nội tại” thấp, nên có thể viết ΔW = B·A với B cỡ d_out × r, A cỡ r × d_in và r nhỏ. Số tham số của một lớp giảm từ d_out·d_in xuống r·(d_in + d_out). Khởi tạo B = 0 nên lúc đầu mô hình y hệt bản gốc; đầu ra cộng thêm được nhân hệ số alpha/r.
| Tham số LoraConfig | Ý nghĩa | Lưu ý thực hành |
|---|---|---|
r | Hạng của B·A, quyết định dung lượng học | 8–16 là điểm bắt đầu hợp lý; tăng khi mô hình học thiếu |
lora_alpha | Hệ số nhân, scale thực = alpha/r | Giữ tỉ lệ alpha/r cố định; hay gặp alpha = r hoặc 2r |
lora_dropout | Dropout trên nhánh LoRA | Có ích khi dữ liệu ít |
target_modules | Lớp nào được gắn LoRA | "all-linear" gắn mọi lớp tuyến tính (trừ lớp đầu ra), như cấu hình QLoRA |
use_rslora | Đổi scale thành alpha/√r | Ổn định hơn khi rank cao |
use_dora | Tách độ lớn và hướng của trọng số | Tốn thêm chi phí so với LoRA thuần |
Hai biến thể trong bảng có nguồn gốc rõ ràng. rsLoRA (Kalajdzievski, 2023) chứng minh adapter nên được chia cho căn bậc hai của rank thay vì chính rank, vì cách scale cũ làm việc học chậm lại khi rank lớn. DoRA (Liu và cộng sự, 2024) chỉ dùng LoRA để cập nhật phần hướng của trọng số và học riêng phần độ lớn.
Bài toán và dữ liệu cho LoRA
Dữ liệu là tin nhắn khách hàng giả lập cho 6 ý định: tra_cuu, huy_don, doi_dia_chi, xuat_hoa_don, khieu_nai, khac. Mã đơn có dạng DH-xxxx; câu “khác” không có mã đơn nên order_id là null. Điểm then chốt: tập huấn luyện và tập kiểm tra dùng các mẫu câu khác nhau. Mỗi ý định có 6 mẫu câu để học và 3 mẫu câu khác hẳn để kiểm tra, ví dụ train “Hủy đơn {o} giúp mình” còn test “Em xin rút lại {o}, không mua nữa”. Trộn cùng mẫu vào cả hai tập là rò rỉ dữ liệu (như đã nói ở bài feature engineering) và điểm số sẽ đẹp một cách vô nghĩa.
def make(split, n, seed):
    rng = random.Random(seed)
    names = list(INTENTS)
    rows = []
    for i in range(n):
        intent = names[i % len(names)]
        tpl = rng.choice(INTENTS[intent][split])      # split = "train" hoặc "test"
        oid = None if intent == "khac" else f"DH-{rng.randint(1000, 9999)}"
        text = tpl.format(o=oid) if oid else tpl
        rows.append({"text": text,
                     "target": json.dumps({"intent": intent, "order_id": oid}, ensure_ascii=False)})
    rng.shuffle(rows)
    return rows
Chúng tôi dùng 240 mẫu huấn luyện và 120 mẫu kiểm tra, nhỏ có chủ đích vì máy chỉ có CPU. Khi đọc kết quả hãy nhớ: 120 mẫu kiểm tra chỉ đến từ 18 mẫu câu, nên độ nhiễu của phép đo lớn.
Baseline: mô hình gốc làm được gì trước khi fine-tune
Không có baseline thì không biết fine-tune đáng giá bao nhiêu. Chúng tôi chạy Qwen2-0.5B gốc với hai cách: zero-shot (chỉ có “Tin nhắn: … JSON:”) và 3-shot (thêm 3 ví dụ mẫu trong prompt). Ba chỉ số: json_hop_le (parse được JSON), dung_intent và khop_hoan_toan (đúng cả intent lẫn mã đơn). Output thật của baseline.py:
zero-shot {'json_hop_le': 0.058, 'dung_intent': 0.0, 'khop_hoan_toan': 0.0} | 924s
  ví dụ: 'Gửi email cho DH-7428' | đúng: {"intent": "xuat_hoa_don", "order_id": "DH-7428"}
3-shot {'json_hop_le': 1.0, 'dung_intent': 0.242, 'khop_hoan_toan': 0.242} | 82s
  ví dụ: '{"intent": "khac", "order_id": null}' | đúng: {"intent": "xuat_hoa_don", "order_id": "DH-7428"}
general NLL (gốc): 2.821
Zero-shot gần như vô dụng (chỉ 5,8% đầu ra là JSON hợp lệ). 3-shot ép được định dạng (100% JSON hợp lệ) nhưng mô hình 0,5 tỉ tham số chọn đúng ý định chỉ 24,2%. Thời gian 924 giây của lượt zero-shot không phản ánh tốc độ mô hình: máy đang bận và mô hình sinh tới 40 token mỗi câu vì không biết dừng. Dòng cuối, general NLL, là một phép đo “độ quên” sẽ giải thích ở phần đánh giá.
Huấn luyện adapter LoRA từng bước
Cấu hình giữ nguyên mọi thứ trừ rank, nhờ vậy so sánh được: 3 epoch, batch 8, learning rate 2e-4 (mức hay dùng cho LoRA, cao hơn nhiều so với fine-tune toàn bộ), lora_dropout=0.05, alpha = 2r, gắn LoRA vào mọi lớp tuyến tính:
cfg = LoraConfig(r=r, lora_alpha=alpha, lora_dropout=0.05,
                 target_modules="all-linear", task_type="CAUSAL_LM")
model = get_peft_model(base, cfg)
trainable, total = model.get_nb_trainable_parameters()
Điểm dễ sai nhất khi fine-tune mô hình sinh văn bản là tính loss trên cái gì. Ta chỉ muốn mô hình học phần trả lời (JSON), không học lại việc “sinh” tin nhắn của khách, nên gán nhãn -100 (bị bỏ qua khi tính loss) cho phần prompt, và thêm token kết thúc eos sau JSON để mô hình biết dừng:
def encode(row):
    p = tok(PROMPT.format(text=row["text"]))["input_ids"]
    t = tok(" " + row["target"] + tok.eos_token)["input_ids"]
    return p + t, [-100] * len(p) + t          # chỉ tính loss trên phần JSON trả lời
Chạy python train_lora.py 8 cho output thật (rút gọn dòng cảnh báo):
r=8 alpha=16: trainable 4,399,104 / 498,431,872 = 0.88%
epoch 1 step 1/90 loss 3.1850
epoch 1 step 10/90 loss 0.4431
epoch 1 step 20/90 loss 0.0486
epoch 1 step 30/90 loss 0.0019
epoch 3 step 90/90 loss 0.0001
huấn luyện: 239s
test (zero-shot prompt, đã fine-tune): {'json_hop_le': 1.0, 'dung_intent': 0.467, 'khop_hoan_toan': 0.467}
kích thước adapter: 17.6 MB
Chỉ 0,88% tham số được huấn luyện và adapter nặng 17,6 MB, trong khi mô hình gốc nặng hơn 1 GB ở float32. Con số 4,399,104 kiểm chứng được bằng công thức r·(d_in + d_out): Qwen2-0.5B có 24 lớp, hidden 896, MLP 4864 và K/V chỉ rộng 128 (nhóm truy vấn), nên mỗi lớp có 8·(1792 + 1024 + 1024 + 1792) + 3·8·(896 + 4864) = 183.296 tham số, nhân 24 lớp ra đúng 4.399.104.
Đọc kết quả: rank bao nhiêu là đủ
Chúng tôi chạy lại với r = 2 và r = 32, cùng seed và dữ liệu:
| Cấu hình | Tham số huấn luyện | Đúng intent (test) | NLL câu thường | Adapter |
|---|---|---|---|---|
| Gốc, 3-shot | 0 | 24,2% | 2,821 | không có |
| LoRA r=2, alpha=4 | 1.099.776 (0,22%) | 53,3% | 2,765 | 4,4 MB |
| LoRA r=8, alpha=16 | 4.399.104 (0,88%) | 46,7% | 3,470 | 17,6 MB |
| LoRA r=32, alpha=64 | 17.596.416 (3,44%) | 55,0% | 4,000 | 70,4 MB |
Đọc thành thật, kết quả nói được ba điều và không nói được một điều. Thứ nhất, LoRA đáng giá: cả ba rank đều gần gấp đôi baseline 3-shot (24,2% lên 47–55%) và cho 100% JSON hợp lệ mà không cần ví dụ trong prompt, tức là prompt ngắn hơn.
Thứ hai, mô hình chưa đủ tốt để đưa vào sản xuất: còn khoảng một nửa số câu sai ý định. Thứ ba, loss huấn luyện về gần 0 sau 30–60 bước tuỳ rank (r=8 và r=32 sau 30 bước, r=2 chậm hơn) trong khi điểm kiểm tra chỉ 47–55%, dấu hiệu mô hình học thuộc 36 mẫu câu hơn là khái quát.
Điều không kết luận được: rank nào tốt nhất. Chênh lệch 46,7%, 53,3%, 55,0% nằm trong sai số của một phép đo trên 120 mẫu từ 18 mẫu câu và một seed (độ lệch chuẩn xấp xỉ √(0,5·0,5/120) ≈ 4,6 điểm phần trăm, còn thấp ước lượng vì các mẫu không độc lập). Muốn chọn rank phải có tập kiểm tra lớn hơn và nhiều seed.
Các lỗi còn lại chỉ ra điều thú vị. Mẫu đầu tiên mô hình trả "intent": "xuat_nai", một nhãn không tồn tại, vì mô hình sinh từng token tự do và có thể ghép sai nhãn. Với bài toán nhãn đóng, nên ép bằng ràng buộc giải mã hoặc kiểm tra bằng schema như ở bài trích xuất dữ liệu bằng LLM và Pydantic, thay vì tin hoàn toàn vào fine-tune.
Đánh giá: đo cả thứ học thêm và thứ bị quên
Đánh giá fine-tune cần ít nhất ba lớp. Lớp một là tác vụ đích trên dữ liệu chưa từng thấy, như phần trên. Lớp hai là khả năng tổng quát: mô hình có quên những gì nó biết không. Chúng tôi dùng một phép đo đơn giản và rẻ là NLL (negative log-likelihood trên mỗi token) của 5 câu tiếng Việt thông thường, càng thấp càng tốt, so trước và sau. Kết quả: gốc 2,821; r=2 là 2,765; r=8 là 3,470; r=32 là 4,000. Xu hướng gợi ý (quan sát trên 1 seed, 3 mức rank, 5 câu): rank càng lớn thì mô hình càng kém trên câu thường. Rank không phải yếu tố duy nhất, vì loss huấn luyện về gần 0 và tỉ lệ alpha/r cố định cũng làm mô hình lệch khỏi bản gốc.
Với 5 câu, đây chỉ là chỉ báo thô; bản nghiêm túc cần một tập đánh giá chung đủ lớn (kiến thức, suy luận, an toàn). Con số 2,765 thấp hơn 2,821 không có nghĩa là r=2 “giỏi hơn gốc”, nằm trong nhiễu.
Hướng này khớp với nghiên cứu “LoRA Learns Less and Forgets Less” (Biderman và cộng sự, 2024): với cấu hình rank thấp thông thường, LoRA học kém hơn fine-tune toàn bộ trên lập trình và toán, nhưng giữ năng lực ngoài miền tốt hơn. Nghĩa là LoRA là một đánh đổi chứ không phải bản rút gọn miễn phí. Lớp ba là đánh giá trên đầu ra thực: đọc tay các mẫu sai. Với văn bản sinh tự do cần thêm bộ test và LLM làm giám khảo, chủ đề của bài kế tiếp.
Gộp adapter LoRA và triển khai
Khi suy luận, adapter có thể giữ rời (đổi adapter theo khách hàng trên cùng một mô hình nền) hoặc gộp vào trọng số bằng merge_and_unload() để mô hình chạy như mô hình thường. Hàm này gộp trọng số LoRA vào mô hình nền, gỡ các lớp LoRA rồi trả về mô hình nền đã gộp, nên cần gán lại: model = model.merge_and_unload(). Kiểm tra bằng merge_check.py, output thật:
tổng tham số: 498,431,872 (adapter chưa gộp) -> 494,032,768 (đã gộp)
đầu ra giống nhau: 40/40
thời gian 40 câu: 6.0s (adapter rời) vs 5.3s (đã gộp)
khớp hoàn toàn (đã gộp): {'json_hop_le': 1.0, 'dung_intent': 0.475, 'khop_hoan_toan': 0.475}
Hiệu số hai dòng tham số của LoRA, 4.399.104, chính là số tham số adapter đã được “nuốt” vào mô hình; đầu ra giống hệt trên cả 40 câu, và mô hình đã gộp nhanh hơn một chút (5,3 giây so với 6,0 giây, trên máy đang chạy nhiều tác vụ nên chỉ nên coi là cùng cỡ). Điểm 0,475 trên 40 câu khác 0,467 trên 120 câu vì cỡ mẫu khác, thêm một ví dụ về nhiễu của phép đo.
Về bản quyền: model card của Qwen/Qwen2-0.5B trên Hugging Face ghi giấy phép Apache-2.0 tại thời điểm viết bài, nên bạn có thể dùng lại adapter, nhưng hãy kiểm tra lại model card của mô hình nền bạn chọn trước khi triển khai. Dữ liệu trong bài là dữ liệu giả lập do Sudo tự viết, không chứa dữ liệu khách hàng thật.
QLoRA: LoRA trên mô hình lượng tử hoá 4-bit
Hạn chế chính của LoRA ở mô hình lớn là bộ nhớ của trọng số gốc, vì ta vẫn phải nạp chúng. QLoRA (Dettmers và cộng sự, 2023) giải quyết bằng cách lượng tử hoá mô hình gốc xuống 4-bit, đóng băng, rồi lan truyền gradient qua nó vào các adapter LoRA. Bài báo đề xuất ba kỹ thuật: kiểu dữ liệu 4-bit NormalFloat (NF4), double quantization (lượng tử hoá cả các hằng số lượng tử hoá) và paged optimizers (xử lý các đợt tăng đột biến bộ nhớ); với chúng, một mô hình 65 tỉ tham số fine-tune được trên một GPU 48 GB. Cấu hình minh hoạ (dùng các lớp BitsAndBytesConfig, prepare_model_for_kbit_training của Transformers và PEFT) như sau:
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True,
)
model = AutoModelForCausalLM.from_pretrained(name, quantization_config=bnb_config, device_map="auto")
model = prepare_model_for_kbit_training(model)
model = get_peft_model(model, LoraConfig(r=16, lora_alpha=16, lora_dropout=0.1,
                                          target_modules="all-linear", task_type="CAUSAL_LM"))
Đoạn này cần GPU NVIDIA (thư viện bitsandbytes), chưa chạy trong bài: máy thử nghiệm của chúng tôi là Apple M4 không có GPU NVIDIA, nên chúng tôi không đưa số liệu QLoRA như thể đã đo. Thay vào đó, memory_estimate.py tính (không đo) bộ nhớ trọng số cho mô hình 7 tỉ tham số kiểu Llama và số tham số LoRA tương ứng:
Trọng số 7B (6,74 tỉ tham số):
  16-bit    :  12.6 GiB
  8-bit     :   6.3 GiB
  4-bit NF4 :   3.1 GiB
Tham số LoRA khi gắn vào cả 7 ma trận tuyến tính mỗi lớp:
  r=8  :   20.0 triệu = 0.30% | Adam fp32 (16 byte/tham số: trọng số, gradient, 2 moment) ~0.30 GiB
  r=16 :   40.0 triệu = 0.59% | Adam fp32 (16 byte/tham số: trọng số, gradient, 2 moment) ~0.60 GiB
  r=64 :  159.9 triệu = 2.37% | Adam fp32 (16 byte/tham số: trọng số, gradient, 2 moment) ~2.38 GiB
Đây là bộ nhớ của riêng trọng số và trạng thái optimizer của adapter; activation, độ dài chuỗi và batch còn cộng thêm, nên đừng coi con số trên là tổng yêu cầu GPU. Điểm cần rút ra là tỉ lệ: trọng số 4-bit chỉ khoảng một phần tư bản 16-bit, còn phần cần huấn luyện (adapter cộng optimizer) nhỏ hơn nhiều so với fine-tune toàn bộ, vốn phải giữ gradient và hai moment cho toàn bộ 6,74 tỉ tham số. Đổi lại, lượng tử hoá làm mất một chút độ chính xác, và theo tài liệu PEFT, gộp adapter vào mô hình đã lượng tử hoá sẽ lượng tử hoá lại trọng số nên không còn tách ra chính xác như ban đầu.
Chọn tham số LoRA: hướng dẫn thực dụng
- Bắt đầu từ r = 8 hoặc 16,
target_modules="all-linear". Chỉ gắn vào q và v tiết kiệm hơn nhưng thường học yếu hơn; cấu hình QLoRA gắn vào mọi lớp tuyến tính. - Đặt alpha theo tỉ lệ cố định với r (
alpha = rhoặc2r) và chỉnh learning rate trước, rồi mới chỉnh r. Nếu dùng rank lớn, thửuse_rslora=Trueđể scale không làm chậm học. - Số epoch nhỏ, theo dõi tập kiểm tra. Loss huấn luyện giảm về 0 không có nghĩa là tốt; dừng sớm khi điểm kiểm tra không tăng.
- Dữ liệu sạch, đa dạng cách diễn đạt, cân bằng nhãn đáng giá hơn nhiều mẫu lặp; ghi lại phiên bản mô hình nền, seed và cấu hình cùng adapter.
Lỗi thường gặp
- Loss tính cả trên prompt: mô hình tốn dung lượng học cách “bắt chước” câu hỏi. Dùng nhãn
-100cho phần prompt. - Quên token kết thúc: mô hình không biết dừng, sinh tiếp rác sau JSON (chúng tôi cắt ở dòng đầu khi chấm điểm, nhưng trong sản xuất phải xử lý đúng).
- Rò rỉ giữa train và test: trùng mẫu câu hoặc cùng khách hàng ở cả hai tập làm điểm số phồng lên.
- Kết luận từ tập kiểm tra nhỏ: như đã thấy, chênh lệch vài điểm phần trăm trên 120 mẫu không đủ để chọn cấu hình.
- Đưa dữ liệu cá nhân thật vào tập huấn luyện: mô hình có thể ghi nhớ và nhả lại. Ẩn danh trước, và dùng dữ liệu giả lập khi thử nghiệm như ở bài này.
Checklist Fine-tune LoRA
- Đã có baseline (prompt hoặc few-shot) để so sánh, không chỉ so với zero-shot.
- Tập kiểm tra khác mẫu câu và khác người dùng với tập huấn luyện; đủ lớn để phân biệt được cấu hình.
- Chỉ tính loss trên phần trả lời, có token kết thúc.
- Đo cả tác vụ đích và độ quên trên một tập chung.
- Đọc tay các mẫu sai; đầu ra nhãn đóng thì kiểm tra bằng schema.
- Đoạn nào cần GPU mà chưa chạy thì ghi rõ, không suy diễn số liệu.
Cài đặt (requirements.txt chỉ ghim các gói trực tiếp; mọi script giới hạn 2 luồng CPU bằng torch.set_num_threads(2) trong common.py, để chạy chung với tiến trình khác không tranh hết CPU): python3.12 -m venv .venv && .venv/bin/pip install -r requirements.txt, rồi chạy baseline.py, train_lora.py 8 (đổi tham số thành 2 hoặc 32 để lặp lại bảng rank), merge_check.py và memory_estimate.py trong code/s7-44; các file *_output.txt là output đã dán ở trên. Nguồn chính thống: hướng dẫn LoRA của PEFT, bài báo LoRA và QLoRA. Muốn hiểu kiến trúc mà LoRA gắn vào, đọc lại Transformer và cơ chế attention.
Bài tiếp theo
Đánh giá LLM và guardrails: bộ test, LLM-as-judge và chống prompt injection. Fine-tune xong mới chỉ là một nửa công việc: bài sau xây bộ test tự động cho đầu ra của mô hình, dùng LLM làm giám khảo có kiểm soát và chặn prompt injection trước khi đưa vào sản xuất.