Một cửa hàng có hàng nghìn đánh giá của khách mỗi tháng, và câu hỏi quen thuộc là bao nhiêu phần trong đó đang phàn nàn. Bài toán này gọi là phân tích cảm xúc, và với tiếng Việt, lựa chọn phổ biến hiện nay là PhoBERT, mô hình ngôn ngữ huấn luyện sẵn riêng cho tiếng Việt. Bài này đi trọn một vòng: tải bộ dữ liệu phản hồi sinh viên UIT-VSFC, dựng baseline TF-IDF làm mốc, fine-tune PhoBERT bằng Hugging Face Trainer trên máy Apple Silicon, thử thêm trọng số lớp cho nhãn hiếm, rồi đọc kết quả thật bằng ma trận nhầm lẫn thay vì chỉ nhìn độ chính xác. Mọi con số dưới đây là output thật của lần chạy trên máy này.
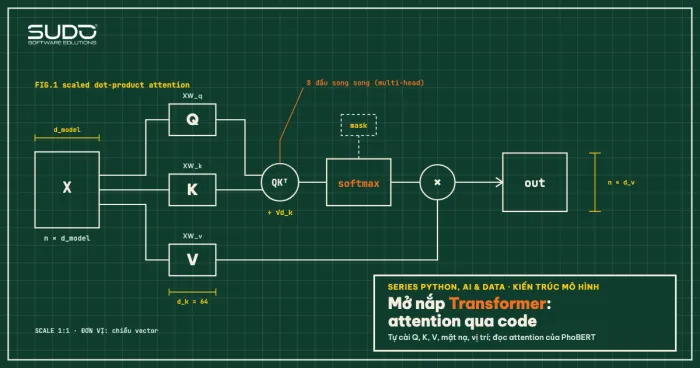
Bài nối tiếp Transformer và cơ chế attention: đọc hiểu kiến trúc qua code, và dùng lại baseline ở Phân loại văn bản tiếng Việt: tách từ, TF-IDF và mô hình tuyến tính. Phiên bản dùng trong bài: Python 3.12, torch 2.2.2, transformers 4.38.2, datasets 2.19.0, scikit-learn 1.4.2, pyvi 0.1.1. Tên tham số evaluation_strategy trong mã đúng với transformers 4.38; nếu bạn cài bản khác, hãy đối chiếu tài liệu của bản đó.
PhoBERT là gì và vì sao không dùng BERT đa ngôn ngữ
Theo bài báo PhoBERT: Pre-trained language models for Vietnamese của Dat Quoc Nguyen và Anh Tuan Nguyen (Findings of EMNLP 2020), PhoBERT có hai phiên bản base và large, là các mô hình ngôn ngữ đơn ngữ quy mô lớn đầu tiên được công bố cho tiếng Việt. Các tác giả báo cáo mô hình vượt XLM-R, một mô hình đa ngôn ngữ mạnh, và đạt kết quả tốt nhất tại thời điểm đó trên gán nhãn từ loại, phân tích phụ thuộc, nhận dạng thực thể và suy diễn ngôn ngữ tự nhiên. Kiến trúc giống BERT (Transformer encoder, đã phân tích ở bài trước); khác biệt nằm ở dữ liệu tiền huấn luyện và bộ tách token.
Bảng thông tin trong kho VinAIResearch/PhoBERT: phobert-base có 135 triệu tham số, phobert-large có 370 triệu, độ dài tối đa 256 token, tiền huấn luyện trên 20 GB văn bản Wikipedia và tin tức, giấy phép MIT. Bài này dùng phobert-base vì vừa với giới hạn RAM của máy thử và vì đủ để minh hoạ quy trình fine-tune PhoBERT.
Lưu ý về phiên bản: cùng kho còn có phobert-base-v2, tiền huấn luyện thêm 120 GB văn bản từ OSCAR-2301 và dùng giấy phép AGPL-3.0 (trang mô hình trên Hugging Face ghi bản quyền 2023; trang kho không ghi ngày phát hành). Bài này dùng bản v1 (vinai/phobert-base, MIT); nếu dùng v2 hoặc bản khác, hãy đọc lại giấy phép của đúng phiên bản đó.
Điều kiện bắt buộc: văn bản phải tách từ trước
Đây là chỗ người mới hay hỏng nhất. README của PhoBERT ghi rõ đầu vào phải được tách từ sẵn, và khuyến nghị dùng RDRSegmenter của VnCoreNLP vì dữ liệu tiền huấn luyện cũng tách bằng công cụ đó. Tiếng Việt viết cách nhau bằng khoảng trắng theo âm tiết, không theo từ: "giảng viên" là một từ nhưng gồm hai âm tiết. Sau tách từ, các âm tiết trong từ ghép được nối bằng dấu gạch dưới. Trong bài tôi dùng pyvi cho nhẹ (không cần Java); đây là công cụ khác RDRSegmenter nên ranh giới từ có thể lệch một chút so với lúc tiền huấn luyện, và là một điểm có thể làm giảm chất lượng so với cách chuẩn.
Đoạn tokenize_demo.py cho thấy tokenizer xử lý hai trường hợp khác nhau thế nào:
gốc       : giảng viên nhiệt tình và giảng dạy dễ hiểu .
tách từ   : giảng_viên nhiệt_tình và giảng_dạy dễ hiểu .
token (có): ['giảng_viên', 'nhiệt_tình', 'và', 'giảng_dạy', 'dễ', 'hiểu', '.']
token (không tách từ): ['giảng', 'viên', 'nhiệt', 'tình', 'và', 'giảng', 'dạy', 'dễ', 'hiểu', '.']
Khi có tách từ, "giảng_viên" nằm trong từ điển như một token. Khi không, PhoBERT nhận các âm tiết rời, khác với những gì nó đã thấy lúc tiền huấn luyện. Tôi không đo riêng tác động lên điểm số trong bài này, nên không khẳng định mức giảm cụ thể; bạn nên tự kiểm nếu dữ liệu của bạn khó tách từ.
Dữ liệu UIT-VSFC và baseline TF-IDF
Bộ dữ liệu là UIT-VSFC (Vietnamese Students' Feedback Corpus) của nhóm UIT NLP, công bố bởi Nguyen và cộng sự tại hội nghị KSE 2018. Thẻ dữ liệu trên Hugging Face nêu 11.426 câu train, 1.583 câu validation, 3.166 câu test, mỗi câu có nhãn cảm xúc (0 tiêu cực, 1 trung tính, 2 tích cực) và nhãn chủ đề. Giấy phép được ghi là "Unknown", nên với dự án thương mại hãy kiểm tra điều khoản trước khi dùng; bài chỉ dùng cho mục đích học tập. Thống kê thật sau khi tải về (prepare_output.txt):
train       11426 câu | tiêu cực 5325 (46.6%) | trung tính 458 (4.0%) | tích cực 5643 (49.4%)
           độ dài trung bình 14.3 âm tiết, dài nhất 159
validation   1583 câu | tiêu cực 705 (44.5%) | trung tính 73 (4.6%) | tích cực 805 (50.9%)
test         3166 câu | tiêu cực 1409 (44.5%) | trung tính 167 (5.3%) | tích cực 1590 (50.2%)
ví dụ gốc  : nói tiếng anh lưu loát .
sau tách từ: nói tiếng anh lưu_loát .
Điểm cần nhìn ngay: nhãn "trung tính" chỉ chiếm khoảng 4–5%. Đây là dữ liệu mất cân bằng, nên độ chính xác tổng thể sẽ che khuất chất lượng ở lớp hiếm; ta đã gặp vấn đề này ở Đánh giá mô hình phân loại: precision, recall, ROC và dữ liệu lệch. Vì vậy bài báo cáo macro-F1 (trung bình F1 của ba lớp, mỗi lớp trọng số như nhau) bên cạnh accuracy.
Baseline: TF-IDF 1–2 gram và LinearSVC trên văn bản đã tách từ, chọn tham số C theo validation (baseline.py):
C=0.1: macro-F1 trên validation = 0.6630
C=0.3: macro-F1 trên validation = 0.7237
C=1.0: macro-F1 trên validation = 0.7464

Chọn C=1.0 (theo validation). Kết quả trên test (3166 câu):
accuracy = 0.8986 | macro-F1 = 0.7017
              precision    recall  f1-score   support
    tiêu cực      0.881     0.957     0.917      1409
  trung tính      0.622     0.168     0.264       167
    tích cực      0.924     0.923     0.924      1590
Baseline đạt 89,9% accuracy nhưng chỉ bắt được 16,8% câu trung tính (recall 0,168). Mốc để vượt là accuracy 0,8986 và macro-F1 0,7017.
Fine-tune PhoBERT bằng Hugging Face Trainer
Hướng dẫn phân loại chuỗi của Hugging Face mô tả quy trình chuẩn: tải AutoModelForSequenceClassification với số nhãn, mã hoá văn bản, dùng DataCollatorWithPadding để đệm động theo batch thay vì đệm cả tập về độ dài tối đa, định nghĩa compute_metrics, rồi đưa tất cả vào Trainer. Với PhoBERT, AutoModelForSequenceClassification trả về RobertaForSequenceClassification: đầu phân loại (dropout, lớp tuyến tính, hàm tanh, dropout, lớp tuyến tính đầu ra) đặt trên vector của token <s> ở đầu câu và được khởi tạo ngẫu nhiên. Toàn bộ tham số, tức khoảng 135 triệu kể cả đầu phân loại mới, được cập nhật cùng lúc, đó là lý do gọi là fine-tune.
Phần nạp dữ liệu và mô hình trong train.py:
tok = AutoTokenizer.from_pretrained("vinai/phobert-base")
class DS(torch.utils.data.Dataset):
    def __init__(self, rows):
        enc = tok([r["seg"] for r in rows], truncation=True, max_length=64)
        self.items = [{"input_ids": enc["input_ids"][i], "attention_mask": enc["attention_mask"][i],
                       "labels": r["label"]} for i, r in enumerate(rows)]
    def __len__(self): return len(self.items)
    def __getitem__(self, i): return self.items[i]

model = AutoModelForSequenceClassification.from_pretrained(
    "vinai/phobert-base", num_labels=3,
    id2label=dict(enumerate(LABELS)), label2id={l: i for i, l in enumerate(LABELS)})
Chọn max_length=64 thay vì 256 là có cơ sở: output thật cho thấy độ dài token trung bình 13,5, phân vị 99 là 46, và chỉ 0,24% câu train bị cắt ở 64. Với câu ngắn như vậy, giữ 256 chỉ tốn thêm bộ nhớ. Nếu dữ liệu của bạn là bài đánh giá dài vài đoạn, hãy đo lại phân bố độ dài trước khi chốt.
Siêu tham số và huấn luyện:
args = TrainingArguments(
    output_dir="tmp_out", num_train_epochs=3, learning_rate=3e-5, weight_decay=0.01, warmup_ratio=0.1,
    per_device_train_batch_size=16, per_device_eval_batch_size=64, evaluation_strategy="epoch",
    save_strategy="no", logging_steps=100, report_to=[], seed=42, dataloader_num_workers=0)
trainer = Trainer(model=model, args=args, train_dataset=dtr, eval_dataset=dva, tokenizer=tok,
                  data_collator=DataCollatorWithPadding(tok), compute_metrics=metrics)
trainer.train()
Vài lựa chọn đáng giải thích. Learning rate 3e-5 nằm trong khoảng thường dùng cho fine-tune mô hình cỡ BERT (khoảng 2e-5 tới 5e-5). warmup_ratio=0.1 tăng dần learning rate trong 10% bước đầu, rồi giảm tuyến tính về 0; cách này giúp tránh làm hỏng các trọng số đã học khi lớp phân loại mới còn ngẫu nhiên. save_strategy="no" không ghi checkpoint nên không tốn đĩa, đổi lại ta không có "mô hình tốt nhất theo validation" mà dùng mô hình sau epoch cuối. Tôi cũng đặt torch.set_num_threads(2) theo giới hạn tài nguyên của máy dùng chung.
Kết quả lần chạy đầy đủ, 3 epoch trên 11.426 câu (train_plain_output.txt), thiết bị MPS của Apple Silicon:
thời gian huấn luyện: 10.2 phút
epoch 1: val loss 0.2568 | acc 0.9406 | macro-F1 0.8329
epoch 2: val loss 0.2032 | acc 0.9551 | macro-F1 0.8606
epoch 3: val loss 0.2217 | acc 0.9558 | macro-F1 0.8672

TEST (3166 câu): accuracy = 0.9397 | macro-F1 = 0.8253
              precision    recall  f1-score   support
    tiêu cực      0.941     0.972     0.956      1409
  trung tính      0.738     0.455     0.563       167
    tích cực      0.951     0.962     0.957      1590

ma trận nhầm lẫn (hàng = thật, cột = dự đoán):
 [[1369   16   24]
 [  37   76   54]
 [  49   11 1530]]
RAM đỉnh (ru_maxrss): 2.20 GB
Trước khi đọc kết quả PhoBERT, cần nói về lần chạy thử nhanh (smoke test) mà tôi làm trước đó với 320 câu và 1 epoch: accuracy 0,7716, macro-F1 0,5280 và lớp "trung tính" bị bỏ hoàn toàn (precision, recall đều 0). Việc chạy thử trên một tập nhỏ trước khi chạy dài là thói quen tốt để bắt lỗi mã, nhưng đừng đọc điểm của nó như chất lượng mô hình.
Kết quả PhoBERT so với baseline
| Mô hình | Accuracy (test) | Macro-F1 (test) | F1 lớp trung tính |
|---|---|---|---|
| TF-IDF + LinearSVC | 0,8986 | 0,7017 | 0,264 |
| PhoBERT, 3 epoch | 0,9397 | 0,8253 | 0,563 |
| PhoBERT, 3 epoch, trọng số lớp | 0,9378 | 0,8291 | 0,579 |
PhoBERT hơn baseline 4,1 điểm phần trăm accuracy (0,8986 lên 0,9397) và 12,4 điểm macro-F1 (0,7017 lên 0,8253). Phần lớn lợi thế của PhoBERT đến từ lớp hiếm: F1 của "trung tính" tăng từ 0,264 lên 0,563, recall từ 0,168 lên 0,455. Hai lớp lớn cũng cải thiện nhưng ít hơn (F1 tiêu cực từ 0,917 lên 0,956, tích cực từ 0,924 lên 0,957).
Đọc ma trận nhầm lẫn thì thấy chỗ còn yếu. Trong 167 câu trung tính thật, PhoBERT chỉ đoán đúng 76; 54 câu bị gán "tích cực" và 37 bị gán "tiêu cực". Ví dụ vài câu trung tính trong tập test: "ổn .", "môn học này giúp chúng em hiểu ra những vấn đề cơ bản ." Đây là các câu mà chính người gán nhãn có thể cũng bất đồng (bài không đo độ đồng thuận giữa người gán nhãn nên đây là suy đoán, không phải kết luận), và nếu đúng thì trần chất lượng của lớp này thấp hơn hai lớp kia, và mô hình lớn hơn chưa chắc giải quyết được. Nếu nghiệp vụ của bạn cần bắt đúng ý kiến trung tính, hãy kiểm tra chất lượng nhãn trước khi tăng cỡ mô hình.
Dữ liệu mất cân bằng: trọng số lớp cho PhoBERT
Cách xử lý phổ biến cho lớp hiếm là nhân hàm mất mát cross-entropy với trọng số tỉ lệ nghịch với tần suất lớp. Tài liệu Trainer hướng dẫn ghi đè compute_loss cho trường hợp này. Trong train.py, cờ --weighted bật lớp con sau:
class WTrainer(Trainer):
    def compute_loss(self, model, inputs, return_outputs=False):
        labels = inputs.pop("labels"); out = model(**inputs)
        loss = nn.functional.cross_entropy(out.logits, labels, weight=self.w.to(out.logits.device))
        return (loss, out) if return_outputs else loss

cnt = np.bincount([r["label"] for r in tr], minlength=3)
trainer.w = torch.tensor(len(tr) / (3 * cnt), dtype=torch.float32)
Với tần suất train 5.325 / 458 / 5.643, công thức này cho trọng số thật in ra khi chạy: [0.72, 8.32, 0.67], tức một câu trung tính "nặng" gấp khoảng 12 lần một câu tích cực trong hàm mất mát. Kết quả sau 3 epoch (train_weighted_output.txt):
epoch 1: val loss 0.8277 | acc 0.9463 | macro-F1 0.8522
epoch 2: val loss 0.6503 | acc 0.9526 | macro-F1 0.8672
epoch 3: val loss 0.7835 | acc 0.9551 | macro-F1 0.8718

TEST (3166 câu): accuracy = 0.9378 | macro-F1 = 0.8291
    tiêu cực      0.941     0.967     0.954      1409
  trung tính      0.717     0.485     0.579       167
    tích cực      0.950     0.959     0.955      1590

ma trận nhầm lẫn (hàng = thật, cột = dự đoán):
 [[1363   17   29]
 [  35   81   51]
 [  50   15 1525]]
Cần đọc thật thận trọng. Macro-F1 tăng từ 0,8253 lên 0,8291 (khoảng 0,4 điểm) và recall trung tính từ 0,455 lên 0,485, tức bắt thêm 5 câu trong 167 câu; đổi lại accuracy giảm 0,19 điểm. Đó là mức chênh nhỏ, từ một hạt giống ngẫu nhiên và một lần chạy mỗi cấu hình; tôi không có khoảng tin cậy, nên không thể nói trọng số lớp "tốt hơn" một cách chắc chắn. Điều có thể nói: ở dữ liệu này trọng số lớp dịch trade-off về phía recall của lớp hiếm một chút, và không thần kỳ. Để kết luận vững hơn, cần chạy vài hạt giống và so trung bình kèm độ lệch chuẩn.
Cũng lưu ý val loss của bản có trọng số (0,78) cao hơn bản thường (0,22) không có nghĩa mô hình kém hơn: hai hàm mất mát nhân trọng số khác nhau nên không so trực tiếp với nhau được.
Tài nguyên: chạy PhoBERT trên 16 GB RAM
Cả hai lần fine-tune đều có RAM đỉnh khoảng 2,2 GB (ru_maxrss 2,20 và 2,21 GB), mỗi lần khoảng 10 phút cho 3 epoch trên MPS. Các biện pháp đã dùng: batch 16, độ dài tối đa 64 (đệm động, không đệm về 256), 2 luồng CPU, không lưu checkpoint. Mốc RAM trong bài là ru_maxrss, tức RSS cực đại của tiến trình do hệ điều hành ghi nhận. Nếu bạn gặp lỗi hết bộ nhớ trên MPS, hãy giảm batch size, giảm max_length, hoặc gọi torch.mps.empty_cache() định kỳ vì đệm động tạo ra nhiều hình dạng tensor khác nhau và cache phình dần.
Máy thử không có GPU NVIDIA nên tôi không chạy phần fp16 trong bài.
Dùng PhoBERT sau khi huấn luyện
Với PhoBERT đã huấn luyện, bước cuối là đóng gói để gọi suy luận. Khi lưu bằng model.save_pretrained() và tok.save_pretrained(), bạn tải lại bằng pipeline("text-classification", ...). Nhớ rằng đầu vào phải qua cùng bước tách từ với lúc huấn luyện, nếu không kết quả sẽ lệch âm thầm mà không báo lỗi:
from pyvi import ViTokenizer
from transformers import pipeline

clf = pipeline("text-classification", model="model_out", tokenizer="model_out")
text = "giảng viên nhiệt tình nhưng phòng học quá nóng ."
print(clf(ViTokenizer.tokenize(text)))
Trong bài tôi chỉ đặt cờ SAVE_MODEL=1 để lưu mô hình khi cần và không lưu mặc định, vì PhoBERT sau fine-tune nặng hơn 500 MB. Đoạn suy luận trên là mẫu API, tôi không chạy riêng và không dán output.
Khi nào không nên fine-tune PhoBERT
- Dữ liệu ít (vài trăm câu) hoặc bài toán đơn giản: baseline TF-IDF thường đủ, rẻ hơn và dễ giải thích, như ở bài phân loại văn bản. Ở đây baseline đã đạt 89,9% accuracy; hãy tự hỏi 4 điểm thêm có đáng chi phí vận hành không.
- Văn bản dài: PhoBERT giới hạn 256 token; với tài liệu dài cần chia đoạn hoặc chọn mô hình khác.
- Miền khác xa tin tức và Wikipedia: mạng xã hội nhiều viết tắt, teencode, tiếng lóng có thể làm tách từ và từ điển hoạt động kém. Cần đo trên dữ liệu thật của bạn.
- Cần kiểm soát giấy phép:
phobert-basevàphobert-largedùng giấy phép MIT theo bảng trong kho VinAIResearch (phobert-base-v2dùng AGPL-3.0, khác hẳn), còn bộ dữ liệu UIT-VSFC ghi "Unknown"; hãy đọc kỹ trước khi dùng thương mại. - Cần giải thích từng quyết định: mô hình sâu khó giải thích hơn mô hình tuyến tính; xem Giải thích mô hình với SHAP: biết vì sao mô hình quyết định nếu cần bổ sung.
Lỗi thường gặp
- Quên tách từ: PhoBERT vẫn chạy nhưng nhận các âm tiết rời, khác điều nó đã học.
- Chỉ nhìn accuracy: với dữ liệu lệch, 94% accuracy có thể đi cùng recall 45% ở lớp hiếm, như bảng trên.
- Chọn mô hình theo điểm test: tham số và epoch nên chọn theo validation, test chỉ chạm một lần ở cuối; ở bài này C của baseline cũng được chọn theo validation.
- Kết luận từ một hạt giống: chênh 0,4 điểm macro-F1 giữa hai cấu hình chưa đủ làm bằng chứng.
- Lệch phiên bản API: tên tham số như
evaluation_strategy(bản 4.38 dùng trong bài) có thể đổi ở các bảntransformerssau; ghim phiên bản trongrequirements.txt. - Để checkpoint tích tụ: mỗi checkpoint hàng trăm MB; đặt
save_total_limithoặc tắt lưu như bài.
Checklist fine-tune PhoBERT
- Xem phân bố nhãn trước; chọn macro-F1 khi dữ liệu lệch.
- Dựng baseline TF-IDF trước để biết mô hình sâu có đáng không.
- Tách từ đầu vào cùng một cách ở huấn luyện và suy luận.
- Đo phân bố độ dài token để chọn
max_length; dùng đệm động. - Chạy thử 1 epoch trên tập nhỏ để bắt lỗi mã.
- So cấu hình bằng nhiều hạt giống trước khi tuyên bố cải thiện.
- Đọc ma trận nhầm lẫn và các câu sai; kiểm tra chất lượng nhãn.
- Kiểm giấy phép của dữ liệu và mô hình.
Mã nằm trong code/s7-28: prepare.py, baseline.py, train.py, tokenize_demo.py cùng các file *_output.txt. Dữ liệu tải từ Hugging Face Hub (uitnlp/vietnamese_students_feedback) rồi lưu dạng parquet và JSONL trong data/. Các con số trong bài là output thật của một lần chạy với seed=42 trên Apple Silicon; trên máy khác kết quả sẽ lệch nhẹ.
Bài tiếp theo
Speech-to-text tiếng Việt với Whisper: chạy local và tối ưu tốc độ. Sau khi xử lý văn bản, bài sau chuyển sang âm thanh: chạy mô hình Whisper trên CPU, đo WER cho tiếng Việt và so các tuỳ chọn tăng tốc như lượng tử hoá int8 và lọc im lặng.