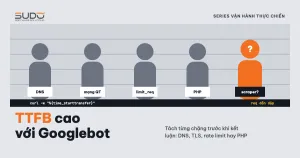
TTFB (time to first byte) là thời gian từ lúc gửi request tới khi nhận byte đầu tiên của phản hồi. Với người dùng, TTFB cao là trang tải chậm vài lần. Với Googlebot, TTFB cao kéo dài là tín hiệu máy chủ đang quá tải, và Google sẽ tự giảm nhịp crawl. Bài này mô tả một tình huống điển hình trên Cloud VPS: các site bị một scraper chạy từ chính hạ tầng nội bộ cào dồn dập, gây timeout và đẩy TTFB lên. Nội dung gồm cách tách TTFB theo từng chặng, cách xác minh Googlebot thật, cách tìm nguồn tải khi log thiếu dữ liệu thời gian, và những gì cần chuẩn bị để lần sau đo được bằng số.
Triệu chứng
- Một số site có request timeout rải rác, người dùng thỉnh thoảng thấy trang tải chậm.
- Các site này chạy trên minion dùng chung pool PHP-FPM. Như bài PHP-FPM treo: lần theo strace tới cuộc gọi S3 đồng bộ đã phân tích, pool dùng chung chỉ cần một nguồn request chậm hoặc dồn dập là mọi site trên máy cùng chịu.
- Googlebot không phân biệt "site chậm vì bị cào" với "site chậm". Theo tài liệu quản lý crawl budget của Google, khi máy chủ phản hồi chậm hoặc trả lỗi, giới hạn tốc độ crawl giảm xuống.
Điều tra TTFB theo từng chặng
Bước 1: kiểm tra log có thời gian xử lý không
Câu hỏi đầu tiên khi nghi TTFB cao là: request nào chậm, chậm từ lúc nào? Access log trên balancer lẽ ra phải trả lời được, nhưng định dạng mặc định thường không có trường thời gian:
log_format main '$remote_addr - $remote_user [$time_local] "$request" '
                '$status $body_bytes_sent "$http_referer" '
                '"$http_user_agent" "$http_x_forwarded_for"';
Thiếu $request_time (tổng thời gian nginx xử lý request) và $upstream_response_time (thời gian chờ upstream trả lời), log chỉ cho biết ai gọi, gọi gì, mã trạng thái bao nhiêu, không cho biết TTFB. Khi đó phải đo tay.
Bước 2: tách TTFB bằng curl
TTFB nhìn từ Googlebot là tổng của nhiều chặng: phân giải DNS, bắt tay TCP, bắt tay TLS ở balancer, balancer chuyển tiếp xuống minion, và PHP xử lý. Tuỳ chọn -w của curl in ra mốc thời gian của từng chặng:
UA="Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"

# 1. Từ ngoài Internet, đi qua balancer như Googlebot
curl -s -o /dev/null -A "$UA" https://example.com/ \
  -w "dns=%{time_namelookup} tcp=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total}\n"

# 2. Từ balancer, gọi thẳng minion qua mạng private (bỏ TLS, bỏ balancer)
curl -s -o /dev/null -A "$UA" -H "Host: example.com" http://10.0.0.21/ \
  -w "ttfb=%{time_starttransfer}\n"

# 3. Ngay trên minion, qua nginx local
curl -s -o /dev/null -A "$UA" -H "Host: example.com" http://127.0.0.1/ \
  -w "ttfb=%{time_starttransfer}\n"
Hiệu giữa các lần đo cho biết chặng nào tốn thời gian. Nếu TTFB đo ngay trên minion đã cao, vấn đề nằm ở PHP hoặc database; nếu minion nhanh mà đo từ ngoài chậm, vấn đề nằm ở mạng, TLS hoặc balancer. Đo nhiều lần, vì một lần đo trúng lúc pool đang bận sẽ khác hẳn lúc pool rảnh:
for i in $(seq 1 20); do
  curl -s -o /dev/null -A "$UA" -w "%{time_starttransfer}\n" https://example.com/
  sleep 3
done | sort -n | awk '{a[NR]=$1} END{print "min="a[1], "p50="a[int(NR/2)], "max="a[NR]}'
Bước 3: Googlebot thật hay giả
Nhiều scraper tự xưng là Googlebot trong User-Agent. Trước khi kết luận "Googlebot bị chậm" hay "Googlebot cào quá nhiều", phải xác minh IP theo cách Google hướng dẫn: tra ngược DNS ra tên miền googlebot.com hoặc google.com, rồi tra xuôi tên đó phải ra lại đúng IP.
host 66.249.66.1
# 1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
host crawl-66-249-66-1.googlebot.com
# crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Bước 4: tìm ai đang chiếm tài nguyên
Khi log không có thời gian, số lượng request theo IP, theo User-Agent và theo giờ là manh mối còn lại, tương tự cách đo trong bài OOM nginx trên balancer: khi một máy nhỏ gánh nhiều website:
LOG=/var/log/nginx/example.com.access
DAY='<dd/Mon/yyyy>'

# top IP trong ngày
grep "$DAY" $LOG | awk '{print $1}' | sort | uniq -c | sort -rn | head
# top User-Agent
grep "$DAY" $LOG | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head
# request bị client bỏ dở (499) và upstream timeout (504)
awk '$9==499 || $9==504 {print $9}' $LOG | sort | uniq -c
Một client gửi rất nhiều request, đều đặn cả ngày lẫn đêm, là dấu hiệu của công cụ tự động. Khi IP của nó nằm trong dải của chính hạ tầng mình, câu chuyện đổi từ "chặn bot lạ" sang "sửa công cụ nhà mình".
Bước 5: xem lớp rate limit có cộng thêm độ trễ không
Một cấu hình rate limit cho request động thường có dạng:
# nginx.conf
limit_req_zone  $binary_remote_addr zone=dynamic:10m rate=25r/s;
limit_conn_zone $binary_remote_addr zone=conn_dynamic:10m;

# site.conf
location / {
    limit_req zone=dynamic burst=50;
    limit_conn conn_dynamic 100;
}
Lớp này giới hạn theo từng IP, nên Googlebot không phải trả giá cho scraper. Nhưng theo tài liệu module limit_req, khi không có nodelay, request vượt tốc độ trong phạm vi burst không bị từ chối mà bị trì hoãn cho đúng nhịp. Với tốc độ r request/giây và burst 50, request cuối hàng có thể chờ tới 50/r giây; ở mức 25 r/s là khoảng 2 giây. Độ trễ này không hiện ra ở mã trạng thái, mà cộng thẳng vào TTFB của chính client đó, kể cả Googlebot nếu nó gửi dồn từ một IP.
Nguyên nhân gốc
- Một công cụ nội bộ cào nội dung từ các website trên cùng hạ tầng, không giới hạn tốc độ.
- Request của nó đi vào minion chạy pool PHP-FPM dùng chung, chiếm worker mà người dùng thật và Googlebot cũng cần.
- Khi worker bận, request khác phải xếp hàng: TTFB tăng, một phần chuyển thành timeout.
Nguyên nhân nền là thiếu công cụ quan sát: log không có thời gian xử lý thì TTFB cao chỉ được phát hiện khi có người than phiền, và sau sự cố cũng không định lượng được Googlebot đã chậm bao nhiêu. Khi viết hậu kiểm, cần ghi rõ phần nào là dữ kiện (có timeout, có nguồn request dồn dập) và phần nào là cơ chế suy ra.
Khắc phục
Trước mắt
Dừng hoặc giới hạn công cụ gây tải. Đây là biện pháp dứt điểm cho nguồn tải này, nhưng không trả lời câu hỏi "lần sau làm sao biết sớm hơn".
Lâu dài
- Thêm thời gian vào log trên balancer và minion, để TTFB trở thành dữ liệu thay vì phỏng đoán:
log_format timed '$remote_addr - $remote_user [$time_local] "$request" ' '$status $body_bytes_sent "$http_referer" "$http_user_agent" ' 'rt=$request_time urt=$upstream_response_time'; - Công cụ nội bộ phải tự giới hạn: ít kết nối đồng thời, có độ trễ giữa các request, User-Agent riêng để nhận diện trong log, chạy giờ thấp điểm. Nếu dữ liệu có sẵn trong database, đọc database thay vì cào HTML qua PHP.
- Không miễn trừ rate limit cho IP nội bộ ở request động. Công cụ nhà mình cũng có thể gây quá tải như bot lạ.
- Cân nhắc
nodelaycholimit_reqsau khi đo được thời gian chờ thật.
Phòng ngừa TTFB cao
- Đo TTFB định kỳ với User-Agent Googlebot cho vài site đại diện mỗi minion và lưu kết quả. Một chuỗi số theo thời gian giá trị hơn nhiều lần đo vội khi đã có sự cố.
- Lập danh sách mọi công cụ nội bộ gọi vào website production: ai chạy, chạy lúc nào, tốc độ bao nhiêu.
- Khi đã có
$upstream_response_time, cảnh báo theo phân vị cao (p95), không theo trung bình. - Xác minh Googlebot bằng reverse DNS trước mọi quyết định chặn hoặc nới rate limit cho "Googlebot". Bài Domain demo và bài học bị Google index có thêm bối cảnh về cách Googlebot đi vào hạ tầng nhiều site.
Bài học
- Kẻ gây tải có thể là chính mình. Mọi lớp chặn bot đều hướng ra ngoài; một công cụ nội bộ không giới hạn tốc độ lọt qua tất cả.
- Không có log thời gian thì không có TTFB. Biết có timeout nhưng không trả lời được đã chậm bao nhiêu. Thiếu dữ liệu là nợ kỹ thuật thật, không phải chi tiết phụ.
- TTFB là tổng nhiều chặng. Đo từ ngoài, từ balancer và từ minion trước khi kết luận chặng nào có lỗi.
- Rate limit có thể làm chậm âm thầm.
burstkhông kèmnodelaybiến request vượt nhịp thành request chờ, và không để lại dấu vết ở mã trạng thái.
Bài tiếp theo
Giảm RAM MySQL trên VPS nhỏ: tuning buffer và kết nối. Một máy database RAM nhỏ, không swap, RAM đứng yên ở mức báo động dù không có truy vấn nào đang chạy.