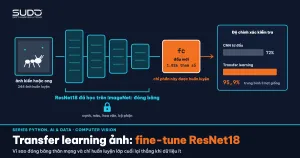
Có 244 ảnh để huấn luyện, hai lớp kiến, ong, và bạn muốn một mô hình phân loại ảnh. Huấn luyện CNN từ đầu cho kết quả 71,9% trên tập kiểm tra (153 ảnh: 70 ảnh kiến, 83 ảnh ong, nên luôn đoán "ong" đã đạt 54,2%). Nhưng nếu lấy một mạng đã học trên hàng triệu ảnh ImageNet, giữ nguyên toàn bộ phần trích đặc trưng và chỉ huấn luyện đúng 1.026 tham số của lớp cuối, độ chính xác lên 95,9%.
Đó là sức mạnh của transfer learning: tái sử dụng tri thức thị giác đã học từ bài toán lớn cho bài toán nhỏ của bạn. Bài này giải thích vì sao nó hiệu quả, cách cài đặt đúng với PyTorch và torchvision, và những cái bẫy thực tế, kèm số đo thật chạy 3 hạt giống trên máy Apple Silicon.
Bài nối tiếp Huấn luyện deep learning ổn định: optimizer, learning rate và regularization (learning rate, schedule, overfitting) và PyTorch cơ bản: tensor, autograd và vòng lặp huấn luyện. Cách đọc độ chính xác và chọn chỉ số xem ở Đánh giá mô hình phân loại: precision, recall, ROC và dữ liệu lệch. Môi trường: Apple Silicon, 16 GB, GPU Metal (device="mps"), Python 3.10, PyTorch 2.1.1, torchvision 0.16.1. API weights= của torchvision có từ bản 0.13 (2022), nên đoạn mã dùng được với các bản từ 0.13 trở lên.
CNN và vì sao transfer learning hiệu quả
Mạng nơ-ron tích chập (CNN) xử lý ảnh bằng các bộ lọc nhỏ trượt trên ảnh. Lớp đầu học các mẫu đơn giản như cạnh và màu; lớp giữa ghép chúng thành góc, hoa văn, bộ phận; lớp cuối nhận ra cả vật thể. Công trình How transferable are features in deep neural networks? của Yosinski và cộng sự (NeurIPS 2014) đo chính điều này: các lớp đầu mang tính tổng quát, các lớp sau chuyên biệt dần cho tác vụ gốc, và khởi tạo bằng đặc trưng chuyển giao cho kết quả tốt hơn khởi tạo ngẫu nhiên kể cả sau khi fine-tune. Đó là cơ sở của transfer learning cho ảnh: phần đầu mạng học ở ImageNet vẫn dùng được với ảnh ong và kiến.
Mạng ta dùng là ResNet18, thuộc họ ResNet của He và cộng sự (Deep Residual Learning for Image Recognition, 2015), trong đó mỗi khối học phần dư so với đầu vào nhờ kết nối tắt, giúp huấn luyện được mạng sâu. Theo bảng của tài liệu torchvision models, trọng số IMAGENET1K_V1 của ResNet18 đạt 69,758% top-1 trên ImageNet-1K với 11,7 triệu tham số. Mô hình nhỏ, chạy tốt trên laptop, nên rất hợp để minh hoạ transfer learning.
| Chiến lược | Tham số được huấn luyện | Khi nào hợp |
|---|---|---|
| Học từ đầu | Toàn bộ, khởi tạo ngẫu nhiên | Dữ liệu rất lớn, ảnh khác hẳn ImageNet (y tế, vệ tinh) |
| Feature extractor (đóng băng) | Chỉ lớp phân loại mới | Rất ít dữ liệu, ảnh gần với ảnh tự nhiên |
| Fine-tune toàn bộ | Toàn bộ, khởi tạo từ ImageNet, lr nhỏ | Vừa đủ dữ liệu, cần độ chính xác cao hơn |
Hai kịch bản của transfer learning, đóng băng và fine-tune, chính là hai kịch bản trong hướng dẫn Transfer Learning chính thức của PyTorch, dùng cùng bộ dữ liệu ants/bees. Ta dùng lại bộ dữ liệu đó để người đọc có thể đối chiếu, nhưng tự viết mã và tự đo lại.
Chuẩn bị dữ liệu và tiền xử lý cho transfer learning
Bộ dữ liệu hymenoptera_data là một tập con rất nhỏ của ImageNet, do tài liệu PyTorch cung cấp để học tập; chỉ dùng cho mục đích nghiên cứu và học tập theo điều khoản của ImageNet. Cấu trúc thư mục train/ants, train/bees, val/ants, val/bees khớp với torchvision.datasets.ImageFolder.
torch 2.1.1 | torchvision 0.16.1 | device mps
train 244 val 153 lớp ['ants', 'bees']
Với 153 ảnh validation, một ảnh đổi dự đoán làm accuracy thay đổi 0,65 điểm phần trăm, nên những chênh lệch nhỏ hơn khoảng 1 điểm đều không đáng tin. Điều quan trọng nhất khi chuẩn bị dữ liệu cho transfer learning là dùng đúng phép tiền xử lý mà mạng gốc đã học: resize 256, cắt giữa 224, đưa về [0,1] rồi chuẩn hoá theo mean/std của ImageNet. Torchvision đóng gói điều này cùng trọng số:
w = models.ResNet18_Weights.IMAGENET1K_V1
m = models.resnet18(weights=w).eval()
prep = w.transforms()
print(prep)
print(w.meta["_metrics"]["ImageNet-1K"]["acc@1"], w.meta["num_params"])
Lưu ý: _metrics là khoá siêu dữ liệu nội bộ (có dấu gạch dưới) của torchvision chứ không phải API công khai, nên có thể đổi ở bản sau; nếu cần con số này cho báo cáo, hãy đối chiếu với bảng trong tài liệu.
ImageClassification(
    crop_size=[224]
    resize_size=[256]
    mean=[0.485, 0.456, 0.406]
    std=[0.229, 0.224, 0.225]
    interpolation=InterpolationMode.BILINEAR
)
acc@1 công bố: 69.758 | số tham số: 11689512
Chú ý cách ghi: ta truyền tường minh IMAGENET1K_V1 thay vì weights="DEFAULT", vì tài liệu cảnh báo bí danh DEFAULT có thể trỏ sang bộ trọng số khác ở phiên bản sau, làm kết quả không còn lặp lại được. Tham số cũ pretrained=True đã bị đánh dấu deprecated từ bản 0.13. Chạy mô hình gốc trên hai ảnh đầu tiên của tập val cho thấy nó vẫn nói bằng 1.000 lớp ImageNet:
ants/10308379_1b6c72e180.jpg: fountain 0.12, shovel 0.08, snowplow 0.04
bees/1032546534_06907fe3b3.jpg: apiary 0.48, bee 0.27, honeycomb 0.25
Đây là hai ảnh đơn lẻ, không phải thống kê, nhưng chúng minh hoạ rõ rằng đầu ra gốc không cho ta nhãn "ant, bee"; ta cần thay lớp cuối và huấn luyện lại phần đó. Riêng với tập huấn luyện, ta thêm tăng cường dữ liệu (data augmentation): RandomResizedCrop(224, scale=(0.5, 1.0)) và RandomHorizontalFlip(), để mô hình thấy mỗi ảnh theo nhiều dạng khác nhau mỗi epoch.
Cài đặt transfer learning trong PyTorch: thay đầu, đóng băng thân
Mỗi mô hình trong torchvision có một lớp phân loại cuối cùng; với ResNet18 đó là m.fc, nhận vector 512 chiều. Quy trình chuẩn gồm ba bước: tải trọng số, tuỳ chọn đóng băng, thay lớp cuối bằng lớp mới có số đầu ra đúng bài toán.
def resnet(mode):
    m = models.resnet18(weights=weights)
    in_f = m.fc.in_features
    if mode == "freeze":
        for p in m.parameters():
            p.requires_grad = False   # đóng băng toàn bộ thân mạng
    m.fc = nn.Linear(in_f, 2)         # lớp mới: requires_grad=True theo mặc định
    return m
Thứ tự là then chốt: thay fc sau khi đóng băng, vì lớp mới tạo ra có requires_grad=True. Nếu làm ngược lại, bạn đóng băng luôn cả lớp mới và không còn gì để học. Kiểm tra cấu hình transfer learning bằng cách đếm tham số:
python transfer.py params
chế độ freeze: train được 1,026 / tổng 11,177,538 tham số
chế độ full: train được 11,177,538 / tổng 11,177,538 tham số
Con số 1.026 khớp phép tính 512 × 2 + 2 (trọng số cộng bias của nn.Linear(512, 2)).
Hai điểm kỹ thuật dễ sót. Thứ nhất, nếu đóng băng thân mạng thì chỉ nên đưa các tham số còn requires_grad vào optimizer. Thứ hai, BatchNorm: ở chế độ train(), lớp này vẫn cập nhật thống kê trung bình/phương sai chạy dù trọng số bị đóng băng, làm "đặc trưng cố định" thực ra vẫn trôi theo dữ liệu nhỏ của bạn. Vì vậy ở chế độ feature extractor ta đặt các lớp BatchNorm2d về eval() sau mỗi lần gọi model.train():
model.train()
if freeze_bn:
    for m in model.modules():
        if isinstance(m, nn.BatchNorm2d):
            m.eval()   # giữ thống kê của ImageNet
Vòng huấn luyện dùng SGD với momentum 0,9 và lịch cosine giảm lr theo từng mini-batch (CosineAnnealingLR, T_max bằng tổng số bước), đúng tinh thần bài trước. Mô hình và dữ liệu được chuyển lên mps bằng .to(device).
Đo transfer learning so với CNN học từ đầu
Để có đối chứng công bằng, ta dùng một CNN nhỏ tự viết: bốn khối Conv-BatchNorm-ReLU-MaxPool (16, 32, 64, 64 kênh), AdaptiveAvgPool2d, một lớp tuyến tính, tổng 60.994 tham số, cùng augmentation, cùng 10 epoch. Mỗi cấu hình chạy 3 hạt giống (0, 1, 2), báo cáo accuracy trên tập validation sau epoch 1 và sau epoch cuối.
=== Toàn bộ 244 ảnh train, 10 epoch, 3 seed ===
CNN nhỏ từ đầu (lr 0.02)                   epoch1=0.593 ± 0.055 cuối=0.719 ± 0.041  params 60,994/60,994
ResNet18 ImageNet: đóng băng, chỉ train fc epoch1=0.943 ± 0.014 cuối=0.959 ± 0.004  params 1,026/11,177,538
ResNet18 ImageNet: fine-tune toàn bộ lr 0.01 epoch1=0.948 ± 0.017 cuối=0.941 ± 0.011  params 11,177,538/11,177,538
ResNet18 ImageNet: fine-tune toàn bộ lr 0.001 epoch1=0.789 ± 0.105 cuối=0.950 ± 0.010  params 11,177,538/11,177,538
ResNet18 ImageNet: fine-tune toàn bộ lr 0.1 epoch1=0.486 ± 0.049 cuối=0.593 ± 0.040  params 11,177,538/11,177,538
Cột "±" là độ lệch chuẩn mẫu (statistics.stdev, chia cho n − 1) trên n = 3 hạt giống; với n nhỏ như vậy nó chỉ cho biết cỡ dao động chứ không phải khoảng tin cậy. Mốc tham chiếu trên tập validation: đoán ngẫu nhiên 50%, luôn đoán lớp đa số (ong) 54,2%.
Có bốn kết luận về transfer learning. Thứ nhất, sau một epoch, transfer learning với lớp cuối đóng băng đã đạt 94,3%, trong khi CNN từ đầu cần cả 10 epoch để đạt 71,9%. Thứ hai, huấn luyện chỉ 1.026 tham số (0,01% mô hình) cho kết quả tốt nhất (0,959 ± 0,004), vì trên 244 ảnh việc chỉnh 11 triệu tham số dễ gây overfitting.
Thứ ba, fine-tune toàn bộ nhạy với learning rate: lr 0,001 và 0,01 cho 0,950 và 0,941, nằm trong khoảng nhiễu của nhau và thấp hơn đóng băng một chút; còn lr 0,1 phá hỏng mô hình (0,593, chỉ hơn mức đoán lớp đa số 54,2% khoảng 5 điểm). Thứ tư, lr 0,001 cần nhiều epoch hơn (epoch 1 chỉ 0,789); ở epoch cuối hai cấu hình lr 0,001 và 0,01 không khác biệt có ý nghĩa với 3 hạt giống.
Lý do lr 0,1 hỏng: bước nhảy lớn ghi đè trọng số ImageNet quý giá, tức là xoá chính tri thức ta muốn tái sử dụng (hiện tượng thường gọi là catastrophic forgetting). Quy tắc thực hành khi áp dụng transfer learning: khi fine-tune, dùng lr nhỏ hơn 10 đến 100 lần so với khi huấn luyện từ đầu, và dùng warmup hoặc lr nhỏ hơn cho phần thân so với lớp mới (tham số theo nhóm trong optimizer, param_groups).
Khi dữ liệu càng ít, transfer learning càng thắng
Thí nghiệm transfer learning thứ hai chỉ giữ 10 ảnh mỗi lớp (tổng 20 ảnh huấn luyện, chọn ngẫu nhiên theo hạt giống), vẫn đánh giá trên 153 ảnh validation:
=== Chỉ 10 ảnh mỗi lớp (20 ảnh), 10 epoch, 3 seed ===
CNN nhỏ từ đầu                             epoch1=0.514 ± 0.049 cuối=0.566 ± 0.080  params 60,994/60,994
ResNet18: đóng băng, chỉ train fc          epoch1=0.564 ± 0.046 cuối=0.937 ± 0.008  params 1,026/11,177,538
ResNet18: fine-tune toàn bộ lr 0.001       epoch1=0.536 ± 0.069 cuối=0.725 ± 0.092  params 11,177,538/11,177,538
Chỉ với 20 ảnh, CNN từ đầu chỉ đạt 0,566, xấp xỉ mức đoán lớp đa số (0,542). Transfer learning với thân đóng băng vẫn giữ 0,937 ± 0,008, cao hơn hơn 37 điểm phần trăm. Fine-tune toàn bộ tụt xuống 0,725 ± 0,092 và dao động mạnh giữa các hạt giống, bằng chứng rằng với rất ít dữ liệu, việc cập nhật toàn bộ trọng số làm mô hình mất ổn định. Mỗi ảnh huấn luyện bây giờ chiếm 5% dữ liệu, nên thân mạng đóng băng đóng vai trò như một bộ điều chuẩn cực mạnh. Nói cách khác, với transfer learning, lượng dữ liệu quyết định mức tự do bạn được cấp cho mô hình: càng ít dữ liệu, càng nên đóng băng nhiều.
Cách tiến hành transfer learning trong dự án thật
- Bắt đầu transfer learning bằng feature extractor: đóng băng thân, huấn luyện lớp cuối. Rẻ, nhanh, và cho baseline mạnh.
- Mở dần: nếu còn dư địa, mở khối cuối (
layer4trong ResNet) với lr nhỏ, rồi mới tới toàn bộ. - Dùng lr theo nhóm: lớp mới lr lớn hơn, thân mạng lr nhỏ.
- Đánh giá trên dữ liệu thật của bạn: ảnh sản phẩm chụp bằng điện thoại, trong cửa hàng, khác ảnh ImageNet; cần tập validation lấy từ cùng nguồn với dữ liệu triển khai.
- Lưu
state_dictthay vì cả mô hình:torch.save(model.state_dict(), path); dựng lại kiến trúc rồi nạpload_state_dict.
Ví dụ gần doanh nghiệp: một cửa hàng cần phân loại ảnh sản phẩm tải lên thành vài nhóm, mỗi nhóm có vài chục tới vài trăm ảnh do nhân viên gắn nhãn. Đây đúng là vùng mà transfer learning với mạng nhỏ như ResNet18 cho kết quả dùng được mà không cần GPU lớn, thay vì huấn luyện từ đầu.
Khi nào không nên dùng transfer learning
- Miền ảnh khác hẳn ảnh tự nhiên: ảnh X-quang, ảnh vệ tinh đa phổ, spectrogram. Transfer learning từ ImageNet chuyển được ít hơn; cần fine-tune sâu hơn, và vẫn nên so với huấn luyện từ đầu.
- Ràng buộc giấy phép: trọng số và dữ liệu có điều khoản riêng. Kiểm tra điều khoản của trọng số trước khi dùng thương mại.
- Ràng buộc kích thước và độ trễ: nếu phải chạy trên thiết bị rất yếu, có thể cần mô hình nhỏ hơn hoặc chưng cất.
- Dữ liệu dạng bảng hoặc chuỗi số: không có "ImageNet" cho dữ liệu bảng của bạn; gradient boosting thường là lựa chọn tốt hơn.
Lỗi thường gặp khi dùng transfer learning
- Không dùng đúng chuẩn hoá: quên
Normalize(mean, std)của ImageNet, hoặc dùng kích thước khác 224 cho ResNet, làm đặc trưng sai lệch mà không báo lỗi. - Đặt
requires_grad=Falsesau khi thayfc: đóng băng luôn lớp mới. - Đưa toàn bộ
model.parameters()vào optimizer khi đã đóng băng: SGD bỏ qua tham số không có gradient nên kết quả không đổi, nhưng mã kém rõ ý định; lọc theorequires_gradđể người đọc thấy ngay phần nào được học. - Quên BatchNorm: thống kê chạy vẫn đổi ở chế độ
train(). - Quên
model.eval()khi suy luận: dropout và batch norm đánh giá sai. - Learning rate cho fine-tune quá lớn: như kết quả lr 0,1, mất sạch tri thức tiền huấn luyện.
- Rò rỉ dữ liệu: ảnh gần trùng giữa train và val (cùng một sản phẩm chụp nhiều góc) làm accuracy phồng lên; chia theo sản phẩm, không chia theo ảnh.
- Dùng
pretrained=TruevàDEFAULTmà không ghi lại phiên bản: kết quả đổi khi nâng torchvision.
Checklist transfer learning
- Với transfer learning, dùng
weights=...IMAGENET1K_V1tường minh vàweights.transforms(). - Thay lớp cuối sau khi đóng băng; đếm tham số huấn luyện được để kiểm tra.
- Bắt đầu bằng feature extractor, rồi mới fine-tune với lr nhỏ.
- Càng ít dữ liệu càng đóng băng nhiều; ít ảnh thì thân đóng băng thường thắng.
- Giữ BatchNorm ở
eval()khi đóng băng. - Báo cáo trung bình ± độ lệch chuẩn trên nhiều hạt giống (nói rõ công thức, n); ghi số ảnh validation và mốc lớp đa số.
- Đánh giá trên ảnh cùng phân bố với ảnh triển khai thật.
Mã transfer learning nằm trong code/s7-23 (transfer.py, imagenet_infer.py, output.txt, requirements.txt); lấy dữ liệu bằng mkdir -p data && curl -L -o data/hymenoptera_data.zip https://download.pytorch.org/tutorial/hymenoptera_data.zip && unzip -q data/hymenoptera_data.zip -d data (đường dẫn lấy từ hướng dẫn Transfer Learning của PyTorch; dữ liệu chỉ dùng cho học tập, nghiên cứu), rồi chạy python transfer.py. Các con số là output thật trên máy Apple Silicon với GPU Metal, PyTorch 2.1.1, tập validation chỉ 153 ảnh nên chỉ dùng để so sánh tương đối chứ không phải benchmark.
Bài tiếp theo
Phát hiện đối tượng với YOLO: huấn luyện trên dữ liệu riêng. Sau transfer learning cho phân loại, ta mới chỉ biết "có gì trong ảnh". Bài sau tiến thêm một bước: tìm vị trí từng vật thể bằng hộp bao, và áp dụng đúng tư duy transfer learning, tinh chỉnh một mô hình YOLO đã huấn luyện sẵn trên bộ dữ liệu riêng.