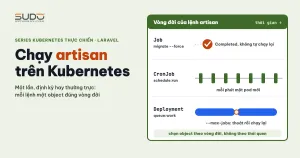
Chạy artisan trên Kubernetes khác hẳn chạy artisan trên VPS: không có một máy sống lâu để SSH vào gõ lệnh, không có crontab của hệ điều hành, và mỗi tiến trình phải thuộc về một object có vòng đời rõ ràng. Cách dễ nhất để chọn đúng object cho artisan trên Kubernetes là phân loại lệnh theo vòng đời: chạy một lần như migrate, chạy định kỳ như schedule:run, và chạy thường trực như queue:work. Bài này đi qua từng loại, chỉ ra chỗ initContainer hay bị hiểu sai, và nói rõ chỗ nào chúng tôi chưa kết luận được.
Nếu bạn chưa quen Pod, Deployment và manifest cơ bản, hãy xem trước bài Manifest Kubernetes đầu tiên. Image dùng trong bài là image Laravel đã được kiểm kê ở bài Kiểm kê image Laravel cho Kubernetes.
Ba loại tác vụ artisan trên Kubernetes
| Vòng đời | Ví dụ lệnh | Object phù hợp |
|---|---|---|
| Một lần | migrate --force | Job, restartPolicy: Never |
| Định kỳ | schedule:run | CronJob, tối thiểu một phút |
| Thường trực | queue:work | Deployment |
Với artisan trên Kubernetes, cả ba loại dùng chung image với web, chỉ khác lệnh khởi động. Chúng nên lấy biến môi trường từ cùng ConfigMap và Secret của site (xem ConfigMap và Secret cho Laravel), nếu không worker và web có thể nói chuyện với hai database khác nhau mà không ai nhận ra.
Chạy migrate: Job, initContainer và postStart
Khi chạy artisan trên Kubernetes lần đầu, lỗi đầu tiên thường là Base table or view not found: ứng dụng đã kết nối được database nhưng chưa có bảng. Có ba chỗ để chạy migrate, và đây là chỗ dễ bị làm sai nhất.
Job riêng
Với artisan trên Kubernetes, Job là lựa chọn rõ ràng nhất khi lệnh chỉ chạy một lần. Nhớ thêm --force: ở môi trường production Laravel hỏi xác nhận trước khi migrate, và pod không có terminal nên lệnh sẽ dừng ở câu hỏi đó.
apiVersion: batch/v1
kind: Job
metadata:
  name: migrate-v1
spec:
  backoffLimit: 0
  ttlSecondsAfterFinished: 3600
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: migrate
          image: registry.example.com/site-a:1.0
          workingDir: /var/www/html
          command: ["php", "artisan", "migrate", "--force"]
          envFrom:
            - configMapRef:
                name: site-a-config
            - secretRef:
                name: site-a-secret
Các manifest mẫu giả định mã nằm ở /var/www/html; nếu image đặt chỗ khác, hãy sửa workingDir hoặc WORKDIR, nếu không php artisan báo không thấy file.
Một lỗi hay gặp khi chép manifest là thụt lề sai, khiến envFrom nằm ngoài phần tử container. Tuỳ phiên bản kubectl, manifest bị từ chối hoặc trường bị bỏ qua, và container chạy không có biến môi trường nào. Hãy chạy kubectl apply --dry-run=server trước.
Khi Job còn tồn tại, apply lại sẽ không chạy lại, vì spec.template không sửa được. Mẫu trên có ttlSecondsAfterFinished, nên sau khi Job bị xoá, apply cùng tên sẽ tạo Job mới và chạy lại migrate. Vì vậy hãy đặt tên Job theo phiên bản, hoặc xoá Job cũ rồi apply có chủ đích. Với Helm, gắn annotation helm.sh/hook: pre-install,pre-upgrade (lần cài đầu cũng cần migrate) và helm.sh/hook-delete-policy: before-hook-creation vào Job.
initContainer
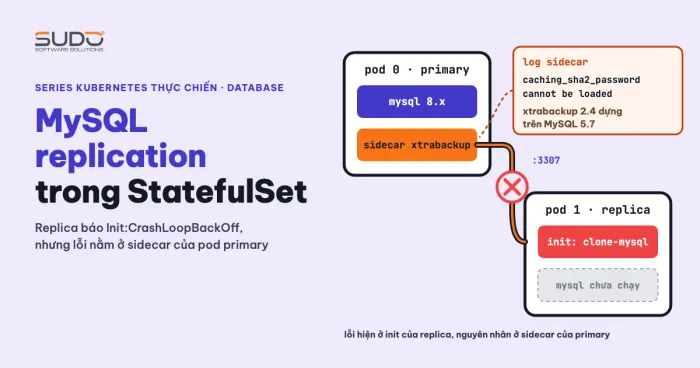
Init container chạy trong cùng Pod với container chính, tuần tự, và mỗi cái phải thoát thành công thì cái sau mới chạy. Hai hiểu nhầm cần tránh: nó không phải pod riêng, vì dùng chung mạng và volume với pod; và nó không tự chờ database sẵn sàng. Nếu migrate lỗi vì chưa kết nối được, pod hiện Init:Error rồi Init:CrashLoopBackOff.
postStart
Hook lifecycle.postStart chạy song song với ENTRYPOINT, và tài liệu Kubernetes không bảo đảm nó xong trước. Nó chạy lại mỗi lần container khởi động. Với migrate, đây là lựa chọn kém nhất: không có thứ tự, không có log riêng, và nhân lên theo số pod.
Vì sao initContainer không migrate được khi MySQL cùng pod
Một cách dựng thử hay gặp là đặt cả ứng dụng và MySQL vào một pod rồi dùng init container để migrate. Cách này luôn thất bại: mọi init container chạy xong rồi mới đến các container thường, trong đó có MySQL. Khi migrate chạy, MySQL chưa được khởi động nên kết nối bị từ chối.
Gốc vấn đề là thiết kế. Hai container phụ thuộc nhau về thời điểm thì không nên chung pod. Database nên là workload riêng với Service riêng, còn migrate chạy sau khi database sẵn sàng. Sidecar native (init container có restartPolicy: Always, yêu cầu Kubernetes 1.28 trở lên, bật mặc định từ 1.29) có thể giúp, nhưng chúng tôi chưa kiểm chứng cho trường hợp này.
Nhiều replica cùng chạy artisan trên Kubernetes
Nếu đặt migrate vào init container của Deployment nhiều replica, mỗi pod mới đều chạy migrate, và khi rolling update vài pod có thể chạy gần như đồng thời. Hai pod chạy đồng thời đều có thể thấy cùng một migration chưa áp dụng, nên cả migration đơn giản cũng có thể xung đột (ví dụ lỗi bảng đã tồn tại) và làm init container thoát lỗi; migration sửa dữ liệu còn rủi ro hơn. Hãy tự thử trên cluster thử. Laravel có migrate --isolated dùng khoá qua cache, nhưng cần driver cache dùng chung; chúng tôi chưa thử tuỳ chọn này. Ngoài ra, trong lúc rolling update, pod cũ vẫn chạy mã cũ trên schema đã đổi, nên migration cần tương thích ngược với phiên bản mã đang chạy. Cách an toàn hơn cho artisan trên Kubernetes là tách bước:
kubectl apply -f migrate-job.yaml
kubectl wait --for=condition=complete job/migrate-v2 --timeout=300s
kubectl rollout restart deployment/app
Lưu ý: khi chạy artisan trên Kubernetes bằng Job và Job thất bại, lệnh wait trên vẫn chờ đến hết --timeout rồi mới báo lỗi. Có thể chạy song song kubectl wait --for=condition=failed job/migrate-v2, hoặc xem kubectl logs job/migrate-v2 khi chờ quá lâu.
Scheduler: CronJob chạy schedule:run mỗi phút
Lịch của Laravel cần php artisan schedule:run được gọi mỗi phút, nên artisan trên Kubernetes cần một object chạy định kỳ. CronJob với lịch * * * * * làm đúng việc đó: mỗi phút một pod chạy vài giây rồi Completed.
apiVersion: batch/v1
kind: CronJob
metadata:
  name: schedule
spec:
  schedule: "* * * * *"
  concurrencyPolicy: Forbid
  startingDeadlineSeconds: 30
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 3
  jobTemplate:
    spec:
      backoffLimit: 1
      template:
        spec:
          restartPolicy: Never
          containers:
            - name: schedule
              image: registry.example.com/site-a:1.0
              workingDir: /var/www/html
              command: ["php", "artisan", "schedule:run"]
              resources:
                requests: { cpu: 50m, memory: 128Mi }
                limits: { memory: 256Mi }
concurrencyPolicy: Forbidngăn hai lần chạy chồng nhau.startingDeadlineSecondsgiới hạn việc chạy bù khi bỏ lỡ lịch.- Hai giới hạn history giữ vài pod gần nhất để xem log.
restartPolicy: NeverkèmbackoffLimitnhỏ: vớiOnFailure, cả lượtschedule:runbị chạy lại khi lỗi và có thể lặp các tác vụ có tác dụng phụ (gửi mail, ghi dữ liệu).- Đừng chuyển output sang
/dev/null, nếu khôngkubectl logskhông còn gì để đọc.
Cách khác là chạy crond và supervisord trong container web. Cách này không thêm object, nhưng cron nhân lên theo số replica và dùng chung giới hạn bộ nhớ với web. Chúng tôi chưa đo so sánh hai cách. Hãy chọn một cách và chỉ để scheduler chạy ở đúng một nơi.
Worker: Deployment chạy queue:work thường trực
Worker artisan trên Kubernetes là tiến trình thường trực nên dùng Deployment, tách khỏi pod web để scale độc lập. Hãy đặt giới hạn để tiến trình PHP dài hạn không phình bộ nhớ vô hạn.
command: ["php", "artisan", "queue:work", "--queue=default",
"--max-jobs=200", "--timeout=90", "--memory=256"]--max-jobs: worker thoát sau số job này và Kubernetes khởi động lại container. CộtRESTARTStăng dần là bình thường.--memory: tính bằng MB, chỉ kiểm tra sau khi xong một job.limits.memorycủa container nên lớn hơn mức này để worker tự thoát trước khi bị OOMKilled.--timeout: nên nhỏ hơnretry_aftercủa kết nối queue.
Đặt terminationGracePeriodSeconds lớn hơn --timeout để worker kịp xong job khi rollout. Xem thêm tài liệu Laravel Queues.
Pod Pending Insufficient cpu: request mặc định bằng limit
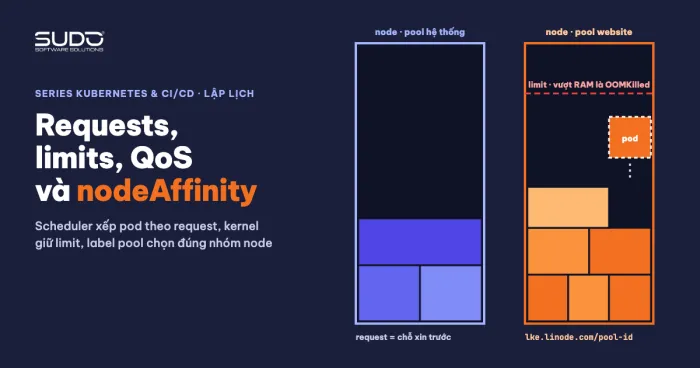
Khi chạy artisan trên Kubernetes trên cụm nhỏ và tổng requests CPU gần đầy, pod mới (web hoặc worker) kẹt Pending với sự kiện Insufficient cpu. Một yếu tố góp phần là manifest chỉ khai limits.cpu mà không khai requests.cpu: theo tài liệu Kubernetes, có limit mà thiếu request thì request được đặt bằng limit. Worker chỉ khai limit 500m bị scheduler tính cần 500m chỗ trống dù chỉ dùng vài chục m; hạ xuống 100m, hoặc đặt request thấp và limit cao, sẽ giải phóng chỗ cho pod khác. Để xác nhận, xem mục Requests trong kubectl describe pod và mục Allocated resources trong kubectl describe node. Cách đọc chỗ trống thật có trong bài Pod Pending vì Insufficient cpu.
Queue ngừng xử lý dù supervisor báo RUNNING: phương pháp chẩn đoán
Đây là phần chưa chốt được nguyên nhân của artisan trên Kubernetes bị treo. Tình huống: worker chạy dưới supervisord, supervisorctl status báo RUNNING, nhưng log worker dừng ở dòng RUNNING của một job và không có dòng DONE. Xoá job treo thì worker chạy lại. Cài thêm pcntl và tham số bộ nhớ vẫn không hết; nghi ngờ cuối cùng là mã job, chưa có bằng chứng. Điều nên giữ lại là phương pháp chẩn đoán:
- RUNNING của supervisor chỉ cho biết tiến trình còn sống. Xem
psđể biết trạng thái và tham số thật củaqueue:work. - Dòng
RUNNINGkhông cóDONEnghĩa là job chưa xong. Có thể do job gọi HTTP hoặc chờ khoá database mà không đặt timeout (giả thuyết, chưa xác nhận). - Kiểm tra
php -m | grep pcntl. Theo tài liệu Laravel, timeout của job cần extension này. Trường hợp trong nguồn đã càipcntlmà vẫn treo, nên đây chỉ là bước loại trừ chứ không phải nguyên nhân đã xác định. - Với driver database, xem cột
reserved_atcủa bảngjobsvà bảngfailed_jobs.
Checklist cho artisan trên Kubernetes
- Artisan trên Kubernetes cho migrate production: Job riêng hoặc hook Helm, có
--force, chờ xong rồi mới rollout. - Không dùng init container migrate khi database nằm cùng pod; migration phải tương thích ngược khi rolling update.
- CronJob có
concurrencyPolicy, history limit, resources và log ra stdout. - Worker artisan trên Kubernetes có
--max-jobs,--timeoutnhỏ hơnretry_after, grace period đủ dài,limits.memorylớn hơn--memory. - Khai
requestsriêng, đừng để request bằng limit. - Mọi lệnh artisan trên Kubernetes chạy đúng thư mục ứng dụng (
WORKDIRhoặcworkingDir).
Tài liệu gốc: CronJob và Init Containers. Tóm lại, artisan trên Kubernetes chạy tốt nhất khi mỗi lệnh có đúng một chủ sở hữu và một vòng đời rõ.
Bài tiếp theo
Lỗi 413 và 504 trên Kubernetes: giới hạn body, timeout và header ở nhiều lớp. Khi một lần import file lớn thất bại, bạn phải biết lớp nào trong chuỗi proxy đã chặn nó.