Bạn sửa prompt, đổi cách cắt chunk, thay mô hình embedding, và chatbot "có vẻ tốt hơn". Nhưng tốt hơn bao nhiêu, ở câu nào, và câu nào đang tệ đi mà bạn chưa thấy? Không có đánh giá RAG bài bản, mọi thay đổi chỉ là cảm giác. Bài này dựng quy trình đánh giá RAG gọn, chạy được trên laptop: bộ câu hỏi chuẩn (golden set), các chỉ số truy hồi tự cài đặt, kiểm tra độ trung thực bằng quy tắc và bằng LLM giám khảo, rồi chỉ ra chỗ chính các thước đo này đo sai.
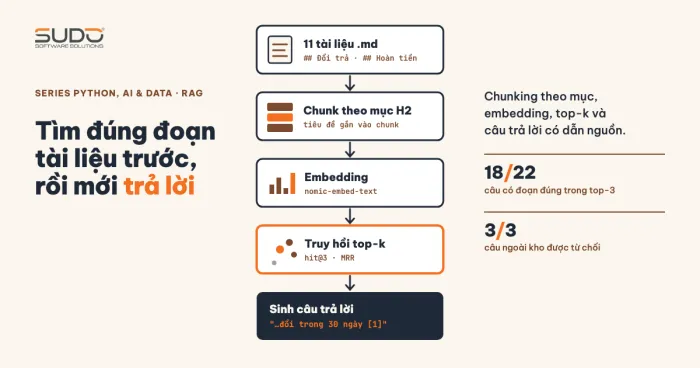
Bài dùng lại hệ thống ở Xây RAG bằng Python: chunking, truy hồi và sinh câu trả lời có dẫn nguồn và nối tiếp RAG nâng cao: hybrid search, reranking và viết lại câu hỏi: bài đó đã thêm nhiều kỹ thuật, bài này trả lời câu hỏi "kỹ thuật nào thật sự đáng giá" bằng đánh giá RAG có số liệu. Môi trường: Apple M4, 16 GB RAM, Python 3.12, SDK openai trỏ vào Ollama qua endpoint tương thích OpenAI http://localhost:11434/v1, mô hình qwen2.5:1.5b và nomic-embed-text; mã nằm trong code/s7-39.
Vì sao đánh giá RAG phải tách thành hai tầng
Một hệ thống RAG gồm hai bộ phận có thể hỏng độc lập: truy hồi (tìm đúng đoạn tài liệu) và sinh (dùng đoạn đó để trả lời đúng, không thêm thắt). Nếu chỉ chấm câu trả lời cuối, câu sai có thể do tìm trượt, do mô hình đọc sai đoạn đúng, hoặc do cả hai, và bạn sẽ sửa nhầm chỗ. Các tài liệu về đánh giá RAG đều chia theo hướng này. Bài báo Ragas: Automated Evaluation of Retrieval Augmented Generation (Es và cộng sự, 2023) nêu các chiều: truy hồi có tìm được đoạn liên quan và tập trung hay không, mô hình có dùng đoạn đó một cách trung thực hay không, và chất lượng của câu sinh ra. Bài báo ARES (Saad-Falcon và cộng sự, NAACL 2024) dùng ba chiều tương tự: context relevance, answer faithfulness và answer relevance.
| Tầng | Câu hỏi cần trả lời | Cần đáp án chuẩn? | Thước đo trong bài |
|---|---|---|---|
| Truy hồi | Đoạn đúng có nằm trong top-k không, ở hạng mấy? | Có: đoạn/mục vàng | hit@k, precision@k, recall@k, MRR, nDCG |
| Trung thực | Câu trả lời có khẳng định điều ngữ cảnh không nói? | Không | Kiểm số bằng quy tắc, LLM giám khảo |
| Đúng và đủ | Câu trả lời có chứa dữ kiện cần có? | Có: danh sách dữ kiện | Khớp dữ kiện, rà tay mẫu |
| Từ chối | Câu ngoài kho có được từ chối, không bịa? | Có: nhãn "ngoài kho" | Tỉ lệ từ chối đúng |
Lưu ý khi đánh giá RAG: trung thực (bám ngữ cảnh) khác với đúng (khớp sự thật). Một câu có thể bám sát đoạn đã lỗi thời và vẫn sai, nên đánh giá RAG cần cả hai loại thước đo.
Dựng bộ câu hỏi chuẩn (golden set) cho đánh giá RAG
Bộ câu hỏi chuẩn là tài sản quan trọng nhất của đánh giá RAG, hơn mọi framework. Mỗi mẫu gồm câu hỏi, loại câu (có đáp án hay ngoài kho), mục tài liệu vàng (tệp và tiêu đề mục chứa đáp án) và các dữ kiện bắt buộc có trong câu trả lời. Kho thử cho đánh giá RAG là 11 tài liệu chính sách của cửa hàng đồ gia dụng giả định từ bài RAG trước. Nguyên tắc dựng:
- Lấy câu hỏi thật từ ticket và chat; câu do mô hình sinh từ tài liệu thường trùng từ vựng và làm truy hồi trông tốt hơn thực tế.
- Có câu ngoài kho (khoảng 10 đến 20%) để kiểm tra khả năng từ chối.
- Gán nhãn bằng mục vàng thay vì nội dung chunk, để đổi cách cắt chunk mà không phải gán lại.
- Đóng băng và đánh số phiên bản trước khi tối ưu, tránh sửa bộ thử cho khớp hệ thống.
Bộ của bài gồm 25 câu từ bài RAG trước cộng 7 câu mới (make_golden.py; 25 câu cũ đã được chép sang questions.json cạnh script nên thư mục mã nguồn của bài chạy lại được một mình):
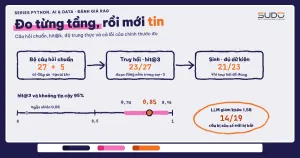
32 câu: 27 có đáp án trong kho, 5 ngoài kho
Chỉ số đánh giá RAG tầng truy hồi: tự cài đặt để hiểu từng con số
Các chỉ số đánh giá RAG ở tầng truy hồi đều tính từ một danh sách cờ nhị phân: chunk ở hạng i có liên quan hay không. Chúng ngắn đến mức nên tự viết thay vì phụ thuộc thư viện, và tự viết giúp bạn hiểu chính xác mình đang đo gì. Đây cũng là các thước đo quen thuộc từ bài Đánh giá mô hình phân loại: precision, recall, ROC và dữ liệu lệch, áp dụng cho bài toán xếp hạng.
def hit_at_k(rels, k):          # có chunk liên quan trong top-k?
    return float(any(rels[:k]))

def mrr(rels):                  # nghịch đảo hạng của chunk liên quan đầu tiên
    return next((1 / i for i, r in enumerate(rels, 1) if r), 0.0)
# precision@k = sum(rels[:k]) / k; nDCG@k = DCG / DCG lý tưởng (đủ bộ trong metrics.py)
Kiểm tra bằng tay với trường hợp chunk liên quan ở hạng 2 và hạng 4 (rels = [0, 1, 0, 1, 0]):
hit@1 0.0 hit@3 1.0
precision@3 0.333 MRR 0.5
nDCG@5 0.651
Đọc kết quả: hit@3 bằng 1 vì có chunk đúng trong 3 hạng đầu, MRR bằng 1/2 vì chunk đúng đầu tiên ở hạng 2. hit@k cho biết mô hình sinh có cơ hội nhìn thấy đoạn đúng không, nên là chỉ số chính của RAG khi k nhỏ; MRR và nDCG quan trọng khi thứ tự ảnh hưởng kết quả. Nếu mỗi câu chỉ có một mục vàng thì precision@3 không vượt khoảng 1/3 dù truy hồi hoàn hảo, nên đừng dùng nó làm chỉ số chính cho hỏi đáp.
Đánh giá RAG tầng truy hồi: so ba cấu hình và một đường cơ sở
Ta so ba cấu hình chunking trên 27 câu có đáp án: cắt cố định 400 ký tự, cắt theo mục H2 (tối đa 900 ký tự) và theo mục với ngưỡng 350. Chunk theo mục được tính liên quan khi đúng tệp và đúng mục vàng; chunk cố định khi nằm trong đúng tệp và chứa đủ dữ kiện, nên chênh lệch giữa hai kiểu chỉ là xu hướng. Thêm đường cơ sở ngẫu nhiên (xếp hạng ngẫu nhiên, lặp 200 lần) để biết con số có ý nghĩa không.
27 câu có đáp án
cấu hình               chunk   hit@1   hit@3     P@3     R@3     MRR  nDCG@5
fixed 400 ký tự           48   0.519   0.741   0.259   0.741   0.630   0.647
theo mục, ≤900            51   0.704   0.852   0.284   0.852   0.790   0.824
theo mục, ≤350            52   0.741   0.852   0.296   0.852   0.809   0.835
ngẫu nhiên (TB 200 lần)    51   0.017   0.063   0.021   0.063   0.045   0.059
Ba nhận xét. Trong đánh giá RAG, đường cơ sở ngẫu nhiên cho hit@3 khoảng 0,06 (xấp xỉ 3/51), nên 0,85 là tín hiệu thật. Precision@3 chỉ quanh 0,28 đến 0,30 đúng như đã nói. Ngưỡng 350 chỉ tạo thêm một chunk nên hit@1 tăng từ 0,704 lên 0,741 tương đương đúng thêm một câu (20/27 thay cho 19/27): đó là nhiễu, không phải cải thiện.
Đánh giá RAG với bộ nhỏ: khoảng tin cậy bằng bootstrap
Với 27 câu, mỗi câu đổi trạng thái làm hit@k dao động gần 4 điểm phần trăm. Bootstrap lấy mẫu có hoàn lại từ 27 cờ đúng/sai, tính lại tỉ lệ 2000 lần, lấy phân vị 2,5% và 97,5% (ci_and_k.py).
hit@3 = 0.852 trên 27 câu; khoảng tin cậy 95% (bootstrap) = [0.70, 0.96]
Khoảng [0,70; 0,96] rất rộng: chênh lệch vài điểm giữa hai cấu hình trong bộ này không phân biệt được với nhiễu. Muốn kết luận chắc trong đánh giá RAG cần vài trăm câu, hoặc so theo cặp trên cùng tập câu thay vì so hai tỉ lệ riêng.
Đánh giá RAG cả pipeline: truy hồi, dữ kiện, dẫn nguồn, từ chối
Đánh giá RAG toàn tuyến: chạy cả pipeline RAG của bài trước (top-3, chunk theo mục, trả JSON có answer và sources) trên 32 câu rồi chấm từng tầng riêng (eval_generation.py), để đổ lỗi đúng chỗ.
có đáp án (27 câu)
  truy hồi đúng mục trong top-3 : 23/27
  câu trả lời chứa đủ dữ kiện   : 21/27
    trong số truy hồi đúng      : 21/23
  từ chối nhầm                  : 1/27
  dẫn nguồn trúng mục đúng      : 21/27
  có số không có trong ngữ cảnh : 1/27
ngoài kho (5 câu)
  từ chối đúng                  : 5/5
  bịa số liệu                   : 0/5
Bốn câu trượt truy hồi (Q15, Q16, Q19, Q22) đều trả lời sai: khi đoạn đúng không có trong ngữ cảnh, mô hình nhỏ không tự biết đáp án. Phần còn lại là việc của tầng sinh: 21 trên 23 câu truy hồi đúng có đủ dữ kiện. Nhưng hai câu "sai" này cần soi kỹ vì chính thước đo đánh giá RAG cũng có lỗi.
Khi thước đo đánh giá RAG đo sai: soi từng ca
Log liệt kê các câu truy hồi đúng nhưng bị chấm thiếu dữ kiện, và các câu bị gắn cờ số lạ:
Câu trả lời sai dữ kiện dù truy hồi đúng:
 - Q06 Máy bị vào nước ở động cơ thì có được bảo hành không?
   -> Không
 - Q11 Đơn COD tối đa là bao nhiêu tiền?
   -> Đơn COD có giá trị từ 3.000.000 đồng trở lên cần xác nhận qua tin nhắn hoặc cuộc gọi trước khi kho xuất hàng.

Câu có số lạ:
 - Q26 ['4'] :: Đơn COD 4 triệu đồng cần xác nhận qua tin nhắn hoặc cuộc gọi trước khi kho xuất hàng.
- Q06 là dương tính giả của thước đo. Đáp án "Không" hoàn toàn đúng (tài liệu: vào nước ở phần động cơ thì bị từ chối bảo hành) nhưng dữ kiện tôi đặt là chuỗi "từ chối" nên bị chấm trượt. Khớp chuỗi dữ kiện nhạy với cách diễn đạt; phải rà tay các ca trượt trước khi tin con số.
- Q11 là lỗi sinh thật. Đoạn đúng có trong ngữ cảnh nhưng mô hình 1,5 tỉ tham số lấy nhầm câu "từ 3.000.000 đồng cần xác nhận" thay vì "tối đa 5.000.000 đồng". Câu trả lời trung thực (số 3.000.000 có trong ngữ cảnh) nhưng không đúng với câu hỏi. Kiểm số không bắt được lỗi này, và đây là lý do trung thực chưa đủ.
- Q26 là báo động giả của quy tắc kiểm số. Số "4" đến từ chính câu hỏi ("4 triệu"), không có trong tài liệu nên bị gắn cờ, dù câu trả lời đúng. Quy tắc cần bỏ qua số lặp lại từ câu hỏi, hoặc chuẩn hoá "4 triệu" thành 4.000.000.
Sau rà tay, kết quả đánh giá RAG thật là 22/27 đúng thay vì 21/27: bốn câu sai do truy hồi, một câu sai do sinh (Q11). Bài học: con số tự động chỉ là điểm xuất phát, và mỗi lần đổi hệ thống nên rà tay toàn bộ các ca đổi trạng thái, không chỉ nhìn tổng.
Dẫn nguồn cũng cần đo riêng: 21/27 trúng mục đúng, trong đó 4 câu trượt vì truy hồi, còn Q03 và Q26 trả lời đúng nhưng mô hình ghi sources: [2] trong khi đoạn đúng là đoạn [1]. Người đọc bấm vào nguồn mà không thấy gì khớp là lỗi nguy hiểm, nên hãy đo độ chính xác trích dẫn như một chỉ số riêng.
Đánh giá RAG tầng sinh: độ trung thực bằng quy tắc và LLM giám khảo
Trong đánh giá RAG kiểu Ragas, faithfulness được tính bằng cách tách câu trả lời thành các khẳng định, kiểm tra từng khẳng định có suy ra được từ ngữ cảnh không, rồi lấy số khẳng định được ủng hộ chia cho tổng số khẳng định (tài liệu Ragas về Faithfulness). Bước kiểm tra do một LLM làm. Ta cài đặt đúng ý tưởng này với giám khảo qwen2.5:1.5b chạy local (judge.py), và đặt cạnh một quy tắc rẻ hơn nhiều (grounding.py): mọi con số trong câu trả lời phải có trong ngữ cảnh.
Câu hỏi quan trọng nhất về bất kỳ giám khảo nào: nó có bắt được lỗi thật không? Cần dữ liệu có nhãn biết trước: lấy 20 câu trả lời đã rà tay là đúng, rồi tạo bản "tiêm lỗi" bằng cách nhân đôi con số đầu tiên và cộng 3 ("7 ngày" thành "17 ngày"). Tổng 39 mẫu, đưa cho giám khảo và cho quy tắc kiểm số:
tập hiệu chuẩn: 39 câu (20 trung thực, 19 bị sửa số)
giám khảo qwen2.5:1.5b : nhận đúng câu trung thực 20/20, bắt được câu bị sửa số 14/19
độ chính xác tổng      : 0.87
quy tắc kiểm số        : độ chính xác 0.97

Ví dụ giám khảo sai:
 - Q01 nhãn=bị sửa giám khảo=CÓ :: Khách hàng được đổi hoặc trả sản phẩm trong vòng 17 ngày kể từ ngày nhận hàng nếu sản phẩm còn nguyên tem, hộp và phụ kiện, chưa qua sử dụng.
 - Q02 nhãn=bị sửa giám khảo=CÓ :: 60003 đồng cho mỗi đơn đổi trả.
 - Q13 nhãn=bị sửa giám khảo=CÓ :: Đơn từ 6000003 đồng
 - Q17 nhãn=bị sửa giám khảo=CÓ :: 5 phần gạo và 1,8 phần nước
Hai điều rút ra. Giám khảo 1,5 tỉ tham số không bỏ sót câu trung thực nhưng để lọt 5 trên 19 câu bị sửa số (khoảng 26%): nó dễ "gật" khi khẳng định gần giống ngữ cảnh. Trong đánh giá RAG này, quy tắc kiểm số đạt 0,97, chỉ sót Q17 vì số bị sửa ("5") tình cờ cũng có chỗ khác trong ngữ cảnh. Nhưng quy tắc không phát hiện lỗi "đúng số nhưng sai đối tượng" như Q11, và lỗi tiêm là loại dễ nhất, nên 0,97 là cận trên.
Với đánh giá RAG bằng LLM, giám khảo mạnh hơn cũng có thiên lệch riêng. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (Zheng và cộng sự, NeurIPS 2023) ghi nhận thiên lệch vị trí, thiên lệch độ dài và thiên lệch tự ưu ái câu do chính mô hình đó sinh, đồng thời báo cáo GPT-4 đồng thuận với người trên 80%. Hệ quả: hiệu chuẩn giám khảo bằng tập có nhãn của chính bạn, dùng mô hình khác với mô hình sinh, và giữ một mẫu nhỏ cho người kiểm. ARES dùng một lượng nhỏ nhãn người để hiệu chỉnh sai số giám khảo (prediction-powered inference).
Đánh giá RAG với câu ngoài kho: khả năng từ chối
Với 5 câu ngoài kho (iPhone, giá một mã hàng không có trong tài liệu, tuyển dụng, giao sang Lào, máy lọc không khí), hệ thống từ chối đúng 5/5 và không bịa số. Nhưng bộ này rất nhỏ, và điểm cosine của câu ngoài kho (0,762 đến 0,812) nằm lẫn trong dải câu trong kho (0,730 đến 0,839) như bài trước đã cảnh báo, nên sự từ chối đến từ prompt chứ không từ ngưỡng điểm. Cũng đo lỗi ngược lại: từ chối nhầm (1/27 câu có đáp án), vì hệ thống từ chối quá tay trông an toàn nhưng vô dụng.
Lưu ý thước đo này khớp đúng chuỗi từ chối cố định trong mã, nên số 1/27 là cận dưới: Q15 và Q16 (truy hồi trượt) mô hình trả lời "Không có thông tin ..." bằng cách diễn đạt khác, thực chất là từ chối nhầm nhưng không được đếm. Tính cả hai câu này thì từ chối nhầm ít nhất là 3/27.
Quy trình đánh giá RAG trong dự án thực tế
- Đóng băng golden set của đánh giá RAG (30 đến 50 câu để bắt đầu, vài trăm khi hệ thống ổn), lưu trong Git cùng mã.
- Chạy đánh giá RAG tự động mỗi khi đổi chunking, embedding, prompt hoặc mô hình, rồi so bảng với lần trước.
- Báo cáo theo tầng: hit@k, MRR cho truy hồi; trung thực, đủ dữ kiện, trích dẫn cho sinh; từ chối đúng và nhầm cho ngoài kho.
- Rà tay các ca đổi trạng thái giữa hai lần đánh giá RAG; sửa thước đo nếu nó sai trước khi sửa hệ thống.
- Thêm câu mới từ lỗi thật của người dùng, nhưng giữ riêng một tập kiểm chưa dùng để tối ưu.
Giới hạn của quy trình đánh giá RAG trong bài
- 27 câu có đáp án là quá nhỏ (khoảng tin cậy hit@3 rộng 26 điểm), mỗi câu chỉ một mục vàng nên chưa đo được câu cần ghép nhiều đoạn.
- Câu hỏi do người soạn kho tự viết nên trùng từ vựng với tài liệu; câu của khách thật mơ hồ hơn, số thật sẽ thấp hơn.
- Giám khảo 1,5 tỉ tham số chỉ minh hoạ phương pháp: bắt 14/19 lỗi tiêm chưa đủ làm cổng chặn triển khai.
- Giám khảo trùng với mô hình sinh: do giới hạn tài nguyên chỉ có một mô hình chat (qwen2.5:1.5b) nên giám khảo và mô hình sinh là một, trái với lời khuyên ở trên; thiên lệch tự ưu ái có thể làm lệch các số 20/20 và 14/19.
- Thước đo từ chối khớp chuỗi cố định nên bỏ sót các câu từ chối diễn đạt khác (Q15, Q16), như đã nêu ở mục câu ngoài kho.
- Mọi lệnh đánh giá RAG đã chạy thật bằng mô hình local, không có số liệu từ API thương mại.
Checklist đánh giá RAG
- Có golden set gán nhãn bằng mục vàng và dữ kiện, gồm cả câu ngoài kho.
- Đánh giá RAG tách tầng: truy hồi (hit@k, MRR) riêng, sinh (đủ dữ kiện, trung thực, trích dẫn) riêng.
- So với đường cơ sở ngẫu nhiên và kèm khoảng tin cậy trước khi kết luận.
- Hiệu chuẩn mọi giám khảo bằng mẫu tiêm lỗi; rà tay các ca đổi trạng thái.
- Báo cáo song song từ chối đúng và từ chối nhầm.
Mã nguồn: make_golden.py, metrics.py, eval_retrieval.py, eval_generation.py, grounding.py, judge.py, ci_and_k.py, cùng golden.json và các tệp *_output.txt. Số liệu là output thật trên Apple M4, 16 GB, temperature=0, seed=7; Ollama khác phiên bản có thể lệch vài câu.
Bài tiếp theo
Trích xuất dữ liệu có cấu trúc từ HTML bằng LLM và Pydantic. Bài sau chuyển từ hỏi đáp sang biến văn bản lộn xộn thành bản ghi có kiểu, kiểm tra bằng Pydantic, và dùng lại tư duy đánh giá RAG hôm nay: có bộ mẫu chuẩn, đo từng trường và đo cả lỗi của thước đo.