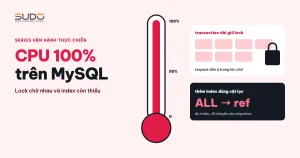
Một máy database nhỏ dùng chung cho vài website, trong đó có một ứng dụng quản lý bán hàng. Đầu giờ làm việc, nhân viên mở trang đơn hàng thì quay mãi không xong, còn máy database chạy CPU 100% liền mấy phút. Không có bot, không có job nặng, chỉ là vài người dùng thao tác bình thường. Tài liệu này mô tả tình huống điển hình đó và quy trình xử lý: cách tách phần do lock chờ nhau khỏi phần do truy vấn đọc quá nhiều dòng, các câu lệnh Performance Schema cần dùng, và cách thêm index trên production mà không làm schema lệch khỏi code.
Triệu chứng thường gặp
- Máy database báo CPU 100% theo từng đợt vài phút, thường rơi vào giờ cao điểm của một ứng dụng nghiệp vụ.
- Một vài trang (danh sách đơn hàng, báo cáo, tìm khách hàng) chậm rõ rệt; các website khác trên cùng máy chậm theo.
- Máy cấu hình nhỏ: ít vCPU,
innodb_buffer_pool_sizeđể mặc định hoặc rất thấp, slow query log tắt. - Lưu lượng vào ứng dụng không bất thường. Đây là điểm khiến nhiều người đoán sai nguyên nhân.
Quy trình điều tra CPU 100% theo từng tầng
Bước 1: loại trừ tác nhân bên ngoài gây CPU 100%
Việc đầu tiên là xem trong khung giờ CPU 100% có tác vụ định kỳ nào chạm vào database không: backup, export, đồng bộ dữ liệu, cron báo cáo. Đây là nghi phạm quen thuộc nhất và cũng dễ loại trừ nhất, chỉ cần đối chiếu lịch chạy với biểu đồ CPU.
Tiếp theo, đọc access log ở balancer phía trước ứng dụng trong đúng khung giờ đó. Đếm request theo đường dẫn và theo IP:
awk '{print $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head -10
Nếu request chỉ đến từ vài IP văn phòng, phân bố đều trên các trang nghiệp vụ, thì đây là lưu lượng bình thường. Khi đó nguyên nhân CPU 100% nằm ở cách ứng dụng dùng database, không phải ở tải.
Bước 2: đọc code tìm transaction dài
Mẫu hình hay gặp trong ứng dụng bán hàng viết bằng Laravel: một hàm tạo hoá đơn mở transaction rồi ghi lần lượt vào nhiều bảng, xen giữa là các bước đọc lại và tính toán.
DB::beginTransaction()
  ├── cập nhật khách hàng          (customers)
  ├── thêm hoá đơn                 (invoices)
  ├── thêm thanh toán              (invoice_payments)
  ├── thêm chi tiết hoá đơn        (invoice_details)
  ├── đọc lại hoá đơn, cộng tổng thanh toán
  └── ... cập nhật kho, số điện thoại ...
DB::commit()
Theo tài liệu về khoá trong InnoDB, các dòng đã ghi trong transaction giữ khoá tới khi commit. Transaction càng dài, người thứ hai thao tác cùng khách hàng hoặc cùng hoá đơn càng phải chờ lâu.
Bước 3: Performance Schema khi CPU 100% mà slow query log tắt
Khi không có slow query log, nguồn dữ liệu tốt nhất là các bảng tổng hợp của Performance Schema. Trước hết, xác định số liệu đang được tính từ lúc nào:
SHOW GLOBAL STATUS LIKE 'Uptime'; -- giây kể từ lần khởi động MySQL gần nhấtPerformance Schema đếm lại từ đầu mỗi khi MySQL khởi động lại, không theo uptime của hệ điều hành. Nhầm hai con số này là lỗi hay gặp khi viết báo cáo về CPU 100%.
Sau đó lấy hai góc nhìn. Góc thứ nhất: thời gian lâu nhất của COMMIT và ROLLBACK, dấu hiệu của transaction chờ khoá.
SELECT DIGEST_TEXT, COUNT_STAR,
       ROUND(SUM_TIMER_WAIT/1e12, 2) AS total_s,
       ROUND(MAX_TIMER_WAIT/1e12, 2) AS max_s
FROM performance_schema.events_statements_summary_by_digest
WHERE DIGEST_TEXT IN ('COMMIT', 'ROLLBACK')
ORDER BY MAX_TIMER_WAIT DESC;
Một lệnh COMMIT bình thường chỉ mất vài mili giây. Nếu giá trị lớn nhất lên tới hàng giây, gần như chắc chắn có transaction phải xếp hàng chờ nhau.
Góc thứ hai: số dòng phải đọc của từng mẫu truy vấn, dấu hiệu của thiếu index.
SELECT LEFT(DIGEST_TEXT, 120) AS query, COUNT_STAR,
       SUM_ROWS_EXAMINED, SUM_ROWS_SENT,
       SUM_NO_INDEX_USED, ROUND(MAX_TIMER_WAIT/1e12, 2) AS max_s
FROM performance_schema.events_statements_summary_by_digest
ORDER BY SUM_ROWS_EXAMINED DESC
LIMIT 15;

-- bảng bị quét toàn bộ nhiều nhất
SELECT * FROM sys.schema_tables_with_full_table_scans LIMIT 10;
Tỉ lệ SUM_ROWS_EXAMINED / SUM_ROWS_SENT càng lớn, truy vấn càng lãng phí. Lưu ý mysqldump của job backup cũng đọc toàn bộ bảng, nên cần tách phần đó ra trước khi kết luận.
Nếu đang trong lúc sự cố, xem trực tiếp ai đang giữ khoá:
SELECT * FROM sys.innodb_lock_waits\G
SELECT trx_id, trx_started, trx_rows_locked, trx_query
FROM information_schema.INNODB_TRX ORDER BY trx_started;
Nguyên nhân gốc: hai cơ chế khuếch đại nhau
Kết luận "nhân viên thao tác đồng loạt, transaction tranh row lock, COMMIT nghẽn" thường đúng nhưng chưa đủ. Nên tách nó thành hai cơ chế, vì cách sửa khác nhau:
- Lock chờ nhau làm request dồn ứ. Transaction dài giữ khoá, request sau phải xếp hàng. Bản thân việc chờ khoá không đốt CPU, nhưng nó làm số câu lệnh chạy đồng thời tăng lên và giữ kết nối lâu hơn.
- Đọc quá nhiều dòng mới là thứ gây CPU 100%. Truy vấn lọc theo những cột như
created_at,phone,type_idmà không có index phải quét hàng trăm nghìn tới hàng triệu dòng. Buffer pool nhỏ khiến nhiều trang phải đọc lại từ đĩa. Trên máy ít vCPU, vài câu như vậy chạy cùng lúc là đủ kín CPU.
Hai cơ chế nuôi nhau: quét chậm làm transaction dài, transaction dài làm request khác chờ, request chờ lại chồng thêm câu quét. Vì vậy chỉ vài người dùng cũng đủ đẩy máy lên CPU 100%.
Khắc phục CPU 100%
Thêm index: đo trước, rồi mới chốt
Thêm index trên bảng hàng triệu dòng giữa giờ làm việc cũng là một thao tác tốn tài nguyên. Làm sai cách, chính thao tác chữa CPU 100% lại gây ra một đợt CPU 100% mới. Quy trình chúng tôi khuyến nghị:
- Chọn truy vấn cần tối ưu từ Performance Schema, chạy
EXPLAINđể ghi lại kế hoạch hiện tại. - Tạo index thử ngoài giờ cao điểm, dùng online DDL để không khoá bảng:
ALTER TABLE invoices ADD INDEX idx_created_at (created_at), ALGORITHM=INPLACE, LOCK=NONE; - Đo lại: một truy vấn đơn lẻ và một đợt truy vấn đồng thời. So
EXPLAINtrước và sau. - DROP index thử, đưa production về trạng thái ban đầu.
- Viết index thành migration của dự án và triển khai theo quy trình bình thường.
Kết quả EXPLAIN cần nhìn là cột type chuyển từ ALL (quét toàn bảng) sang ref hoặc range, và cột rows giảm mạnh:
EXPLAIN, trước → sau
products          ALL              → ref   idx_locale_status_order
product_variants  ALL (hash join)  → ref   idx_product_id
comments          ALL              → range idx_type_typeid_parent_status
Thay đổi lớn nhất thường đến từ index trên cột khoá ngoại dùng để join: MySQL chuyển từ hash join quét toàn bảng sang tra theo index. Khi đo đồng thời, mức cải thiện có thể lên tới hàng trăm lần, nhưng đó là do nhiều câu có kế hoạch kém cùng tranh một máy nhỏ đang CPU 100%, đừng mang tỉ lệ ấy đi hứa cho site khác. Còn LIKE '%từ khoá%' thì index B-tree không giúp được.
Migration mẫu sau khi đã đo:
// database/migrations/xxxx_xx_xx_add_performance_indexes.php (rút gọn)
Schema::table('comments', function (Blueprint $table) {
    $table->index(['type', 'type_id', 'parent_id', 'status'], 'idx_type_typeid_parent_status');
});
Schema::table('product_variants', function (Blueprint $table) {
    $table->index('product_id', 'idx_product_id');
});
Schema::table('products', function (Blueprint $table) {
    $table->index(['locale', 'status', 'order'], 'idx_locale_status_order');
    $table->fullText(['name', 'search'], 'ft_name_search');
});
Vì sao không giữ luôn index đã tạo tay? Lần sau dự án dựng lại database từ migration (môi trường mới, khôi phục từ backup cấu trúc, chuyển máy), index tạo tay sẽ biến mất mà không ai biết. Schema phải có một nguồn sự thật duy nhất là code.
Nếu muốn đổi tìm kiếm từ LIKE sang MATCH ... AGAINST, với tiếng Việt cần cân nhắc parser ngram hoặc độ dài token tối thiểu. Kết quả tìm kiếm sẽ khác so với LIKE, nên phải test trước khi đổi code.
Rút ngắn transaction để giảm CPU 100%
- Đưa các bước chỉ đọc và tính toán ra ngoài transaction. Chỉ mở transaction quanh đúng các lệnh ghi phải đi cùng nhau.
- Không gọi API bên ngoài, gửi mail hay ghi file bên trong transaction.
- Ghi theo một thứ tự bảng cố định ở mọi chỗ để giảm cả chờ khoá lẫn deadlock.
Tài nguyên và lịch chạy
- Nếu ứng dụng tiếp tục tăng người dùng, nâng máy lên 2–4 vCPU hoặc tách ứng dụng nặng ra máy riêng, để một đợt CPU 100% không kéo theo các site khác.
- Không chạy export database trong giờ làm việc.
mysqldump --single-transactionkhông khoá bảng InnoDB, nhưng vẫn đọc toàn bộ bảng và tranh buffer pool với ứng dụng.
Lỗi thường gặp khi xử lý CPU 100% trên MySQL
- Chỉ sửa một phía. Thêm index mà không rút ngắn transaction, hoặc ngược lại, chỉ giảm được một nửa vấn đề.
- Đọc nhầm khoảng thời gian của số liệu. Lấy uptime hệ điều hành thay cho
Uptimecủa MySQL. - Tin vào cấu hình ghi trong báo cáo. Số vCPU, RAM phải kiểm tra lại trên máy thật bằng
nproc,free -h. - Bật slow query log bằng
SET GLOBALrồi quên. Lần restart sau cấu hình mất. - Giữ index tạo tay trên production. Schema lệch khỏi migration, lần dựng lại sau mất index.
Checklist phòng ngừa CPU 100% trên database
- Bật slow query log trên các máy database dùng chung, ví dụ
long_query_time = 2, ghi vàomysqld.cnfđể còn sau lần restart. - Khi gặp CPU 100%, xem cả hai phía: thời gian COMMIT/ROLLBACK lâu nhất và rows examined theo truy vấn.
- Kiểm tra
Uptimecủa MySQL trước khi gọi một con số là "tích luỹ". - Index thử trên production phải có kế hoạch DROP và migration đi kèm ngay từ đầu.
- Lịch backup và export tránh giờ cao điểm của từng ứng dụng, xem thêm bài backup database hằng đêm bằng mysqldump và rclone.
Bài học
- CPU 100% hiếm khi chỉ có một nguyên nhân. Lock chờ nhau giải thích vì sao request dồn ứ, thiếu index giải thích vì sao CPU bị đốt.
- Vài người dùng cũng đủ gây CPU 100%. Với transaction dài và truy vấn quét toàn bảng, không cần bot hay tải lớn để làm kín một máy nhỏ.
- Đo index trước khi thêm, và thêm bằng migration. Như bài MySQL 8.4 chọn sai kế hoạch với điều kiện <>, có index đúng cột chưa đủ, phải nhìn kế hoạch thật.
Bài tiếp theo
Octane OOM: khi một tiến trình kéo sập cả minion. Một worker FrankenPHP hết bộ nhớ và kéo theo cả những site không liên quan trên cùng minion.